ד.11 — למידת חיזוק עמוקה
המצגת: DQN · השיעור באתר הקורס · קוד: DQN_Trainer.py במאגר Tic_Tac_Toe_DQN · מאגר Tic_Tac_Toe_DQN
עד עכשיו כל הסוכנים שבנינו שמרו את מה שלמדו בטבלה: לכל מצב, או לכל זוג מצב ופעולה, תא משלו ובתא מספר. באיקס עיגול זה עבד יפה, כי מספר הלוחות האפשריים קטן, ואפילו טבלת AfterState מהפרק הקודם הסתפקה באלפי רשומות. אבל נסו לדמיין את אותה טבלה למשחק שחמט, או למכונית אוטונומית שמצבה מתואר במהירויות ובמרחקים רציפים. שם אין טבלה שתספיק, ורוב המצבים לעולם לא ייפגשו פעמיים.
למידת חיזוק עמוקה פותרת את הבעיה בכך שהיא מחליפה את הטבלה ברשת נוירונים. במקום לשמור כל ערך בתא נפרד, הרשת מחשבת אותו. כאן נפגשים שני חלקי הספר: בחלק ג למדנו שרשת נוירונים היא פונקציה עם משקלים, שמאמנים אותה להתאים קלט לפלט ושהיא יודעת להכליל לקלטים שלא ראתה. בחלק ד למדנו איך לבנות יעד למידה מתגמול ומהערכת ההמשך. Deep Q-Network — DQN מחבר את השניים.
בפרק זה נלמד את האלגוריתם כפי שפורסם על ידי צוות החוקרים של Google DeepMind. הצוות, בראשות Volodymyr Mnih, הציג את DQN לראשונה במאמר משנת 2013, והרחיב אותו למאמר המלא שפורסם בכתב העת Nature בשנת 2015. במאמרים אלה למד סוכן אחד, עם אותה רשת ואותו אלגוריתם, לשחק עשרות משחקי Atari כשהקלט היחיד שלו הוא תמונות המסך, ובחלק מהמשחקים הגיע לרמה של שחקן אנושי מקצועי. נלך בעקבות המאמר צעד אחר צעד, ונבין מדוע כל רכיב בו נחוץ:
- Playing Atari with Deep Reinforcement Learning, V. Mnih, K. Kavukcuoglu, D. Silver ואחרים, NIPS Deep Learning Workshop, 2013.
- Human-level Control Through Deep Reinforcement Learning, V. Mnih, K. Kavukcuoglu, D. Silver ואחרים, Nature 518, 529–533, 2015.
החיסרון בטבלאות ערכים
כל הפתרונות שראינו עד כה, מ־Policy Iteration ועד Q-learning, נשענו על מבנה נתונים שהחזיק את הערכים: טבלת V או טבלת Q, ובה רשומה לכל מצב, או לכל זוג מצב ופעולה, בסביבה. במקרים רבים מספר המצבים האפשריים גדול כל כך שאין אפשרות מעשית לשמור את כולם בזיכרון המחשב, ולעיתים הוא אין־סופי:
| מספר המצבים | המשחק או הסביבה |
|---|---|
| 1020 | דמקה |
| כ־1040 | שחמט |
| 10170 | Go |
| אין־סופי | רכב אוטונומי |
ויש קושי שני, גם אם היה מקום לכולם: הזמן הדרוש כדי לעדכן מיליארדי רשומות, שוב ושוב עד להתכנסות, עצום ואינו מעשי. בשני המקרים הבעיה אינה בקוד שכתבנו אלא במבנה הנתונים עצמו.
הפתרון — רשת נוירונים במקום טבלה
טבלת ערכים היא למעשה פונקציה: מכניסים מצב ומקבלים מספר, V(s), או מכניסים מצב ופעולה ומקבלים מספר, Q(s,a). באלגוריתמים שלמדנו עדכנו את ערכי הטבלה בכל פעם "בכיוון הטעות", למשל בעדכון TD של פרק ד.9:
התחלנו מערכים אקראיים וביצענו עדכונים חוזרים ונשנים, עד שהערכים התייצבו והטעות נעשתה קטנה. זה דומה מאוד לאימון רשת נוירונים: גם שם מתחילים ממשקלים אקראיים, ובאמצעות עדכונים חוזרים מזיזים את המשקלים לכיוון המינימום של הטעות. ההבדל הוא שברשת אין תא לכל מצב. יש קבוצה אחת של משקלים, שמשמשת לחישוב הערך של כל מצב. לכן רשת יכולה לייצג פונקציית ערך גם על מרחב מצבים ענק, ואפילו רציף, בלי לשמור רשומה לכל מצב.
רשת נוירונים בלמידת חיזוק
באימון רשת בלמידה מפוקחת עבדנו לפי תבנית קבועה, שנשארת כאן כמות שהיא:
- מקבלים זוגות של נתונים: קלט X ותוצאה Y, שהיא המטרה.
- מבצעים חלחול קדימה ומחשבים את התוצאה המשוערת ŷ = Model(X).
- מחשבים את הטעות loss = (ŷ − y)².
- מבצעים חלחול לאחור כדי לחשב את הנגזרות של פונקציית הטעות.
- מעדכנים את הפרמטרים של הרשת לפי הטעות, באלגוריתם SGD.
בלמידת חיזוק נשתמש באותו אלגוריתם, ונחליף את הטבלה V ברשת נוירונים. נסמן את פלט הרשת ב־V̂(s;w), כאשר w הם משקלי הרשת, והסימון ;w מזכיר שהערך אינו נשלף מטבלה אלא מחושב, ושהוא תלוי במשקלים הנוכחיים. נוסחת העדכון נראית כמעט אותו דבר, אלא שכל הערכים מגיעים עכשיו מהרשת:
הביטוי באדום הוא בדיוק המטרה שחסרה לנו כדי למלא את התבנית של הלמידה המפוקחת. את שלושת הרכיבים של התבנית, קלט, תחזית ומטרה, אפשר עכשיו למלא גם לפונקציית V וגם לפונקציית Q:
| פונקציית Q | פונקציית V | |
|---|---|---|
| (S, A) | S | הקלט X |
| Q̂(S,A;w) | V̂(S;w) | התוצאה המשוערת ŷ |
| R + γ·Q̂(S′,A′;w) | R + γ·V̂(S′;w) | המטרה y |
ההבדל היחיד מלמידה מפוקחת הוא מקור המטרה. אין לנו מראש תווית שאומרת מהו הערך הנכון של כל מצב; את המטרה בונים מהתגמול שהתקבל ומהערכת ההמשך, בדיוק כמו בעדכון TD. הסוכן מייצר לעצמו את ה"תוויות" תוך כדי משחק.
סוגי רשתות נוירונים
נשתמש באלגוריתם Q-learning ונחליף את טבלת Q ברשת נוירונים, שהיא פונקציה. במקום לעדכן ערכים של V או Q בטבלה, נעדכן את הפרמטרים של הרשת. לפני כן צריך להחליט מה בדיוק הרשת מקבלת ומה היא מחזירה, ויש לכך שלוש צורות:
| שימוש | פלט | קלט |
|---|---|---|
| קירוב פונקציית הערך של המצב | ערך יחיד v̂(s;w) | מצב, או AfterState |
| מחשבים ציון לכל פעולה מועמדת | ערך Q יחיד q̂(s,a;w) | מצב ופעולה |
| כל הפעולות במעבר יחיד | ערך Q לכל פעולה, q̂(s,a₁;w) … q̂(s,aₘ;w) | מצב בלבד |
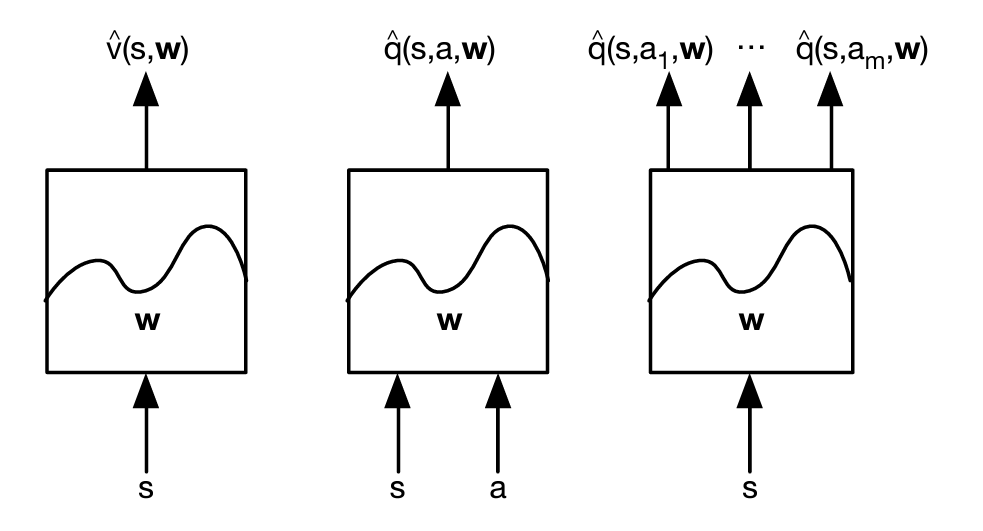
הצורה השלישית היא הנפוצה בספרות: הרשת מחזירה ערך לכל פעולה במעבר יחיד. בהדגמה באיקס עיגול, בפרק הבא, נבחר דווקא בצורה השנייה: מצב ופעולה בקלט ומספר אחד בפלט. בכל מצב נריץ את הרשת על כל הפעולות החוקיות ונבחר את זו שקיבלה את הערך הגבוה ביותר. הבחירה הזאת נוחה במשחק שבו קבוצת הפעולות החוקיות משתנה ממצב למצב, כי מעריכים רק פעולות חוקיות.
נקודת המוצא — Q-learning
נפתח את האלגוריתם בשלבים, מתוך Q-learning עם טבלת Q כפי שלמדנו בפרק ד.9. נזכיר את שלבי האלגוריתם כפי שלמדנו אותם:
- מאתחלים את טבלת Q, ובתחילת כל אפיזודה מקבלים את המצב ההתחלתי S.
- בוחרים פעולה A לפי ε-greedy: לרוב את הפעולה בעלת הערך הגבוה ביותר בשורה של S בטבלה, ולעיתים, בהסתברות ε, פעולה אקראית.
- משחקים ומקבלים מהסביבה את S′ ו־R.
- בונים את היעד: אם S′ הוא מצב סופי, היעד הוא R בלבד; אחרת R + γ·max Q(S′,a), כאשר המקסימום הוא על הפעולות החוקיות במצב S′, לפי טבלת Q בלבד ובלי ε.
- מעדכנים את הטבלה: Q(S,A) ← Q(S,A) + α·(target − Q(S,A)).
- עוברים למצב הבא, S ← S′, וחוזרים לשלב 2 עד שמגיעים למצב סופי.
הפסאודו־קוד מאותו פרק הוא נקודת המוצא שלנו, ובכל שלב בהמשך נסמן באדום רק את השורות שהשתנו:
Initialize Q
For each episode:
    Initialize S
    Repeat:
        Choose A using epsilon-greedy
        Perform A and observe R, S'
        If S' is terminal:
            target = R
        Else:
            target = R + gamma * max Q(S', legal action)
        Q(S, A) += alpha * (target - Q(S, A))
        S = S'
    Until S is terminal
הפרט מאותו פרק שחשוב במיוחד לכאן הוא שלב 4: הסוכן בוחר את הפעולה שהוא מבצע בפועל לפי ε-greedy, אבל הפעולה הבאה שנכנסת ליעד נבחרת לפי טבלת Q בלבד, בלי ε, כלומר לפי הערך המרבי max Q(S′,a). זו התכונה שהופכת את Q-learning ל־off-policy, ובהמשך הפרק נראה למה היא הכרחית לנו.
שלב ראשון — מחליפים את הטבלה בפונקציה
כזכור, רשת נוירונים היא פונקציה שמקבלת קלט ומחזירה פלט באמצעות פרמטרים w, שאותם מעדכנים תוך כדי האימון. נסמן את פונקציית הרשת שמחליפה את הטבלה:
חישוב ערך Q הוא למעשה פעולת ה־forward שאנחנו מבצעים ברשת. כל מה שנותר הוא להחליף, בנוסחאות בלמן שלמדנו, את הטבלה בפונקציה של הרשת.
עדכון של רשומה בטבלה שינה רק את הערך שלה. עדכון משקלי הרשת עשוי לשנות את התחזיות לקלטים רבים. זו תכונת ההכללה שראינו בחלק ג, וכאן היא גם היתרון וגם מקור הקושי: הרשת לומדת ש"מצבים שדומים ללוח הזה שווים בערך כך וכך", אבל כל צעד אימון עלול לשנות מעט גם את מה שכבר נלמד על לוחות אחרים. נחזור לנקודה הזאת כשנוסיף את רשת המטרה.
פונקציית הטעות loss
אחרי ההחלפה מתקבלות שתי נוסחאות עדכון, של הטבלה ושל הרשת, שההבדל היחיד ביניהן הוא מקור הערכים:
לביטוי בסוגריים המרובעים קראנו TD error, כי הוא מודד את הטעות בין הערך בטבלה, וכעת בפונקציה, לבין הערך "הנכון יותר" שבנינו מהתגמול ומההמשך. אבל את השורה השנייה אי אפשר לבצע כמות שהיא: לפלט של רשת אין תא שאפשר להציב בו ערך חדש. מה שכן אפשר לעשות הוא להשתמש בטעות הזאת בתוך פונקציית הטעות MSELoss מחלק ג:
זו שגיאת TD בריבוע. בטבלה הזזנו את הערך ב־α כפול השגיאה; ברשת, הקטנת הטעות בעזרת ירידה בגרדיאנט, כלומר חיפוש מינימום הטעות, מזיזה את המשקלים כך שהתחזית תתקרב ליעד. בזמן צעד האימון מתייחסים ליעד כאל מספר קבוע ולא מעבירים דרכו גרדיאנט; הגרדיאנט מחושב רק דרך התחזית Q̂(s,a;w) שאנחנו מנסים לקרב. עבור אצווה של דוגמאות MSELoss מחשבת את ממוצע ריבועי השגיאות. מכאן והלאה, כדי לא להכביד, נכתוב Q(s,a;w) בלי הכובע: הסימון ;w מספיק כדי להזכיר שהערך מחושב ברשת.
Deep Q-learning — האלגוריתם ההתחלתי
יש לנו רשת, יעד ופונקציית טעות, ואפשר לכתוב את הגרסה הראשונה של האלגוריתם. במילים: מאתחלים את הרשת במשקלים אקראיים. בכל צעד של המשחק בוחרים פעולה בעזרת הרשת ו־ε-greedy, מבצעים אותה ומקבלים תגמול ומצב הבא. מחשבים את התחזית של הרשת לזוג שבוצע, בונים את היעד מהתגמול ומההמשך, מחשבים loss, מפעילים backward ומבצעים צעד של האופטימייזר. ממשיכים כך עד סוף המשחק ומתחילים משחק חדש. לעומת הפסאודו־קוד של Q-learning בפרק ד.9, השורות שהשתנו מסומנות באדום:
Initialize network Q(s, a; w) with random weights w
For each episode:
    Initialize S
    Repeat:
        Choose A using Q(S, a; w) and epsilon-greedy
        Perform A and observe R, S'
        prediction = Q(S, A; w)                       # forward
        If S' is terminal:
            target = R
        Else:
            target = R + gamma * max Q(S', legal action; w)
        loss = (target - prediction)^2                # MSELoss
        loss.backward()                               # gradients
        optimizer.step()                              # update w
        S = S'
    Until S is terminal
שימו לב מה לא השתנה: מבנה הלולאה, בחירת הפעולה ב־ε-greedy, הדגימה מהסביבה וההעברה S = S′ נשארו בדיוק כמו בטבלה. השתנתה רק שורת העדכון: במקום השמה לתא, שלוש שורות של צעד אימון מחלק ג. המונח "אפוק" מקבל כאן משמעות של משחק אחד, אפיזודה, ולא של מעבר על כל מערך הנתונים.
מצב סופי — Terminal State
הערך של מצב סופי הוא תמיד אפס, כי אין אחריו תגמולים עתידיים. בטבלאות V ו־Q דאגנו שערכי המצבים הסופיים יישארו אפס. ברשת נוירונים אי אפשר לקבוע מה יהיה הפלט עבור מצב סופי: הרשת היא פונקציה עם פרמטרים, והיא מחזירה מספר כלשהו, ובוודאי שאחרי עדכון הפרמטרים אין לדעת מה הוא יהיה. לכן בקוד מבצעים חישוב נפרד למצבים סופיים ומסירים במפורש את חלק העתיד:
זו בדיוק ההסתעפות שכבר מופיעה בפסאודו־קוד למעלה: במעבר סופי היעד הוא R בלבד. למשל, אחרי מהלך מנצח היעד הוא 1, גם אם הרשת מחזירה תחזיות שונות עבור הלוח הסופי. התגמול של המעבר לסיום עדיין נכלל; רק ההמשך מושמט.
אפשר לוותר על ההסתעפות בעזרת תעלול חשבוני פשוט. הדגל done הוא מספר: 1 במעבר סופי ו־0 בכל מעבר אחר. אם נכפיל את חלק העתיד ב־(1 − done), במעבר סופי הוא יוכפל באפס וייעלם, ובמעבר רגיל יוכפל באחד ויישאר כמות שהוא:
נוסחה אחת של loss מכסה את שני המקרים, ואין צורך ב־if: הגורם המסומן באדום הוא כל ההבדל בינה לבין הנוסחה שלמעלה. היתרון בולט במיוחד כשמחשבים אצווה שלמה בבת אחת: done הוא טנסור של אפסים ואחדות, אחד לכל מעבר, והכפל מסיר את חלק העתיד בדיוק בשורות הסופיות. מכאן והלאה נכתוב את היעד בצורה הזאת.
הגרסה ההתחלתית הזאת עובדת על הנייר, אבל בפועל האימון בה נוטה להיות לא יציב. בשני השלבים הבאים נזהה שתי סיבות לכך, ולכל אחת נוסיף רכיב שפותר אותה.
Replay Buffer
אחת הבעיות המרכזיות ביישום רשת נוירונים באלגוריתם TD, שמשתמש ב־bootstrapping, היא שהדגימות מהסביבה תלויות זו בזו. בזמן האימון נוצרת שרשרת של מצבים ופעולות שכל אחד מהם נובע מקודמו, ובנוסף כל הדגימות שייכות למשחק מסוים ולמדיניות מסוימת, ואינן אקראיות. בחלק ג, כשאימנו רשת על מערך נתונים, ערבבנו את הדוגמאות וחילקנו אותן לאצוות, כדי שכל אצווה תייצג את המגוון כולו. כדי שלמידת מכונה תצליח, הקלט צריך לקיים את התנאי i.i.d — Independent and Identically Distributed: דוגמאות בלתי תלויות ומאותה התפלגות. שרשרת של מעברים עוקבים מאותו משחק רחוקה מכך: אם נעדכן בכל רגע רק לפי המעבר האחרון, האימון יתבסס על מקטע צר של ההתנסות, והרשת עלולה "לשכוח" מה שלמדה ממשחקים קודמים.
הפתרון הוא מבנה נתונים, Replay Buffer, ששומר את הדגימות שאנחנו מבצעים מהסביבה. כל רשומה מכילה מעבר אחד: (state, action, reward, next_state, done). עדכון הרשת ייעשה באמצעות אצוות (batches) אקראיות שנדגמות מהמאגר, ולא מיד אחרי קבלת כל דגימה. הדגימה מערבבת חוויות ממשחקים ומרגעים שונים, ומאפשרת ללמוד שוב ושוב ממעבר שכבר נאסף. המאגר מוגבל בגודלו: כשנכנסים מעברים חדשים מעבר לקיבולת, הישנים ביותר יוצאים, וכך נשמרים בו תמיד הנתונים האחרונים, שנדגמו לפי המדיניות המעודכנת יותר.
נוסיף את המאגר לאלגוריתם. במילים: מאתחלים, נוסף לרשת, מאגר בגודל N. כל צעד של המשחק מתחלק עכשיו לשני חלקים. בחלק הראשון, דגימת הסביבה, בוחרים פעולה ומבצעים אותה כמו קודם, אבל את המעבר שהתקבל שומרים במאגר במקום לאמן עליו ישירות, ועוברים למצב הבא. בחלק השני, אימון המודל, דוגמים מהמאגר אצווה אקראית של מעברים ומבצעים על כל אחד מהם את צעד האימון מהשלב הקודם. התוספות מסומנות באדום:
Initialize network Q(s, a; w) with random weights w
Initialize replay buffer RB with capacity N
For each episode:
    Initialize S
    Repeat:
        # --- Sample the environment ---
        Choose A using Q(S, a; w) and epsilon-greedy
        Perform A and observe R, S'
        Store (S, A, R, S', done) in RB
        S = S'

        # --- Train the model ---
        Sample a random minibatch from RB
        For each (s, a, r, s', done) in the minibatch:
            prediction = Q(s, a; w)
            If done:
                target = r
            Else:
                target = r + gamma * max Q(s', legal action; w)
            loss = (target - prediction)^2
            loss.backward()
            optimizer.step()
    Until S is terminal
שני החלקים נפרדים זה מזה: דגימת הסביבה אוספת מעבר חדש אחד למאגר, ואימון המודל מתבצע על אצווה אקראית מהמאגר, שרוב חבריה מגיעים ממשחקים קודמים. לכן חשוב להבחין בין המצב החי של המשחק, שסימנו באות גדולה S, לבין המצבים שנדגמו מהמאגר לצורך האימון, באות קטנה s. המעבר S = S′ שייך לחלק הדגימה: המשחק ממשיך מן המצב שאליו הגענו עכשיו, ולא ממצב ישן שנשלף במקרה מהמאגר.
הלולאה "לכל דגימה" כתובה למעלה לשם הבהירות בלבד, ובפועל אין בה צורך. רשת נוירונים מקבלת אצווה שלמה בבת אחת: כפי שראינו בחלק ג, מעבירים לרשת טנסור שבו כל שורה היא דוגמה אחת, והרשת מחזירה טנסור של תחזיות, תחזית לכל שורה. באותו אופן מחשבים את היעדים של כל האצווה בפעולה אחת, ו־MSELoss מחשבת את ממוצע ריבועי השגיאות של כל הדוגמאות. צעד אחד של backward ושל האופטימייזר מעדכן את המשקלים לפי האצווה כולה.
ה־if על המצב הסופי נעלם אף הוא: כפי שראינו בסעיף הקודם, הכפלת חלק העתיד ב־(1 − done) מטפלת במעברים הסופיים בתוך אותה נוסחה, וכשמדובר באצווה, done הוא טנסור של אפסים ואחדות שמאפס את חלק העתיד בדיוק בשורות הנכונות. כך נראה חלק האימון בלי הלולאה ובלי ה־if, וכך גם נכתוב אותו בקוד בפרק הבא:
Initialize network Q(s, a; w) with random weights w
Initialize replay buffer RB with capacity N
For each episode:
    Initialize S
    Repeat:
        # --- Sample the environment ---
        Choose A using Q(S, a; w) and epsilon-greedy
        Perform A and observe R, S'
        Store (S, A, R, S', done) in RB
        S = S'

        # --- Train the model ---
        Sample a random minibatch (s, a, r, s', done) from RB
        predictions = Q(s, a; w)
        targets = r + (1 - done) * gamma * max Q(s', legal action; w)
        loss = mean((targets - predictions)^2)
        loss.backward()
        optimizer.step()
    Until S is terminal
כאן נכנס לתמונה היתרון של Q-learning כאלגוריתם off-policy. המעברים במאגר נאספו כשהרשת הייתה במצב אחר, ואולי גם עם ε אחר, ובכל זאת מותר ללמוד מהם, כי היעד משתמש בפעולה הטובה ביותר במצב הבא ולא בפעולה שנבחרה אז בפועל. ב־SARSA, שלומד את המדיניות שבה הוא משחק, מעבר ישן היה מלמד על מדיניות שכבר אינה קיימת.
יעד שאינו יציב — Non-stationarity of targets
בעיה נוספת נעוצה בכך שבאימון רשת נוירונים ערכי המטרה קבועים ואינם משתנים: השאלה אם תמונה מסוימת היא חתול או לא חתול אינה משתנה במהלך האימון. לעומת זאת, בלמידת חיזוק אנחנו משתמשים ב־bootstrapping, ולכן המטרות שלנו משתנות תוך כדי הלמידה. ערך המטרה R + γ·max Q(S′,a;w) משתנה בכל פעם שאנחנו משנים את פרמטרי הרשת, כי אותה רשת מחשבת גם את התחזית וגם את המטרה. אנחנו מנסים להתקרב למספר שזז בזמן שאנחנו מתאמנים. בטבלה זה היה קל יותר: עדכון תא אחד לא שינה את התאים האחרים. ברשת, צעד אימון על מצב אחד משנה, בגלל ההכללה, גם את התחזית למצב הבא, ואיתה את היעד עצמו. במקרים גרועים הרשת "רודפת אחרי הזנב של עצמה" והערכים מתבדרים.
הפתרון הוא להשתמש בשתי רשתות נוירונים בעלות אותו מבנה אך עם פרמטרים שונים:
- הרשת הראשית, בעלת המשקלים w, משמשת לבחירת הצעדים, Q(S,A;w), ואותה מעדכנים בכל איטרציה.
- רשת המטרה, בעלת המשקלים w⁻, משמשת לחישוב המטרות, R + γ·max Q(S′,a;w⁻). היא קבועה למשך C צעדים ואינה מתעדכנת. אחרי C צעדים מעתיקים אליה את משקלי הרשת הראשית: w⁻ ← w.
כך היעדים אינם משתנים בעקבות כל צעד גרדיאנט, אלא נשארים קבועים לאורך תקופה שלמה של אימון, והרשת הראשית יכולה להתכנס אליהם. אחרי ההעתקה היעדים מתעדכנים בבת אחת לפי כל מה שנלמד בינתיים. רשת המטרה אינה מקור של תשובות אמת, אלא "תמונת מצב" ישנה יותר של אותה רשת.
Deep Q-learning (DQN) — האלגוריתם המלא
נוסיף את רשת המטרה, וזהו DQN. במילים: מאתחלים את הרשת הראשית, ומעתיקים את משקליה לרשת המטרה. בחלק הדגימה בוחרים פעולה בעזרת הרשת הראשית ו־ε-greedy ושומרים את המעבר במאגר. בחלק האימון דוגמים אצווה, את התחזית מחשבים ברשת הראשית, ואת ערך ההמשך שביעד ברשת המטרה. ה־loss מעדכן את הרשת הראשית בלבד. אחת ל־C משחקים מעתיקים את משקלי הראשית למטרה. התוספות לעומת השלב הקודם מסומנות באדום:
Initialize main network Q(s, a; w) with random weights w
Initialize target network Q(s, a; w⁻) and copy: w⁻ ← w
Initialize replay buffer RB with capacity N
For each episode:
    Initialize S
    Repeat:
        # --- Sample the environment ---
        Choose A using Q(S, a; w) and epsilon-greedy
        Perform A and observe R, S'
        Store (S, A, R, S', done) in RB
        S = S'

        # --- Train the model ---
        Sample a random minibatch (s, a, r, s', done) from RB
        predictions = Q(s, a; w)
        targets = r + (1 - done) * gamma * max Q(s', legal action; w⁻)
        loss = mean((targets - predictions)^2)
        loss.backward()
        optimizer.step()
    Until S is terminal
    Every C episodes: w⁻ ← w
השינוי בנוסחת היעד הוא תו אחד, w⁻ במקום w, ומשמעותו שערכי ההמשך מגיעים מרשת המטרה:
כמה דגשים למימוש. יחידת הסנכרון כאן היא משחקים שהסתיימו: ההעתקה נמצאת מחוץ ללולאת הצעדים, ומתבצעת פעם אחת אחרי כל C אפיזודות. זה גם המימוש שבו נשתמש בפרק הבא, וכך עושה גם המאמן במאגר Tic_Tac_Toe_DQN: רשת המטרה נוצרת שם כעותק של הראשית, ואחת ל־C אפוקים מועתקים אליה המשקלים באמצעות load_state_dict. אם בוחרים במקום זאת לספור C צעדי אימון, זו הגדרה אחרת של התדירות, וצריך לציין אותה במפורש. ערכי ההמשך מחושבים ברשת המטרה ללא גרדיאנט, והאופטימייזר מקבל רק את פרמטרי הרשת הראשית; כך אין עדכון עקיף של רשת המטרה. ובתחילת הריצה, כשהמאגר עדיין כמעט ריק, נהוג להמתין עד שיצטברו בו מספיק מעברים לאצווה שלמה לפני שמתחילים לאמן.
שימו לב שב־DQN רשת המטרה גם קובעת איזו פעולת המשך היא הטובה ביותר וגם נותנת את הערך שלה: ה־max עושה את שני הדברים בבת אחת. בחירת פעולת ההתנסות במשחק ממשיכה להיעשות ברשת הראשית עם ε-greedy. לעובדה שרשת אחת גם בוחרת וגם מעריכה נחזור בפרק על DDQN.
כעת יש לנו את כל רכיבי DQN: רשת במקום טבלה, מאגר מעברים ורשת מטרה. בפרק הבא נחבר אותם לאימון סוכן באיקס עיגול, באמצעות ממשק המשחק הנתון.