ג.24 השלמות — Moon — ללמוד גבול סיווג שאינו ישר
בפרק הקודם ראינו שקו ישר אינו מספיק לרגרסיה כשהקשר בנתונים גלי. אותה מגבלה קיימת גם בסיווג. ברגרסיה הלוגיסטית המודל מחשב סכום משוקלל אחד של הקלטים ומעביר אותו ב־Sigmoid; כשיש שני קלטים, פירוש הדבר שהוא מותח קו ישר אחד במישור ומכריז: כל מה שמצד אחד שייך לקטגוריה הראשונה, וכל מה שמצד השני — לשנייה. קו זה נקרא גבול הסיווג — Decision Boundary: הוא מפריד בין האזורים שבהם המודל בוחר בכל קטגוריה. אבל בעולם האמיתי הקבוצות לא תמיד ניתנות להפרדה בקו ישר. דמיינו מפה שבה בתי עיר מסוימת מקיפים אגם: "בתוך העיר" ו"באגם" אינם ניתנים להפרדה בשום קו ישר, ורק גבול עקום — מעגל — יעשה זאת. גבול הסיווג, אם כן, עשוי להיות עקום, ונדרש מודל שיכול ללמוד גבול כזה.
בפרק זה נבחן שלושה מבנים של נתונים בשתי קטגוריות: סהרונים, אשכולות וטבעות. הנתונים דו־ממדיים בכוונה, כדי שנוכל לצייר אותם ולראות בעין איזו צורת גבול נדרשת לכל אחד: האשכולות ניתנים להפרדה בקו ישר, ואילו הסהרונים והטבעות — לא. לאחר מכן נאמן על הסהרונים את אותה רשת שהכרנו — שכבות לינאריות עם ReLU ו־Sigmoid בפלט — ונציג כיצד היא מסווגת נקודות נוספות במישור, כלומר איזה גבול היא למדה.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: מצגת רשת נוירונים ANN (עותק מקומי) · מחברת Moon (עותק מקומי)
סהרונים — Moons
ספריית scikit-learn מספקת פונקציות ליצירת נתונים מדומים בצורות מוגדרות, וכך נוכל לבחון את המודל על נתונים שאנו יודעים בדיוק כיצד הם בנויים. נתחיל ב־make_moons: ניצור 1,000 נקודות בשתי קבוצות בצורת סהר, עם רעש 0.1. הפרמטר noise קובע כמה הנקודות יתפזרו סביב הצורה המדויקת, ו־random_state מבטיח שנקבל את אותן נקודות בכל הרצה:
from sklearn.datasets import make_moons

X, y = make_moons(
    n_samples=1000,
    noise=0.1,
    random_state=42
)
X הוא מערך של 1,000 שורות ושתי עמודות — הקואורדינטות x1 ו־x2 של כל נקודה — ו־y הוא התווית, 0 או 1. נציג את הנקודות בצבעים לפי הקטגוריה:
import matplotlib.pyplot as plt

plt.scatter(X[:, 0], X[:, 1], c=y, cmap="coolwarm", s=20)
plt.xlabel("x1")
plt.ylabel("x2")
plt.title("make_moons dataset")
plt.show()
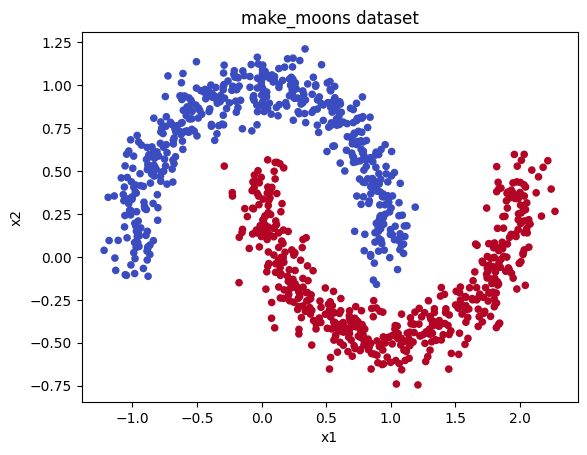
שני הסהרונים משולבים זה בזה: הקצה של האחד נכנס לתוך הקעורה של השני. כל קו ישר שנמתח יחתוך לפחות את אחד מהם, ולכן רגרסיה לוגיסטית לבדה הייתה טועה כאן בחלק ניכר מהנקודות.
אשכולות — Blobs
לשם השוואה נראה מבנה פשוט יותר. ניצור 1,000 נקודות סביב שני מרכזים, כל קבוצה מפוזרת סביב המרכז שלה בסטיית תקן 1.0:
from sklearn.datasets import make_blobs

X, y = make_blobs(
    n_samples=1000,
    centers=2,
    cluster_std=1.0,
    random_state=42
)
נציג את האשכולות:
plt.figure()
plt.scatter(X[:, 0], X[:, 1], c=y)
plt.xlabel("x1")
plt.ylabel("x2")
plt.title("make_blobs")
plt.show()
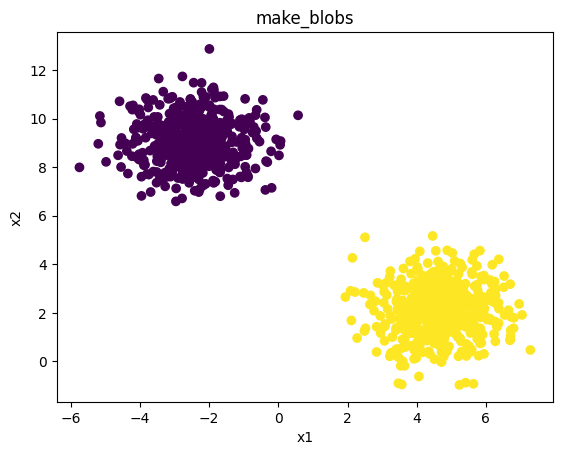
כאן שתי הקבוצות נמצאות משני צדדים של המישור, וקו ישר אחד מפריד ביניהן כמעט לחלוטין. זהו המקרה שבו רגרסיה לוגיסטית מספיקה.
טבעות — Circles
המבנה השלישי הוא הקשה ביותר לקו ישר. ניצור שתי טבעות, עם רעש 0.05 ויחס רדיוסים 0.5 — הטבעת הפנימית ברדיוס חצי מזה של החיצונית:
from sklearn.datasets import make_circles

X, y = make_circles(
    n_samples=1000,
    noise=0.05,
    factor=0.5,
    random_state=42
)
נציג את הטבעות:
plt.figure()
plt.scatter(X[:, 0], X[:, 1], c=y)
plt.xlabel("x1")
plt.ylabel("x2")
plt.title("make_circles")
plt.show()
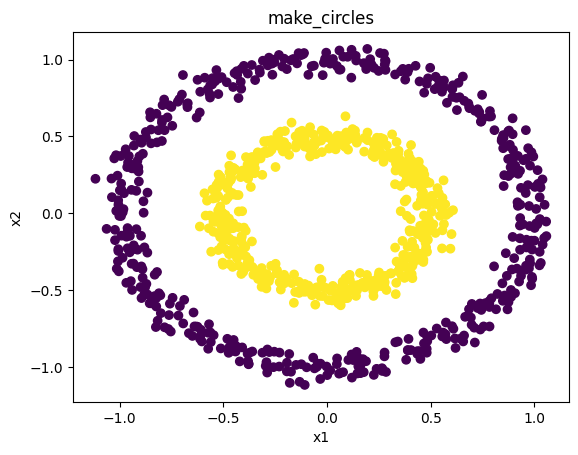
קבוצה אחת מקיפה את השנייה מכל הצדדים. מכל צד שנמתח קו ישר, יהיו נקודות משתי הקבוצות משני צדדיו; כאן רק גבול סגור, כמו מעגל, יכול להפריד.
הכנת דוגמת האימון
אחרי שהכרנו את שלוש צורות הנתונים, נחזור לסהרונים ונכין אותם לאימון הרשת. סדר העבודה מוכר: יצירת הנתונים ופיצולם, המרה לטנסורים ואצוות, הגדרת הרשת, אימון ובדיקה.
נייבא את הספריות הדרושות לאימון:
import numpy as np
import torch
import torch.nn as nn
from torch.utils.data import TensorDataset, DataLoader
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
import matplotlib.pyplot as plt
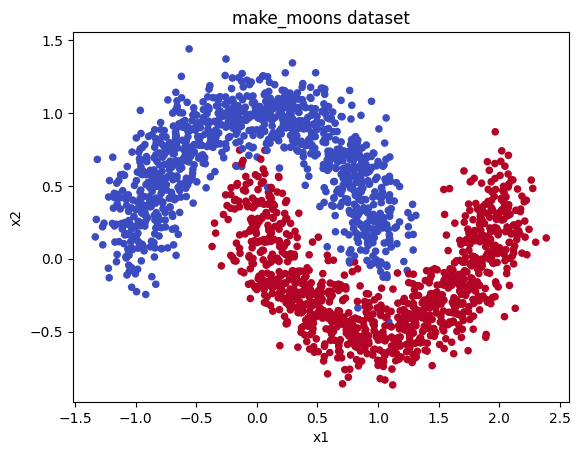
ניצור הפעם 2,000 נקודות בצורת סהר, עם רעש 0.15 — קצת יותר מבעבר, כדי שהמשימה לא תהיה קלה מדי — ונחלק ל־80% אימון ו־20% בדיקה, כדי שנוכל למדוד את הדיוק על נקודות שהרשת לא ראתה. הפרמטר stratify=y שומר בקירוב על יחס הקטגוריות בחלוקה, כך שבשתי הקבוצות יהיו בערך אותו מספר נקודות מכל סהרון.
# -----------------------
# 1) Create dataset
# -----------------------
X, y = make_moons(n_samples=2000, noise=0.15, random_state=42)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
נגדיר פונקציה להצגת הנתונים ונפעיל אותה. הפונקציה תשמש אותנו שוב בסוף הפרק, כשנרצה לצייר את התחזיות מעל הנתונים:
def plot_moons ():
    plt.scatter(X[:, 0], X[:, 1], c=y, cmap="coolwarm", s=20)
    plt.xlabel("x1")
    plt.ylabel("x2")
    plt.title("make_moons dataset")

plot_moons ()
טנסורים ואצוות
נמיר את הקלטים והתוויות לטנסורים. התוויות מומרות ל־float ומסודרות בעמודה (view(-1, 1)), משום ש־BCE משווה אותן לפלט הרשת, שהוא עמודה של הסתברויות. בפרק הקודם כתבנו מחלקת Dataset בעצמנו; כשהנתונים כבר טנסורים אפשר להשתמש ב־TensorDataset המוכנה, שמצמידה כל קלט לתווית שלו. נגדיר אצוות אימון של 64 דוגמאות ואצוות בדיקה של 256 — בבדיקה אין עדכון משקלים, ולכן אפשר להשתמש באצוות גדולות יותר.
# To torch tensors
X_train_t = torch.tensor(X_train, dtype=torch.float32)
y_train_t = torch.tensor(y_train, dtype=torch.float32).view(-1, 1)

X_test_t  = torch.tensor(X_test, dtype=torch.float32)
y_test_t  = torch.tensor(y_test, dtype=torch.float32).view(-1, 1)

# DataLoaders
train_loader = DataLoader(TensorDataset(X_train_t, y_train_t), batch_size=64, shuffle=True)
test_loader  = DataLoader(TensorDataset(X_test_t, y_test_t), batch_size=256, shuffle=False)
פרמטרים ומבנה הרשת
נבחר התקן חישוב ונגדיר את גדלי הרשת ופרמטרי האימון: שני קלטים (הקואורדינטות x1 ו־x2 של כל נקודה), שתי שכבות חבויות של 16 יחידות, 50 מעברים (אפוקים) וקצב למידה 0.01. הרשת קטנה בהרבה מזו של MNIST, כי הקלט הוא שני מספרים בלבד ולא 784:
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# -----------------------
# 2) Build Sequential FNN
# -----------------------
input_size = 2
hidden1 = 16
hidden2 = 16
epochs = 50
learning_rate = 0.01
נגדיר רשת עם ReLU בשכבות החבויות ו־Sigmoid בפלט, הפסד BCE ואופטימייזר Adam. שכבת הפלט וההפסד זהים לאלה של הרגרסיה הלוגיסטית, כי השאלה עדיין בינארית; מה שנוסף הוא השכבות החבויות, והן שיאפשרו לגבול הסיווג להתעקם:
Model = nn.Sequential(
    nn.Linear(input_size, hidden1, device=device),
    nn.ReLU(),
    nn.Linear(hidden1, hidden2, device=device),
    nn.ReLU(),
    nn.Linear(hidden2, 1, device=device),
    nn.Sigmoid()
)

Loss = nn.BCELoss()
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון ובדיקה בכל מעבר
עד כה בדקנו את המודל רק בסוף האימון. הפעם נשלב את הבדיקה בתוך הלולאה: בכל אפוק נעבור על אצוות האימון ונעדכן את המשקלים, ולאחר מכן נחשב את דיוק הסיווג על קבוצת הבדיקה כולה. כך נוכל לעקוב אחר השיפור מאפוק לאפוק ולראות מתי הרשת מפסיקה להשתפר. הקריאות Model.train() ו־Model.eval() מודיעות לרשת אם היא במצב אימון או במצב בדיקה; ברשת הפשוטה שלנו אין להן השפעה בפועל, אך זהו הרגל טוב, כי יש שכבות שמתנהגות אחרת בשני המצבים. הבדיקה מתבצעת בתוך torch.no_grad(), ונקודה מסווגת ל־1 כשההסתברות היא לפחות 0.5:
# -----------------------
# 3) Train loop
# -----------------------
for epoch in range(epochs):
    Model.train()
    for Xb, yb in train_loader:
        Xb = Xb.to(device)
        yb = yb.to(device)

        probs = Model(Xb)
        loss = Loss(probs, yb)

        optim.zero_grad()
        loss.backward()
        optim.step()

    # -----------------------
    # 4) Evaluate each epoch
    # -----------------------
    Model.eval()
    with torch.no_grad():
        probs_test = Model(X_test_t.to(device))
        preds_test = (probs_test >= 0.5).float().cpu()
        acc = (preds_test == y_test_t).float().mean().item()

    if (epoch + 1) % 5 == 0 or epoch == 0:
        print(f"epoch={epoch+1:02d} loss={loss.item():.4f} test_acc={acc*100:.2f}%")
פלט
epoch=01 loss=0.3519 test_acc=84.00%
epoch=05 loss=0.2133 test_acc=94.25%
epoch=10 loss=0.0145 test_acc=98.75%
epoch=15 loss=0.0079 test_acc=98.50%
epoch=20 loss=0.0305 test_acc=98.25%
epoch=25 loss=0.0851 test_acc=98.75%
epoch=30 loss=0.1121 test_acc=98.75%
epoch=35 loss=0.0579 test_acc=98.50%
epoch=40 loss=0.0297 test_acc=98.75%
epoch=45 loss=0.1111 test_acc=98.25%
epoch=50 loss=0.1097 test_acc=98.50%
הפלט הוא דוגמה שמורה. loss הוא הפסד האצווה האחרונה באימון, ואילו test_acc הוא הדיוק על כל קבוצת הבדיקה. הדיוק עולה מ־84.00% אחרי האפוק הראשון ל־98.75% כבר באפוק 10, ומשם הוא נשאר יציב סביב 98.25%–98.75%. הנקודות הבודדות שנותרות שגויות הן כנראה אלה שהרעש העביר אל תוך הסהרון השני, ואותן לא יוכל לסווג נכון שום גבול סביר. ההפסד, לעומת זאת, קופץ מאפוק לאפוק (0.0079 באפוק 15 ו־0.1121 באפוק 30) משום שהוא נמדד על אצווה אחת של 64 נקודות בלבד, ולא על כל הנתונים.
חיזוי ל־100 נקודות חדשות
הדיוק על קבוצת הבדיקה מספר לנו כמה נקודות סווגו נכון, אך לא איזה גבול הרשת למדה. כדי לראות כיצד הרשת מחלקת את המישור לקטגוריות, נבדוק גם נקודות שלא נכללו באימון, ובכלל זה נקודות באזורים הריקים שבין הסהרונים ומחוצה להם. נגריל 100 נקודות באופן אחיד במלבן שסביב הנתונים, עם שוליים של 0.5 מכל צד:
n_random = 100

x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5

X_rand = np.random.uniform(
    low=[x_min, y_min],
    high=[x_max, y_max],
    size=(n_random, 2)
)
נחשב לכל נקודה הסתברות ונסווג לפי סף 0.5, בדיוק כפי שעשינו בבדיקה. את התוצאה נחזיר ל־CPU ונמיר למערך NumPy כדי שנוכל לצייר אותה:
with torch.no_grad():
    X_rand_t = torch.tensor(X_rand, dtype=torch.float32).to(device)

    probs = Model(X_rand_t)
    preds = (probs >= 0.5).float().cpu().numpy().reshape(-1)
נצבע את הנקודות החדשות באדום או בכחול ונציג אותן ככוכבים מעל נתוני הסהרונים:
colors = ["red" if p == 1 else "blue" for p in preds]
plot_moons ()
plt.scatter(
    X_rand[:, 0],
    X_rand[:, 1],
    c=colors,
    marker="*",
    s=150
)
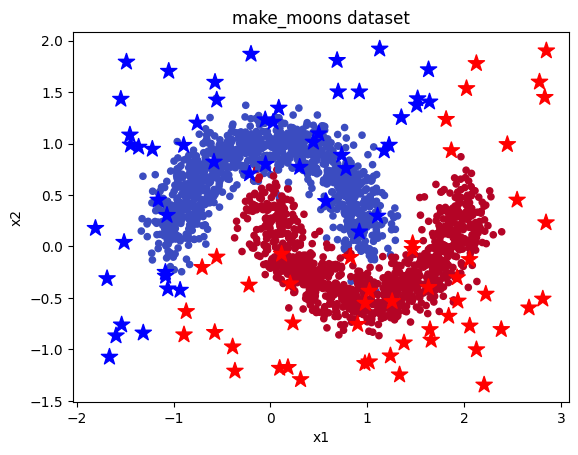
לנקודות החדשות לא הוגדרו תוויות אמת; הצבע מציג את החלטת המודל, ולא בדיקת דיוק נוספת. מה שהתמונה מראה הוא ההכללה של הרשת: גם נקודות שנמצאות רחוק מכל נקודת אימון מקבלות צבע, לפי הצד של הגבול העקום שבו הן נמצאות. הכוכבים האדומים והכחולים מתחלקים לאורך קו מפותל שעוקב אחר צורת הסהרונים — גבול סיווג שקו ישר אחד לא היה יכול לתת. באותה דרך אפשר לאמן את הרשת גם על הטבעות, שבהן הגבול הנדרש סגור לחלוטין.