ג.4 נגזרות ו־Autograd
בפרק המבוא ראינו שאימון רשת פירושו לשנות את המשקלים כדי להקטין את הטעות, ונשארנו עם שאלה פתוחה: לאיזה כיוון לשנות כל משקל? נדמיין שאנו מסובבים כפתור ומודדים את הטעות. אם סיבוב קטן ימינה מגדיל את הטעות, כדאי לסובב שמאלה; אם הוא מקטין אותה, כדאי להמשיך ימינה. מה שאנו צריכים הוא מדד לכך: כמה הטעות משתנה כשמשנים מעט את המשקל. במתמטיקה למדד הזה קוראים נגזרת.
הנגזרת מתארת כיצד ערך הפונקציה משתנה בסביבת נקודה, ולכן יכולה להנחות אותנו בחיפוש מינימום. אם נדע לחשב את נגזרת הטעות לפי כל משקל, נדע לאיזה כיוון להזיז כל אחד מהם, וזה בדיוק מה שנעשה בפרקים הבאים כשנרד בצעדים קטנים אל המינימום של פונקציית הטעות. ברשת אמיתית יש אלפי משקלים ואלפי נגזרות לחשב, ולכן איננו רוצים לגזור ביד; PyTorch עושה זאת בשבילנו במנגנון הנקרא Autograd.
הפרק בנוי בשני חלקים. תחילה נרענן את המתמטיקה: נלמד כללי גזירה, נגזרות חלקיות וכלל השרשרת, ונבין כיצד פירוק חישוב לצעדים קטנים מאפשר לגזור פונקציה מורכבת. לאחר מכן נראה כיצד PyTorch מחשבת נגזרות באמצעות גרף חישוב, ונלמד את כללי השימוש במנגנון: איך מפעילים אותו, איך קוראים את התוצאה, ומתי צריך לכבות אותו או לאפס אותו.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 3. PyTorch Autograd · השיעור באתר הקורס · מחברת Autograd ב־Colab
מהי נגזרת?
נתחיל בפונקציה של משתנה אחד, כמו אלה שמכירים מבית הספר, ונבין מה הנגזרת אומרת לנו על הגרף. הנגזרת בנקודה מתארת את שיפוע הישר המשיק לגרף באותה נקודה. נגזרת חיובית מצביעה על עלייה, ונגזרת שלילית על ירידה, וככל שהערך המוחלט שלה גדול יותר, הגרף תלול יותר. בנקודת מינימום או מקסימום פנימית שבה הפונקציה גזירה, הנגזרת מתאפסת; נגזרת אפס לבדה אינה מבטיחה מינימום. שלוש העובדות האלה — סימן הנגזרת, גודלה והתאפסותה בנקודת קיצון — הן כל מה שנצטרך כדי לחפש מינימום בפרק הבא.
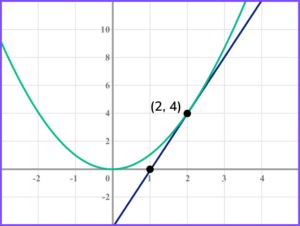
השתנות הנגזרת בהתאם לשיפוע הגרף
חשוב להבין שהנגזרת אינה מספר אחד לפונקציה כולה, אלא פונקציה בפני עצמה. השיפוע משתנה לאורך הגרף, ולכן גם ערך הנגזרת משתנה. למשל, עבור הפונקציה f(x) = x·sin(x²) + 1 מוצגת הנגזרת f′(x) = sin(x²) + 2x²·cos(x²). בכל נקודה ערכה קובע את שיפוע המשיק שם. לכן כשנחפש מינימום נצטרך לחשב את הנגזרת מחדש בכל נקודה שאליה נגיע.
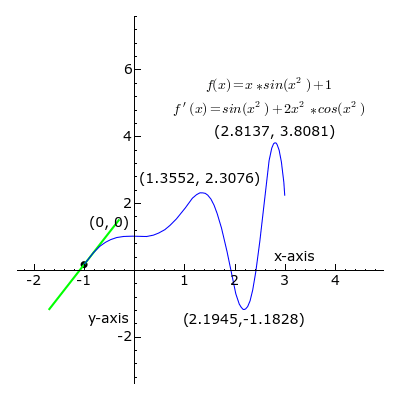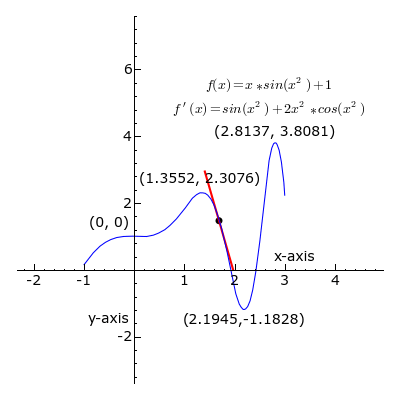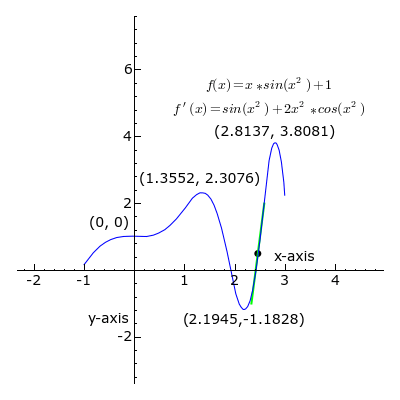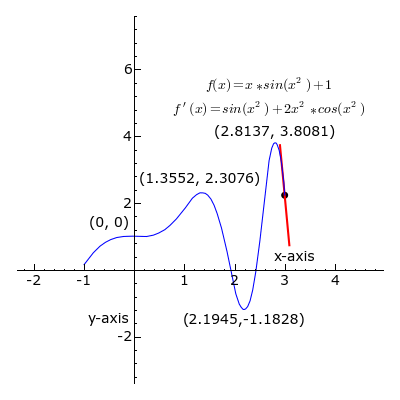
עקבו אחרי המשיק באנימציה: כל עוד הגרף עולה המשיק ירוק ושיפועו חיובי; בנקודת המקסימום (1.3552, 2.3076) הוא מתיישר והנגזרת מתאפסת; בירידה אל נקודת המינימום (2.1945, −1.1828) הוא אדום ושיפועו שלילי, ואחרי המינימום הוא שוב ירוק. זו בדיוק התמונה שתנחה אותנו בפרק הבא: סימן הנגזרת אומר לאן ללכת, והתאפסותה אומרת שהגענו לנקודת קיצון.
חישוב נגזרת
איך מוצאים את הנגזרת? אין צורך לחשב שיפועים של משיקים בעין. כללי גזירה מאפשרים לקבל נוסחה לנגזרת מתוך נוסחת הפונקציה. נסתפק כאן בכללים הבסיסיים, שמספיקים לפולינומים; אלה גם הכללים ש־Autograd מפעיל מאחורי הקלעים.
נסמן את הנגזרת של f(x) ב־f′(x). נשתמש בכללים הבאים:
| פונקציה | נגזרת |
|---|---|
| קבוע, למשל f(x)=5 | f′(x)=0 |
| f(x)=x | f′(x)=1 |
| כפל בקבוע: f(x)=k·g(x) | f′(x)=k·g′(x) |
| סכום: f(x)=g(x)+h(x) | f′(x)=g′(x)+h′(x) |
| חזקה: f(x)=xⁿ | f′(x)=n·xⁿ⁻¹ |
לדוגמה, הנגזרת של x⁵ היא 5x⁴. בשילוב הכללים אפשר לגזור כל פולינום איבר־איבר: גוזרים כל חזקה בנפרד, כופלים במקדם ומחברים.
נגזרת חלקית
עד כאן גזרנו פונקציות של משתנה אחד, כמו בבית הספר. אבל הטעות של רשת נוירונים אינה תלויה במשקל אחד אלא בכל המשקלים יחד, ולכן היא פונקציה של משתנים רבים: loss(w₁, w₂, …, wₙ). כדי להקטין את הטעות נצטרך לדעת, לכל משקל בנפרד, האם להגדיל אותו או להקטין אותו. לשם כך משתמשים בנגזרת חלקית. זהו נושא שלא נלמד בשיעורי המתמטיקה בתיכון, אך הרעיון פשוט, ונסביר אותו מהתחלה.
הרעיון: מסובבים כפתור אחד בלבד
דמיינו מכשיר עם שני כפתורים, x ו־y, שמציג מספר אחד, f(x, y). איך נדע מה כל כפתור עושה? מחזיקים את y במקומו ומסובבים רק את x: קצב השינוי של המספר הוא הנגזרת החלקית לפי x. אחר כך מחזיקים את x ומסובבים רק את y. בנגזרת חלקית לפי משתנה אחד מתייחסים לכל שאר המשתנים כאל מספרים קבועים, ואז גוזרים בדיוק לפי הכללים שכבר למדנו.
גם התמונה הגרפית עוזרת: הגרף של פונקציה בשני משתנים הוא משטח, כמו גבעה. בנקודה על הגבעה אפשר לשאול מה השיפוע כשהולכים בכיוון x, ומה השיפוע כשהולכים בכיוון y. אלה שני מספרים שונים, ואלה שתי הנגזרות החלקיות.
סימון
לנגזרת של פונקציה במשתנה אחד כתבנו f′(x). כתיב נפוץ אחר, שנפגוש בספרים ובתיעוד של PyTorch, הוא שבר:
בנגזרת חלקית כותבים באותו אופן, ומציינים במכנה לפי איזה משתנה גוזרים:
בספרי מתמטיקה ובתיעוד של PyTorch תפגשו בנגזרת חלקית גם את האות המעוגלת ∂ במקום d, למשל ∂f/∂x. האות נקראת דֶל, והמשמעות זהה לגמרי: נגזרת לפי x כשהמשתנים האחרים קבועים. בספר זה נמשיך לכתוב d, שמוכר לכם מנגזרת רגילה.
דוגמה ראשונה
ניקח את הפונקציה:
גזירה לפי x. מתייחסים ל־y כאל מספר קבוע. אילו y היה 5, הפונקציה הייתה x² + 25, ונגזרתה 2x: הנגזרת של x² היא 2x, והנגזרת של הקבוע היא 0. אותו דבר קורה לכל y, ולכן:
גזירה לפי y. עכשיו x הוא הקבוע: האיבר x² נגזר לאפס, והאיבר y² נגזר ל־2y:
בנקודה (x, y) = (1, 2) נקבל df/dx = 2 ו־df/dy = 4. המשמעות: בנקודה זו הגדלה קטנה של x מגדילה את f בקצב 2, והגדלה קטנה של y מגדילה את f בקצב 4. הפונקציה רגישה יותר ל־y מאשר ל־x.
דוגמה שנייה: איבר שבו שני המשתנים מוכפלים
גזירה לפי x, איבר אחר איבר, כש־y קבוע:
- 3x² נגזר ל־6x.
- 2y³ אינו מכיל x, ולכן הוא קבוע ונגזרתו 0.
- 4xy הוא x כפול המספר הקבוע 4y. כמו שהנגזרת של 20x היא 20, הנגזרת של 4y·x היא 4y.
גזירה לפי y, כש־x קבוע:
- 3x² קבוע, נגזרתו 0.
- 2y³ נגזר ל־6y².
- 4xy הוא y כפול הקבוע 4x, ולכן נגזרתו 4x.
נציב את הנקודה (1, 2):
הגרדיאנט
אוסף הנגזרות החלקיות של פונקציה, אחת לכל משתנה, נקרא גרדיאנט — Gradient ומסומן ∇f. בדוגמה השנייה, בנקודה (1, 2):
הגרדיאנט אומר לנו, לכל משתנה, כמה הפונקציה גדלה כשמזיזים אותו מעט, ולכן גם לאיזה כיוון ללכת כדי להקטין אותה: הפוך לסימן של כל רכיב. ברשת נוירונים המשתנים הם המשקלים, ולכל משקל יש רכיב משלו בגרדיאנט. זהו המונח שממנו נגזר שמו של Autograd, ושל אלגוריתם Gradient Descent שנלמד בפרק הבא.
כלל השרשרת
רשת נוירונים היא פונקציה מורכבת: הפלט של שכבה אחת נכנס לשכבה הבאה, וזו שוב לבאה אחריה, ובסוף מחשבים מהכול את הטעות. כדי לגזור שרשרת כזו של פונקציות צריך כלל אחד נוסף, והוא הבסיס לכל מנגנון Autograd.
פונקציה מורכבת
ניקח את הפונקציה:
כללי הגזירה שלמדנו מטפלים ב־x², אבל כאן בריבוע נמצא לא x אלא ביטוי שלם, 2x + 1. זו פונקציה מורכבת: קודם מחשבים מ־x את הביטוי הפנימי, ואחר כך מפעילים על התוצאה את הפונקציה החיצונית. נפריד בין שני השלבים ונסמן את התוצאה הפנימית באות v:
x קובע את v, ו־v קובע את y. כאשר x משתנה, v משתנה, ובעקבותיו גם y. השאלה היא באיזה קצב y משתנה ביחס ל־x, כלומר מהי dy/dx.
הכלל
כל אחד משני השלבים קל לגזור בנפרד. הקצב שבו v משתנה ביחס ל־x הוא dv/dx, והקצב שבו y משתנה ביחס ל־v הוא dy/dv. כלל השרשרת אומר שהקצב הכולל הוא מכפלת שני הקצבים:
ההיגיון: אם v גדל פי 2 מהר יותר מ־x, ו־y גדל פי 3 מהר יותר מ־v, אז y גדל פי 3 · 2 = 6 מהר יותר מ־x. הקצבים מצטברים בכפל לאורך השרשרת. הכתיב בשברים עוזר לזכור את הכלל: נדמה כאילו dv במונה ו־dv במכנה מצטמצמים ונשאר dy/dx. זו דרך לזכור, לא הוכחה, אבל היא עובדת תמיד.
דוגמה ראשונה
נחזור ל־y = (2x + 1)² ונגזור כל שלב:
נכפול, ונציב חזרה v = 2x + 1 כדי לקבל תשובה במונחי x בלבד:
כאן אפשר לבדוק שהכלל נכון בלי להאמין לו: נפתח את הסוגריים, (2x + 1)² = 4x² + 4x + 1, ונגזור איבר־איבר לפי הכללים הרגילים. מתקבל 8x + 4, בדיוק אותה תשובה.
דוגמה שנייה
כשהחזקה גבוהה, פתיחת סוגריים כבר אינה מעשית, וכלל השרשרת הוא הדרך היחידה הנוחה. ניקח:
נפרק לשני שלבים ונגזור כל אחד:
נכפול ונציב חזרה:
נחשב את הנגזרת בנקודה x = 1. בשלב הפנימי v = 3 + 2 = 5 ו־dv/dx = 6. בשלב החיצוני dy/dv = 3 · 25 = 75. מכפלתם:
ואכן הצבה בנוסחה הסופית נותנת 18 · 1 · 25 = 450.
הכלל במילים ובשרשרת ארוכה
גוזרים את הפונקציה החיצונית כאילו הביטוי הפנימי הוא משתנה אחד, וכופלים בנגזרת של הביטוי הפנימי. הכלל אינו מוגבל לשני שלבים. אם y תלוי ב־u, u תלוי ב־v, ו־v תלוי ב־x, כופלים את כל הנגזרות לאורך הדרך:
זו בדיוק המבנה של רשת נוירונים: הקלט עובר שכבה אחר שכבה עד לטעות, וכדי לדעת כמה הטעות משתנה כשמשנים משקל בשכבה מוקדמת, כופלים את הנגזרות של כל השלבים שבין המשקל לטעות. בסעיף הבא נראה כיצד PyTorch מארגן את החישוב הזה.
בניית גרף חישוב
כלל השרשרת נותן לנו שיטה מכנית: כל חישוב, מסובך ככל שיהיה, אפשר לפרק לפעולות בסיסיות שאת הנגזרת של כל אחת מהן קל לחשב, ואז לכפול את הנגזרות לאורך הדרך. את הפירוק הזה נוח לצייר כתרשים שבו כל צומת הוא פעולה אחת. לתרשים כזה קוראים גרף חישוב — Computational Graph, וזה בדיוק מה ש־PyTorch בונה מאחורי הקלעים. נבנה גרף כזה בעצמנו, צעד אחר צעד, ובסעיף הבא נשתמש בו כדי לחשב נגזרת.
ניקח את הפונקציה:
כדי לפרק אותה נשאל איך היינו מחשבים אותה ביד, עבור x נתון. מתחילים מהפנים של הסוגריים: קודם כופלים את x ב־4, אחר כך מחסירים 1, ורק בסוף מעלים את התוצאה בריבוע. כל שלב כזה הוא פעולה אחת פשוטה, ואת התוצאה של כל שלב נשמור במשתנה, בדיוק כאילו הצבנו את הביטוי הפנימי במשתנה חדש:
זהו אותו חישוב, רק כתוב בשלושה שלבים במקום בשורה אחת. עכשיו נצייר אותו כגרף. כל עיגול הוא משתנה, כל תיבה היא פעולה, והחצים מראים מה נכנס לכל פעולה ומה יוצא ממנה:
קוראים את הגרף משמאל לימין, בכיוון החצים, כמו את החישוב הידני: מ־x מגיעים ל־a, מ־a ל־b, ומ־b ל־L.
חישוב הנגזרת באמצעות גרף החישוב
נגזרת בנקודה, לא נוסחת נגזרת
לפני שנשתמש בגרף חשוב להבהיר מה הוא מחשב. כשגזרנו ביד קיבלנו נוסחה, למשל f′(x) = 2x, שאפשר להציב בה כל x. גרף החישוב עובד אחרת: הוא מחשב את הערך המספרי של הנגזרת בנקודה אחת. בוחרים x מסוים, מחשבים את כל הערכים בגרף עבור אותו x, ומקבלים מספר אחד: שיפוע הגרף באותה נקודה. רוצים את הנגזרת בנקודה אחרת? מריצים את כל התהליך שוב עם ה־x החדש. זה בדיוק מה שדרוש ברשת נוירונים: בכל רגע יש למשקלים ערכים מסוימים, ורוצים לדעת את השיפוע שם.
בהמשך נבחר את הנקודה x = 1 ונחשב את הנגזרת dL/dx בה. התהליך מורכב משני מעברים על הגרף: מעבר קדימה ומעבר לאחור.
פעפוע קדימה — Forward
במעבר הראשון הולכים לאורך החצים ומחשבים את ערך כל משתנה, בדיוק כמו בחישוב ידני. עבור x = 1:
בסוף המעבר ידועים ערכי כל המשתנים: x = 1, a = 4, b = 3, L = 9. את ערכי הביניים שומרים, ולא רק את התוצאה הסופית, כי הם יידרשו במעבר הבא.
הנגזרות המקומיות
לכל פעולה בגרף יש נגזרת מקומית: הנגזרת של הפלט שלה ביחס לקלט שלה, בלי להתחשב בשאר הגרף. את החישוב נעשה בשני שלבים נפרדים, ובשלב שלישי נכפול. חשוב להפריד ביניהם: בשלב הראשון מקבלים נוסחאות, ורק בשלב השני מציבים בהן את הנקודה ומקבלים מספרים.
שלב ראשון: נוסחאות הנגזרות המקומיות. גוזרים כל פעולה בנפרד, לפי כללי הגזירה הרגילים, בלי להתייחס לשום ערך מספרי:
הכפל ב־4 תורם שיפוע 4, החיסור של קבוע אינו משנה את השיפוע ותורם 1, והריבוע תורם 2b. שתי הראשונות הן מספרים קבועים, אך השלישית היא נוסחה שתלויה ב־b: ערכה שונה בכל נקודה.
שלב שני: הצבת הנקודה. אנחנו מחשבים את הנגזרת בנקודה x = 1, ומהמעבר קדימה ידוע לנו שבנקודה זו a = 4 ו־b = 3. נציב את הערכים האלה בנוסחאות של השלב הראשון, ונקבל לכל פעולה מספר אחד:
מעכשיו הנגזרת המקומית של הריבוע היא המספר 6, לא הנוסחה 2b. זו הסיבה שהגרף מחשב נגזרת בנקודה: הצבנו בנוסחאות את הערכים שהתקבלו במעבר קדימה, ובנקודה אחרת היינו מקבלים מספר אחר.
שלב שלישי: הכפל. נותר לחבר את שלושת המספרים לפי כלל השרשרת. זהו המעבר לאחור.
פעפוע לאחור — Backward
כעת נחבר את הנגזרות המקומיות לפי כלל השרשרת. L תלוי ב־b, b תלוי ב־a, ו־a תלוי ב־x, ולכן:
את המכפלה מחשבים בהליכה על הגרף בכיוון ההפוך לחצים, מ־L חזרה אל x. מתחילים ב־L עצמו: הנגזרת של L ביחס לעצמו היא 1. בכל צעד לאחור עוברים דרך פעולה אחת וכופלים את הערך שצברנו עד כה בנגזרת המקומית שלה:
בסוף המעבר לאחור מתקבל המספר שחיפשנו: בנקודה x = 1 הנגזרת היא dL/dx = 24. בדרך קיבלנו גם את הנגזרות של L ביחס לכל משתני הביניים, וברשת נוירונים אלה בדיוק הנגזרות ביחס לכל המשקלים, כולם במעבר אחד. השם "לאחור" מתאר את כיוון ההליכה: מהתוצאה הסופית צעד־צעד חזרה אל הקלט.
בדיקה
נוודא שהגרף צודק. נפתח את הסוגריים ונגזור ביד:
בנקודה x = 1 מתקבל 32 − 8 = 24, בדיוק כמו בגרף. שימו לב להבדל בין שתי הדרכים: הגזירה הידנית נתנה את הנוסחה 32x − 8, שתקפה לכל x, ואילו הגרף נתן רק את המספר 24, שתקף לנקודה x = 1 בלבד.
דוגמה נוספת: אותו גרף בנקודה x = 2
כדי לקבל את הנגזרת בנקודה אחרת אין צורך לבנות גרף חדש. הגרף והנוסחאות של הנגזרות המקומיות נשארים בדיוק אותו דבר; רק המספרים משתנים. נחזור על שלושת השלבים עבור x = 2.
פעפוע קדימה. מחשבים את ערכי המשתנים לאורך החצים:
הנגזרות המקומיות בנקודה. הנוסחאות מהשלב הראשון לא השתנו: 4, 1 ו־2b. מציבים בהן את הערך החדש b = 7:
פעפוע לאחור. מתחילים מ־1 ב־L וכופלים צעד אחר צעד:
בנקודה x = 2 הנגזרת היא 56, והנוסחה מסכימה: 32 · 2 − 8 = 56. השוו בין שני התרשימים: המבנה זהה, הנגזרות המקומיות של הכפל והחיסור זהות, ורק הנגזרת המקומית של הריבוע השתנתה, מ־6 ל־14, כי היא תלויה בערך של b באותה נקודה. זה כל ההבדל בין נגזרת בנקודה אחת לנגזרת בנקודה אחרת.
זהו בדיוק התהליך ש־Autograd מבצע: בזמן החישוב קדימה הוא בונה את הגרף ושומר את ערכי הביניים, ובקריאה ל־backward הוא הולך לאחור וכופל את הנגזרות המקומיות. בהמשך הפרק נראה זאת בקוד.
הפעלת Autograd
עברנו לחלק המעשי. את כל מה שעשינו ביד בסעיף הקודם — פירוק לפעולות, חישוב קדימה, חישוב לאחור עם כלל השרשרת — PyTorch יודעת לעשות בעצמה על כל חישוב שנכתוב בטנסורים. ל־PyTorch יש מנגנון לחישוב נגזרות אוטומטי. נייבא את הספריות:
import torch
import numpy as np
המעקב אחרי החישוב עולה בזיכרון ובזמן, ולכן PyTorch אינה עוקבת אחרי כל טנסור אלא רק אחרי אלה שסימנו. באימון אלה יהיו המשקלים; כאן זהו x. כדי לעקוב אחר המשתנה שלפיו נגזור, נגדיר requires_grad=True.
x = torch.tensor([1], dtype=torch.float, requires_grad=True)
print (x)
פלט
tensor([1.], requires_grad=True)
מרגע הסימון, כל פעולה שנבצע על x, ועל התוצאות שנובעות ממנו, נרשמת. נבנה את אותו חישוב (4x−1)² מהסעיף על גרף החישוב, בשלושה צעדים נפרדים. הפעולות על הטנסור נרשמות בגרף חישוב:
v = 4 * x
z = v - 1
w = z ** 2

print (v)
print (z)
print (w)
פלט
tensor([4.], grad_fn=<MulBackward0>)
tensor([3.], grad_fn=<SubBackward0>)
tensor([9.], grad_fn=<PowBackward0>)
המאפיין grad_fn מציין את הפעולה שיצרה את התוצאה: MulBackward0 לכפל, SubBackward0 לחיסור ו־PowBackward0 לחזקה. אלה בדיוק הצמתים של גרף החישוב, וכל אחד מהם יודע לחשב את הנגזרת המקומית שלו. בשלב זה נבנה הגרף; הנגזרת המספרית תחושב בחישוב לאחור.
חישוב נגזרת באמצעות Autograd
כעת נסגור את המעגל ונקבל מ־PyTorch את המספר עצמו. כמו בגרף החישוב שציירנו, החישוב נעשה בשני שלבים: תחילה מחשבים את ערך הפונקציה, ולאחר מכן מפעילים backward() לחישוב הנגזרת. התוצאה אינה מוחזרת מהפונקציה אלא נכתבת לשדה grad של הטנסור שסומן למעקב. הפעם נציב x=2, ובהערה שבקוד מופיעה נוסחת הנגזרת שחישבנו ביד, כדי שנוכל להשוות.
x = torch.tensor([2.0], requires_grad=True)
#forward
l = (4*x-1)**2    # l' = 2(4x-1)4 = 8(4x-1)
print (l)
print(x.grad)

# backwrad
l.backward()
print (x.grad)
פלט
tensor([49.], grad_fn=<PowBackward0>)
None
tensor([56.])
לפני backward() מופיע None בשדה x.grad; לאחר הקריאה נשמרת בו הנגזרת. שימו לב היכן התוצאה נשמרת: backward() אינה מחזירה דבר. הנגזרת נכתבת לתוך הטנסור שסומן ב־requires_grad=True, בשדה grad שלו, וקוראים אותה משם. הערך 56 מתאים לנוסחה: 8(4·2−1)=56. אפשר גם להגדיר את החישוב בתוך פונקציה, ואז נחזור לנקודה x=1 מגרף החישוב ונצפה לקבל 24:
def F (x):
    return (4*x-1)**2

x = torch.tensor([1.0], requires_grad=True)

#forward
f = F(x)
print(f)

#backward
f.backward()
print(x.grad)
פלט
tensor([9.], grad_fn=<PowBackward0>)
tensor([24.])
חישוב נגזרת חלקית במספר משתנים
כשהחישוב תלוי בכמה משתנים, נוכל לבקש נגזרת ביחס לכל אחד מהם. נחליף את הקבועים בפונקציה במשתנים ונחשב את Loss=(wx−y)². השמות נבחרו בכוונה: x הוא הקלט, w הוא המשקל, y היא התשובה הרצויה, ו־wx הוא הפלט של "רשת" בת נוירון יחיד ללא אקטיבציה. ריבוע ההפרש בין הפלט לתשובה הרצויה הוא הטעות. מבין שלושת המשתנים, המשקל w הוא זה שנרצה לשנות באימון, ולכן הנגזרת לפיו היא המעניינת. את x נגדיר ללא מעקב, כמו שנעשה עם נתוני קלט אמיתיים.
x = torch.tensor([1.0], requires_grad=False)
w = torch.tensor([3.0], requires_grad=True)
y = torch.tensor([4.0], requires_grad=True)

def Loss(w, x, y):
    return (w * x - y) ** 2   #torch.sin

#forward
loss = Loss(w, x, y)

print(f"loss: {loss}")
פלט
loss: tensor([1.], grad_fn=<PowBackward0>)
הפלט של הרשת הוא 3 והתשובה הרצויה 4, ולכן הטעות היא 1. הנגזרת לפי w היא 2(wx−y)x, ובנקודה הנתונה ערכה −2. הנגזרת שלילית, כלומר הגדלת w תקטין את הטעות, וזה הגיוני: הפלט 3 קטן מהתשובה 4.
#backward
loss.backward()

print (f"loss'(x) (1,3,4) = {x.grad}")
print (f"loss'(w) (1,3,4) =  {w.grad}")
print (f"loss'(y) (1,3,4) =  {y.grad}")
פלט
loss'(x) (1,3,4) = None
loss'(w) (1,3,4) =  tensor([-2.])
loss'(y) (1,3,4) =  tensor([2.])
עבור x מתקבל None מפני שהוגדר ללא מעקב; אין פירוש הדבר שהנגזרת המתמטית שלו היא אפס. קריאה אחת ל־backward() חישבה את הנגזרות לפי כל המשתנים המסומנים בבת אחת. כל משתנה שומר את הנגזרת שלו בתוך עצמו: הנגזרת לפי w נמצאת ב־w.grad, והנגזרת לפי y ב־y.grad. כך, כשלפונקציה יש כמה משתנים, אין צורך במבנה נתונים נפרד לנגזרות: לכל משתנה, למשל w1 ו־w2, יש שדה grad משלו ובו הנגזרת החלקית לפיו. כך יהיה גם ברשת עם אלפי משקלים: לכל משקל נגזרת משלו, השמורה בתוכו, וזה מה שיאפשר בפרק הבא לעדכן כל משקל לפי הנגזרת שלו.
נגזרת במספר נקודות בפונקציה המחזירה סקלר
באימון אמיתי איננו מודדים את הטעות על דוגמה אחת אלא על אוסף של דוגמאות, ומסכמים את הטעויות למספר אחד. לכן x, w ו־y יהיו עכשיו טנסורים בני כמה איברים, וההפסד יהיה סכום. פונקציה יכולה לקבל טנסור של ערכים ולהחזיר מספר יחיד, למשל סכום או ממוצע. בדוגמה הבאה נסכום את ריבועי ההפרשים:
x = torch.tensor([1,2,3,4], dtype=torch.float32, requires_grad=True)
w = torch.tensor([4.0, 4.5, 2.0, 3.0], requires_grad=True)
y = torch.tensor([1.5,3,4.5,6])

L = ((w * x - y) ** 2).sum()
print (L)
פלט
tensor(80.5000, grad_fn=<SumBackward0>)
נחשב את הנגזרות לפי רכיבי x ולפי רכיבי w:
L.backward()
print(x, w, y, L)
print (f"loss'(x) = {x.grad}")
print (f"loss'(w) =  {w.grad}")
פלט
tensor([1., 2., 3., 4.], requires_grad=True) tensor([4.0000, 4.5000, 2.0000, 3.0000], requires_grad=True) tensor([1.5000, 3.0000, 4.5000, 6.0000]) tensor(80.5000, grad_fn=<SumBackward0>)
loss'(x) = tensor([20., 54.,  6., 36.])
loss'(w) =  tensor([ 5., 24.,  9., 48.])
הנגזרת של טנסור היא טנסור באותה צורה: לכל איבר ב־x ולכל איבר ב־w מתקבלת נגזרת חלקית משלו, המתארת כמה ההפסד הכולל L משתנה כשמזיזים רק את האיבר הזה. לרכיב הראשון מתקבלים dL/dx₁=20 ו־dL/dw₁=5.
נגזרת במספר נקודות בפונקציה המחזירה ערכים מרובים
backward() יודעת לפעול ישירות רק על תוצאה שהיא מספר יחיד, מפני שרק אז ברור מה גוזרים. מה עושים כשהתוצאה היא וקטור? אפשר לחשב נגזרות גם כאשר מתקבלות כמה תוצאות נפרדות. כעת נשאיר את ריבועי ההפרשים כווקטור, ללא סכימה:
x = torch.tensor([1,2,3,4], dtype=torch.float32, requires_grad=True)
w = torch.tensor([4.0, 4.0, 4.0, 4.0], requires_grad=True)
y = torch.tensor([1.5,3,4.5,6])
#forward
l = (w * x - y) ** 2
print (l)
פלט
tensor([ 6.2500, 25.0000, 56.2500, 100.0000], grad_fn=<PowBackward0>)
כאשר הפלט מכיל כמה איברים, נעביר ל־backward וקטור באותה צורה כמו הפלט. הווקטור אומר ל־PyTorch באיזה משקל לצרף כל רכיב של הפלט לחישוב. כאן נבחר וקטור אחדות, השקול לחישוב נגזרת סכום הרכיבים; זו הבחירה הנפוצה, וכך נשתמש בה גם בתרגילים בסוף הפרק.
v = torch.tensor([1.0,1.0,1.0,1.0])
# backward
l.backward(v)
print (f"loss'(x) = {x.grad}")
print (f"loss'(w) =  {w.grad}")
פלט
loss'(x) = tensor([20., 40., 60., 80.])
loss'(w) =  tensor([ 5., 20., 45., 80.])
ברכיב הראשון, עבור w=4 ו־y=1.5, הנגזרת לפי x היא 8(4x−1.5), ולכן ב־x=1 מתקבל 20. עבור x=1 ו־y=1.5, הנגזרת לפי w היא 2(w−1.5), ולכן ב־w=4 מתקבל 5.
ביטול Autograd
למדנו להפעיל את המנגנון; עכשיו נלמד שלושה כללי זהירות שבלעדיהם קוד האימון ייתן תוצאות שגויות: הנגזרות נצברות, טנסור במעקב אינו ניתן להמרה ישירה ל־NumPy, ולעיתים צריך לבצע חישוב בלי שיירשם בגרף. נתחיל בצבירה. בכל קריאה ל־backward() הנגזרות מתווספות לערכים שכבר נצברו בשדה grad, במקום להחליף אותם.
x = torch.tensor([1.0], requires_grad=True)
l = (4*x-1)**2
print (l)
l.backward()
print ('dL/dx(1) = ', x.grad)

y = x**2
print (y)
y.backward()
print ('Accumulated x.grad = ', x.grad) # Y'=2X , Y'(1) = 2
פלט
tensor([9.], grad_fn=<PowBackward0>)
dL/dx(1) =  tensor([24.])
tensor([1.], grad_fn=<PowBackward0>)
Accumulated x.grad =  tensor([26.])
אחרי החישוב הראשון נצבר 24. הנגזרת של y=x² ב־x=1 היא 2, ולכן לאחר החישוב השני השדה מכיל 26, ולא 2. באימון, שבו קוראים ל־backward() שוב ושוב, צבירה כזו תשבש את הכיוון של כל צעד, ולכן נצטרך לאפס את השדה; נראה זאת בסעיף "איפוס הגרדיאנטים".
הכלל השני נוגע להמרה ל־NumPy, שלמדנו בפרק הקודם. אי אפשר להמיר ישירות ל־NumPy טנסור שדורש מעקב נגזרות, מפני שמערך NumPy אינו יכול להשתתף בגרף החישוב. השורה הבאה מדגימה פעולה שתגרום לשגיאה:
x_np = x.numpy()
יש שתי דרכים לקבל מטנסור כזה טנסור רגיל שאפשר להמיר. אפשר לבטל את המעקב בטנסור עצמו:
x = torch.tensor([1.0], requires_grad=True)
print(x)
x.requires_grad_(False)
print(x)
פלט
tensor([1.], requires_grad=True)
tensor([1.])
אפשר גם לקבל טנסור מנותק באמצעות detach():
x = torch.tensor([1.0], requires_grad=True)
print(x)
y = x.detach()
print(y)
print(x)
פלט
tensor([1.], requires_grad=True)
tensor([1.])
tensor([1.], requires_grad=True)
detach() מנתקת את המעקב, אך הטנסור המוחזר חולק את הנתונים בזיכרון עם המקור. ההבדל בין השתיים: requires_grad_(False) משנה את הטנסור עצמו ומפסיקה את המעקב אחריו לתמיד, ואילו detach() משאירה את המקור במעקב ונותנת עותק מנותק לשימוש צדדי, למשל לציור גרף.
השהיית Autograd
הכלל השלישי: לפעמים נרצה להשאיר את הטנסור במעקב, אך לבצע עליו פעולה מסוימת בלי שתירשם בגרף. הדוגמה החשובה ביותר תגיע בפרק הבא: עדכון המשקלים בעצמו אינו חלק מהחישוב שגוזרים, ולכן מבצעים אותו מחוץ למעקב. ההקשר with torch.no_grad(): משהה את המעקב אחר חישובים שבתוכו. בדוגמה הבאה אפשר לבצע את ההמרה ל־NumPy בתוך ההקשר:
x = torch.tensor([1.0], requires_grad=True)
with torch.no_grad():
    x_np = x.numpy()
print (x_np)
print(x)
# np = np.array([1.0])
# print(np)
פלט
[1.]
tensor([1.], requires_grad=True)
לאחר היציאה מההקשר, הדגל requires_grad של x נשאר פעיל.
איפוס הגרדיאנטים
נחזור לבעיית הצבירה ונראה את הפתרון בתוך לולאה, בדומה ללולאת האימון שנכתוב בפרק הבא. כדי לחשב נגזרת חדשה בלי לצבור את הקודמת, נאפס את השדה בעזרת zero_(). בדוגמה W הוא טנסור של ארבעה "משקלים", ובכל חזרה של הלולאה מחשבים קדימה, גוזרים לאחור, מדפיסים את הגרדיאנט ומאפסים אותו. המשתנה epoch הוא השם המקובל למספר החזרה; אפוק — epoch הוא מעבר אחד על הנתונים בזמן אימון, ובפרקים הבאים נשתמש בשם הזה שוב ושוב.
W = torch.tensor([2.0, 3, 5, 8], requires_grad=True)

for epoch in range(3):
    #forward
    model = (W * 3).mean()
    print(model)
    #backward
    model.backward()
    print (W.grad)
    W.grad.zero_()
פלט
tensor(13.5000, grad_fn=<MeanBackward0>)
tensor([0.7500, 0.7500, 0.7500, 0.7500])
tensor(13.5000, grad_fn=<MeanBackward0>)
tensor([0.7500, 0.7500, 0.7500, 0.7500])
tensor(13.5000, grad_fn=<MeanBackward0>)
tensor([0.7500, 0.7500, 0.7500, 0.7500])
הממוצע של ארבעה איברים שכל אחד מהם הוא 3W נגזר לפי כל רכיב ל־3/4=0.75. בלי שורת האיפוס היו מתקבלים ברכיבי הגרדיאנט 0.75, אחר כך 1.5 ולבסוף 2.25. עם האיפוס מתקבל בכל חזרה 0.75, כפי שרואים בפלט. שימו לב שהאיפוס נעשה במקום, בפעולת in-place עם קו תחתון, כפי שלמדנו בפרק הקודם.
תרגילים
בתרגילים הבאים נחשב נגזרות של פונקציות בכמה נקודות בבת אחת, בעזרת הטכניקה של וקטור האחדות שלמדנו. חשבו באמצעות PyTorch את הנגזרות הבאות, לפי הסדר:
- y=3x²+0.5x+5, בנקודות −3, 1, 4, 9.
- הנגזרות לפי W של loss=mean((W·X−Y)²), כאשר W=[−0.5,1,2,3], X=[1,2,3,4], Y=[2,4,6,8].
- f=2x³−3x², בנקודות −2, 0, 0.5, 1, 2. מה אפשר ללמוד מהנגזרות?
התרגיל הראשון: ארבע הנקודות מוכנסות לטנסור אחד, ולכן החישוב קדימה מחזיר ארבעה ערכים, וכדי לגזור נעביר ל־backward וקטור אחדות באורך 4.
x = torch.tensor([-3,1,4,9], dtype=torch.float32, requires_grad=True)
y = 3 * x**2 + 0.5 * x + 5 # forward
print(y)
פלט
tensor([ 30.5000, 8.5000, 55.0000, 252.5000], grad_fn=<AddBackward0>)
v = torch.ones(4)
y.backward(v)
print(x.grad )
פלט
tensor([-17.5000, 6.5000, 24.5000, 54.5000])
הנגזרת של הפונקציה היא 6x+0.5; בנקודה −3 היא שלילית, כלומר הפונקציה יורדת שם, ובשאר הנקודות היא חיובית.
התרגיל השני: כאן ההפסד הוא ממוצע של ארבעה ריבועי הפרשים, כלומר מספר יחיד, ולכן backward() נקראת ללא וקטור. שימו לב שהתשובה הרצויה Y היא בדיוק 2X.
W = torch.tensor ([-0.5,1,2,3], dtype=torch.float32, requires_grad=True)
X = torch.tensor ([1,2,3,4])
Y = torch.tensor ([2,4,6,8])
loss = ((W*X-Y)**2).mean() # forward
print(loss)
loss.backward()
print(W.grad)
פלט
tensor(6.5625, grad_fn=<MeanBackward0>)
tensor([-1.2500, -2.0000,  0.0000,  8.0000])
הרכיב השלישי של W הוא 2, בדיוק הערך שמביא את W·X להיות שווה ל־Y, ולכן הנגזרת לפיו היא 0: אין טעם להזיז אותו. הרכיבים הראשון והשני קטנים מ־2 ונגזרתם שלילית, כלומר צריך להגדיל אותם; הרביעי גדול מ־2 ונגזרתו חיובית, כלומר צריך להקטין אותו. זהו בדיוק המידע שאלגוריתם האימון יזדקק לו.
התרגיל השלישי:
x = torch.tensor([-2,0,0.5,1,2], dtype=torch.float32, requires_grad=True)
f = 2*x**3 - 3 * x **2 # forward
v = torch.ones(5)
print (f)
f.backward(v)
print (x.grad)
פלט
tensor([-28.0000,   0.0000,  -0.5000,  -1.0000,   4.0000],
       grad_fn=<SubBackward0>)
tensor([36.0000,  0.0000, -1.5000,  0.0000, 12.0000])
הנגזרת מתאפסת בשתי נקודות, 0 ו־1. בין הנקודות האלה, ב־0.5, הנגזרת שלילית: הפונקציה יורדת. מחוץ להן, ב־−2 וב־2, הנגזרת חיובית: הפונקציה עולה. מכאן ש־0 היא נקודת מקסימום מקומי ו־1 היא נקודת מינימום מקומי. זו דוגמה לכך שנגזרת אפס לבדה אינה אומרת לנו אם הגענו למינימום, כפי שציינו בתחילת הפרק.
נגזרות חלקיות — דוגמה נוספת: נסיים בשתי דוגמאות של נגזרות חלקיות, שבהן כל משתנה הוא טנסור נפרד במעקב ו־backward() ממלאת את השדה grad של כל אחד מהם. f(x₁,x₂)=3x₁²+2(x₂+2)³, בנקודה (1,2).
x1 = torch.tensor([1.0], requires_grad=True)
x2 = torch.tensor([2.0], requires_grad=True)
#forward
f = 3*x1**2 + 2*(x2 +2)**3
print(f)
#backward
f.backward()

print(x1.grad, x2.grad)
פלט
tensor([131.], grad_fn=<AddBackward0>)
tensor([6.]) tensor([96.])
אפשר לבדוק ביד: לפי x₁ הנגזרת היא 6x₁, ובנקודה 1 מתקבל 6; לפי x₂ הנגזרת היא 6(x₂+2)², ובנקודה 2 מתקבל 96.
נגזרות חלקיות בשלושה משתנים: f(x₁,x₂,x₃)=(3x₁+x₂)²(x₃+5), בנקודה (2,1,3).
def F (x1, x2, x3):
    return (3*x1 + x2)**2*(x3 + 5)

#forward
x1 = torch.tensor([2.0], requires_grad=True)
x2 = torch.tensor([1.0], requires_grad=True)
x3 = torch.tensor([3.0], requires_grad=True)
f = F(x1, x2, x3)
print(f)

#backward
f.backward()
print(x1.grad, x2.grad, x3.grad)
פלט
tensor([392.], grad_fn=<MulBackward0>)
tensor([336.]) tensor([112.]) tensor([49.])
יש לנו עתה את שני הכלים הדרושים לאימון: טנסורים שמחזיקים את הנתונים והמשקלים, ו־Autograd שמחשב לכל משקל את נגזרת הטעות לפיו. בפרק הבא נחבר אותם לאלגוריתם שמשתמש בנגזרות כדי לרדת, צעד אחר צעד, אל המינימום של פונקציית ההפסד.