ג.22 חתול או לא חתול — CNN לסיווג בינארי
בפרק הקודם הכרנו את רשת הקונבולוציה ואימנו אותה על מאגר מוכן, CIFAR-10, שהגיע ארוז ומסודר מתוך torchvision. בעולם האמיתי הנתונים מגיעים לרוב פחות מסודרים: אוסף תמונות בקובץ, שצריך לבדוק את צורתו, לפצל, להמיר ולנרמל בעצמנו לפני שאפשר להאכיל בו רשת. פרק זה הוא תרגיל שמאגד את כל מה שלמדנו בחלק ג: הכנת נתונים מקובץ גולמי, בניית CNN, אימון, שמירה, בדיקה והצגת תוצאות — הכול על בעיה אחת קטנה ומוחשית.
הבעיה היא סיווג בינארי, כמו ברגרסיה לוגיסטית וב־Pima, אבל הקלט הוא תמונה צבעונית. לכן נשלב שני דברים שהכרנו בנפרד: את שכבות הקונבולוציה, שיודעות להפיק תכונות מתמונה, ואת נוירון הפלט היחיד עם Sigmoid ו־BCELoss, שיודע לענות כן או לא. לאורך הפרק נשים לב לצורות של הטנסורים — זו הנקודה שבה רוב הטעויות קורות כשעובדים עם נתונים משלנו.
נשתמש ברשת קונבולוציה כדי לענות על שאלה בינארית: האם בתמונה מופיע חתול? תמונות הקלט הן בגודל 64×64 ובצבע; חתול מסומן בתווית 1, ולא־חתול בתווית 0. המאגר קטן — 259 תמונות בלבד — ונראה בסוף הפרק מה המשמעות של גודל כזה לתוצאות.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: מצגת רשתות קונבולוציה (עותק מקומי) · מחברת התרגיל (עותק מקומי) · מחברת הפתרון (עותק מקומי)
להרצה נדרש הקובץ cats.pth של הקורס — קובץ PyTorch שבו שמורים, בפורמט שהכרנו בפרק ג.20, מערך התמונות ומערך התוויות. מעלים אותו באמצעות Files ואז Upload בסרגל הצד של Colab; האחסון בסביבת הריצה זמני. הטעינה משתמשת ב־weights_only=False, ולכן יש לטעון רק קובץ ממקור מהימן.
יבוא הספריות
נייבא את הספריות. הפעם אין torchvision, כי הנתונים אינם מגיעים ממאגר מוכן; במקום זאת נשתמש ב־TensorDataset ו־DataLoader כדי לבנות טוען נתונים מטנסורים שנכין בעצמנו:
import torch
import torch.nn as nn
import torch.nn.functional as F
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split

from torch.utils.data import DataLoader, TensorDataset
נבחר את התקן החישוב:
# Device configuration
if torch.cuda.is_available():
    device = torch.device('cuda')
else:
    device = torch.device('cpu')
print(device)
טעינת הנתונים
torch.load מחזירה כאן זוג: מערך התמונות ומערך התוויות. הדבר הראשון שעושים עם נתונים לא מוכרים הוא לבדוק את צורתם. נטען את התמונות והתוויות ונבדוק את ממדיהן:
# prepare data
file = 'cats.pth'
data, labels = torch.load(file, weights_only=False)

print(data.shape, labels.shape)
# print(data[25])
פלט
(259, 64, 64, 3) (259,)
יש 259 תמונות, וכל אחת היא 64 שורות, 64 עמודות ושלושה ערוצי צבע. שימו לב לסדר: כאן הערוצים הם הממד האחרון, כפי שנהוג בקובצי תמונה וב־matplotlib, ואילו PyTorch מצפה שהערוצים יבואו לפני הגובה והרוחב — 3×64×64, כמו ב־CIFAR-10. נצטרך לטפל בכך בהמשך. התוויות הן וקטור של 259 ערכים, 0 או 1.
נציג את התמונות במקומות 25 ו־26 ואת התוויות שלהן, כדי לראות איך נראות דוגמה חיובית ודוגמה שלילית. הסדר הנוכחי של הממדים מתאים בדיוק ל־imshow, ולכן אפשר להציג את המערך ישירות:
# Example of a picture
index1 = 25 # change index to get a different picture
index2 = 26 # change index to get a different picture
plt.subplot(1,2,1)
plt.imshow(data[index1])
plt.title(labels[index1])
plt.subplot(1,2,2)
plt.imshow(data[index2])
plt.title(labels[index2])
plt.show()
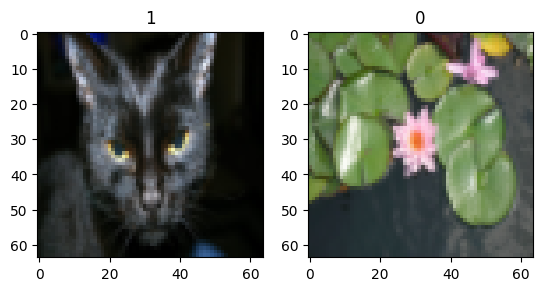
פיצול לאימון ולבדיקה
כמו תמיד, נשמור חלק מהתמונות בצד כדי למדוד בסוף את ההכללה. נפצל ל־80% אימון ו־20% בדיקה, בערבוב קבוע לפי random_state; הפלט מאשר שהתקבלו 207 תמונות אימון ו־52 תמונות בדיקה:
data_train_np, data_test_np, target_train_np, target_test_np = train_test_split (data,labels, train_size=0.8, random_state=10, shuffle=True)
print ('train np shape: ',data_train_np.shape, target_train_np.shape)
print ('test np shape: ', data_test_np.shape, target_test_np.shape)
פלט
train np shape:  (207, 64, 64, 3) (207,)
test np shape:  (52, 64, 64, 3) (52,)
המרה לטנסורים
כאן נפתור את בעיית סדר הממדים. נמיר את נתוני האימון ממערכי NumPy לטנסורים מסוג float32, ובאמצעות permute(0,3,1,2) נסדר מחדש את הצירים: הציר 0 (מספר התמונה) נשאר ראשון, הציר 3 (הערוצים) עובר למקום השני, ואחריו הגובה והרוחב. כך מ־(207, 64, 64, 3) מתקבל (207, 3, 64, 64). את התוויות נסדר בעמודה, שורה לכל תמונה, כדי שיתאימו לפלט היחיד של הרשת — כפי שעשינו ב־Pima עם unsqueeze:
data_train = torch.from_numpy(data_train_np.astype(np.float32))
data_train = data_train.permute(0,3,1,2)
target_train = torch.from_numpy(target_train_np.astype(np.float32))
target_train = target_train.view(target_train.shape[0],-1)
נבצע אותה המרה לנתוני הבדיקה:
data_test = torch.from_numpy(data_test_np.astype(np.float32))
data_test = data_test.permute(0,3,1,2)
target_test = torch.from_numpy(target_test_np.astype(np.float32))
target_test = target_test.view(target_test.shape[0],-1)
נבדוק את הצורות שהתקבלו. זו בדיקה שכדאי לעשות תמיד לפני בניית הרשת, כי שכבת הקונבולוציה הראשונה מצפה לשלושה ערוצים בממד השני:
print ('train tensor shape: ', data_train.shape, target_train.shape)
print ('test tensor shape: ', data_test.shape, target_test.shape)
פלט
train tensor shape:  torch.Size([207, 3, 64, 64]) torch.Size([207, 1])
test tensor shape:  torch.Size([52, 3, 64, 64]) torch.Size([52, 1])
נרמול
ערכי הפיקסלים בקובץ הם בטווח 0–255. בפרק הקודם ToTensor עשתה את הנרמול בשבילנו; הפעם, כשהנתונים לא עברו דרך torchvision, נעשה זאת ידנית. נתאים את ערכי הפיקסלים לטווח 0–1 באמצעות חלוקה ב־255, על נתוני האימון והבדיקה כאחד:
data_train = data_train / 255
data_test = data_test / 255
Dataset ו־DataLoader
עד כה השתמשנו ב־DataLoader רק על מאגרים של torchvision. TensorDataset מאפשר לבנות מאגר מכל זוג טנסורים: הוא מצמיד לכל תמונה את התווית שלה, ומכאן DataLoader עובד בדיוק כרגיל. ניצור אצוות של 25 תמונות, עם ערבוב באימון בלבד:
batch_size = 25
data_train = TensorDataset(data_train, target_train)
data_test = TensorDataset(data_test, target_test)

train_loader = DataLoader(dataset=data_train, batch_size=batch_size, shuffle=True)
test_loader = DataLoader(dataset=data_test, batch_size=batch_size, shuffle=False)
דוגמאות מקבוצת האימון
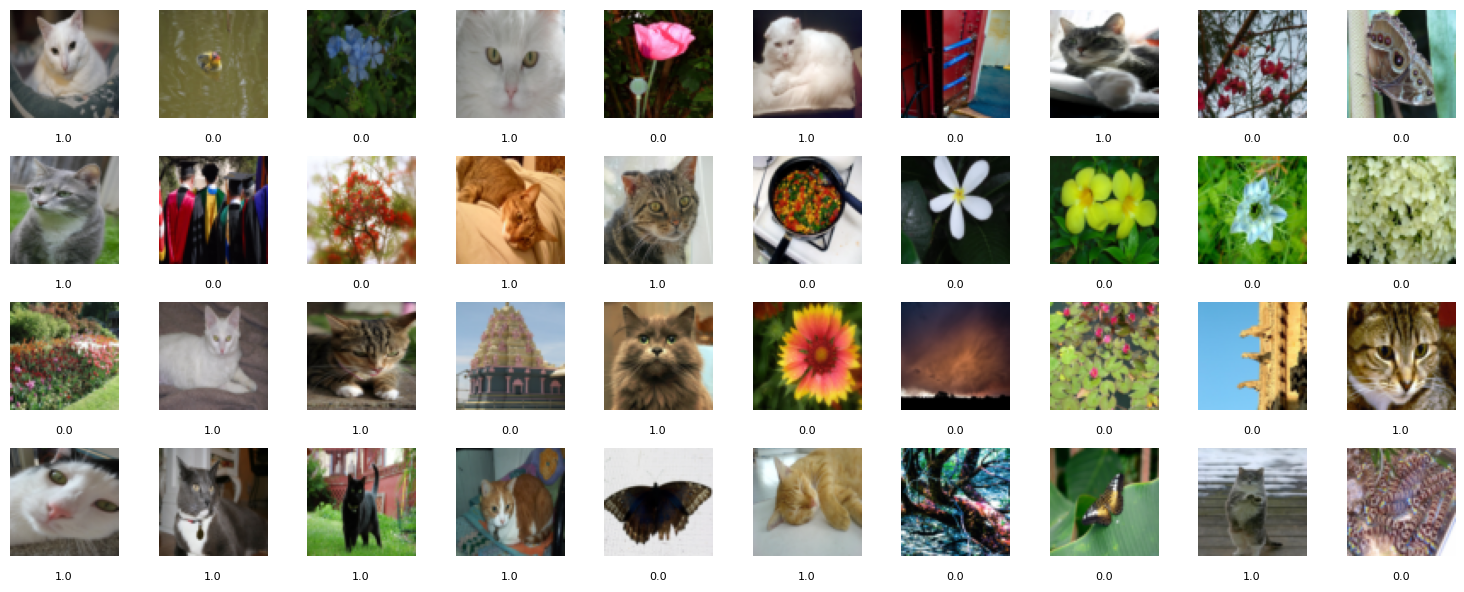
לפני האימון נסתכל על מה שהרשת עומדת ללמוד. נציג עשר תמונות מכל אחת מארבע אצוות אימון, עם התוויות שלהן. מכיוון שהטנסורים כבר בסדר של PyTorch ומנורמלים, נצטרך להחזיר אותם לתצוגה: permute(1,2,0) מחזיר את הערוצים לסוף, והכפל ב־255 מחזיר את הערכים לטווח המקורי:
dataiter = iter(train_loader)
fig = plt.figure(figsize=(15, 6))
for i in range(4):
    images, labels = next(dataiter)
    for j in range(0, 10):
        ax = fig.add_subplot(4, 10, i * 10 + j + 1)
        ax.imshow((images[j].permute(1,2,0).numpy()*255).astype(np.intp))
        ax.axis('off') # Turn off axis to remove ticks and labels
        # Use ax.text for better placement of labels
        ax.text(0.5, -0.15, str(labels[j].item()), color='black', transform=ax.transAxes, ha='center', va='top', fontsize=8)
plt.tight_layout() # Adjust layout to prevent labels from being cut off
plt.show()
פרמטרים
נגדיר את פרמטרי האימון: 300 תקופות, קצב למידה 0.001 ורשימה ריקה שבה נאסוף את ההפסדים לציור גרף. מספר התקופות גדול בהרבה מבפרק הקודם, כי קבוצת האימון קטנה — 207 תמונות הן תשע אצוות בלבד, כלומר תשעה צעדי עדכון לתקופה:
epochs = 300
learning_rate = 0.001
losses = []
רשת הקונבולוציה
הרשת בנויה על אותה תבנית מהפרק הקודם — שתי קונבולוציות עם Pooling ואחריהן שכבות לינאריות — אך עם שני הבדלים. הראשון נובע מגודל התמונה: הקלט הוא 64×64 במקום 32×32, ולכן לפי הנוסחה שלמדנו הקונבולוציה הראשונה (מסנן 5) נותנת 60 וה־Pooling מקטין ל־30; הקונבולוציה השנייה נותנת 26 וה־Pooling מקטין ל־13. כך אחרי שתי הקונבולוציות וה־Pooling נשארים 16×13×13 ערכים לכל תמונה, 2,704 במקום 400, וזה המספר שחייב להופיע בקלט של fc1. ההבדל השני הוא בפלט: במקום עשרה ציונים ו־CrossEntropyLoss, הרשת מפיקה ערך יחיד ומעבירה אותו ב־Sigmoid, כי השאלה היא כן או לא. נעביר את הערכים לשכבות בגודל 120, 60 ו־1, עם Sigmoid בפלט:
class CNN_Model(nn.Module):
    def __init__(self):
        super(CNN_Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 13 * 13, 120)
        self.fc2 = nn.Linear(120, 60)
        self.fc3 = nn.Linear(60, 1)

    def forward(self, x):
        # -> n, 3, 64, 64
        x = self.pool(F.relu(self.conv1(x)))  # -> n, 6, 30, 30
        x = self.pool(F.relu(self.conv2(x)))  # -> n, 16, 13, 13
        x = x.view(-1, 16 * 13 * 13)          # -> n, 2704
        x = F.relu(self.fc1(x))               # -> n, 120
        x = F.relu(self.fc2(x))               # -> n, 60
        x = self.fc3(x)                       # -> n, 1
        x = torch.sigmoid(x)
        return x
ניצור את המודל ונעביר אותו להתקן:
Model = CNN_Model().to(device)
מכיוון שהפלט הוא הסתברות יחידה אחרי Sigmoid, פונקציית ההפסד המתאימה היא BCELoss, כמו בסיווג הבינארי שהכרנו. נגדיר אותה ואת האופטימייזר Adam:
Loss = nn.BCELoss()
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון
נעדכן את הרשת לאורך אצוות האימון ונשמור את ההפסדים לצורך מעקב. תחילה נחשב את מספר האצוות בתקופה, שישמש למספור הצעדים בהדפסה:
n_total_steps = len(train_loader)
בכל אצווה נעביר את התמונות והתוויות להתקן, נחשב תחזיות, נאפס גרדיאנטים, נחשב הפסד ונגזרות ונעדכן את המשקלים:
for epoch in range(epochs):
    for i, (images, lables) in enumerate(train_loader):

        images = images.to(device)
        lables = lables.to(device)

        # forward
        Y_predict = Model(images)

        # backward
        optim.zero_grad()
        loss = Loss(Y_predict, lables)
        loss.backward()
        losses.append(loss.item())

        if i % 10 == 0:
            print(f"epoch= {epoch} i= {i+epoch * n_total_steps} loss={loss.item():.4f} ")

        # update wights
        optim.step()
תחילת הפלט וסופו, בדילוג על שורות הביניים:
פלט
epoch= 0 i= 0 loss=0.6934
epoch= 1 i= 9 loss=0.6880
...
epoch= 299 i= 2691 loss=0.0000
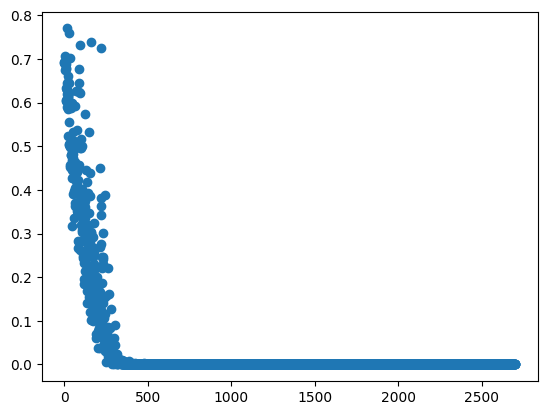
ההפסד ההתחלתי, כ־0.69, הוא הערך של BCELoss כשהרשת מנחשת 0.5 לכל תמונה, כלומר אינה יודעת עדיין דבר (ln 2 ≈ 0.69). בסוף 300 התקופות ההפסד מתאפס בעיגול לארבע ספרות — הרשת מסווגת נכון את כל תמונות האימון. הלוג מציג את הפסד האצווה הראשונה בכל תקופה, כי i % 10 == 0 מתקיים רק עבור i = 0 כשיש תשע אצוות; הרשימה losses שומרת את הפסדי כל האצוות.
שמירת המודל
300 תקופות של קונבולוציה לוקחות זמן, ולא נרצה לחזור עליהן אם סביבת הריצה תתאפס. נשמור את המודל המאומן כולו, כפי שלמדנו בפרק ג.20:
torch.save(Model,'model.pth')
גרף ההפסד
הדפסה של שורה לתקופה מראה רק חלק קטן מהתמונה. נציג את כל ההפסדים שנשמרו במהלך האימון, נקודה לכל אצווה, וכך נראה את מגמת הירידה ואת התנודות בין אצווה לאצווה:
plt.plot(losses, 'o')
plt.show()
בדיקת המודל
עכשיו השאלה החשובה: האם הרשת למדה לזהות חתולים, או רק שיננה את 207 תמונות האימון? נחשב תחזיות על 52 תמונות הבדיקה, שהרשת לא ראתה מעולם; ערך גדול מ־0.5 מסווג כחתול:
with torch.no_grad():
    n_correct = 0
    n_samples = 0
    for images, lables in test_loader:
        images = images.to(device)
        lables = lables.to(device)
        y_predict = Model(images)
        y_predict = y_predict > 0.5
        n_samples += lables.size(0)
        n_correct += (y_predict == lables).sum().item()

    acc = 100 * n_correct / n_samples
    print(f'Accuracy of the network on the {n_samples} test images: {acc} %')
פלט
Accuracy of the network on the 52 test images: 78.84615384615384 %
הרשת מסווגת נכון כ־79% מתמונות הבדיקה. זה הרבה יותר מניחוש, אבל רחוק מהפסד האפס שראינו באימון — שוב הפער שפגשנו ב־Pima בין שינון להכללה. הסיבה העיקרית כאן היא כמות הנתונים: 207 תמונות אימון הן מעט מאוד ללימוד מושג מורכב כמו "חתול", בזוויות, צבעים ורקעים שונים. במאגר כה קטן כדאי גם לזכור שכל תמונת בדיקה שווה כמעט 2% מהדיוק, ולכן המספר עצמו אינו מדויק במיוחד.
הצגת תחזיות לצד התוויות
נציג 40 תמונות מקבוצת האימון, עם התווית האמיתית והתחזית של הרשת. התאמה מסומנת בירוק וטעות באדום. שימו לב שהתחזית מחושבת על ההתקן ומוחזרת ל־CPU באמצעות .cpu() לפני ההצגה:
with torch.no_grad():
    dataiter = iter(train_loader)
    fig = plt.figure(figsize=(15, 10)) # Increased figure height further
    fig.suptitle('Model Predictions vs. True Labels (Training Data)', fontsize=16)
    for i in range(4):
        images, labels = next(dataiter)
        images_gpu = images.to(device)
        y_predict = Model(images_gpu).cpu()
        y_predict = y_predict > 0.5
        for j in range(10):
            ax = fig.add_subplot(4, 10, i * 10 + j + 1)
            ax.imshow((images[j].permute(1,2,0).numpy()*255).astype(np.intp))
            ax.axis('off')
            # Display both true and predicted labels
            true_label = int(labels[j].item())
            predicted_label = int(y_predict[j].item())
            label_color = 'green' if true_label == predicted_label else 'red'
            ax.text(0.5, -0.20, f"True: {true_label}\nPred: {predicted_label}",
                    color=label_color, transform=ax.transAxes, ha='center', va='top', fontsize=10) # Adjusted y-position slightly higher
    plt.tight_layout(rect=[0, 0.07, 1, 0.95]) # Adjusted bottom margin to give more space
    plt.show()
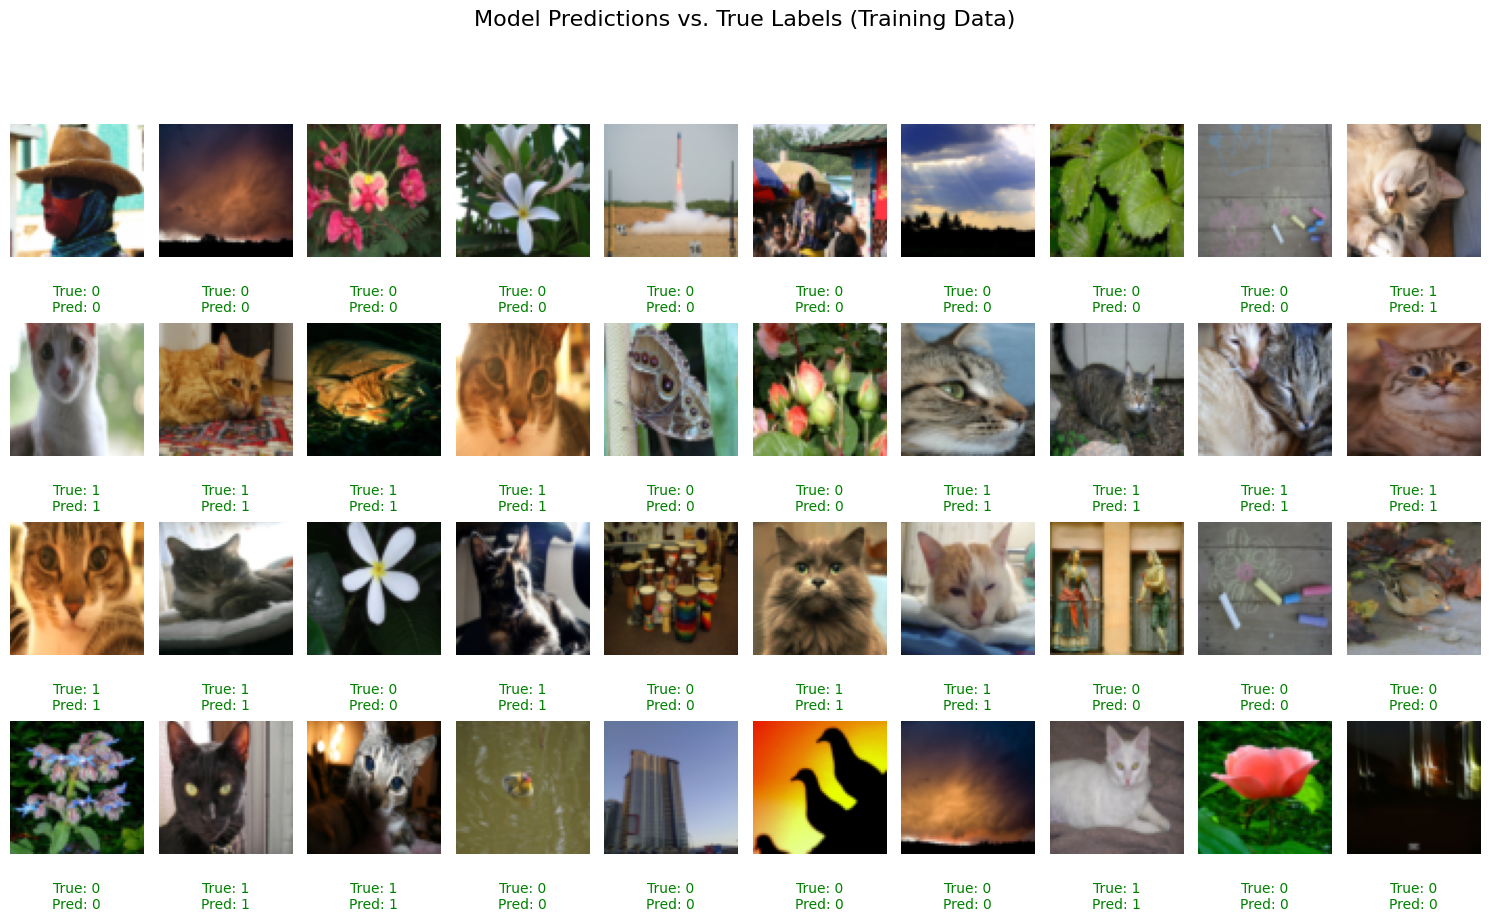
אלה תמונות אימון, ולכן אין להתרשם מהצלחה עליהן: הרשת כבר ראתה אותן והגיעה עליהן להפסד אפס. התצוגה מועילה כדי לוודא שהצינור כולו — טעינה, סידור צירים, נרמול ותחזית — עובד נכון, אך היא אינה מחליפה את בדיקת הדיוק על 52 תמונות הבדיקה. כתרגיל, נסו להריץ את אותו קוד על test_loader ולראות אילו תמונות הרשת מסווגת לא נכון.