ג.16 סיווג בינארי של בגדים ואותיות
בפרק ג.13 בנינו רשת שמזהה ספרה אחת מתוך תמונות של ספרות. הרשת, לולאת האימון ודרך הבדיקה לא היו מיוחדות לספרות: הן קיבלו תמונה של 28×28 פיקסלים והחזירו הסתברות לתשובה "כן". פרק זה הוא פרק תרגול, שבו נראה שאותו פתרון בדיוק עובד גם על תמונות מסוגים אחרים ועל שאלות אחרות. זהו שלב חשוב בלמידת מכונה: ברגע שיש בידינו תבנית עבודה, אפשר ליישם אותה על בעיות חדשות בשינויים קטנים בלבד.
ניישם סיווג בינארי בשני מאגרי תמונות: תחילה נזהה שמלה במאגר Fashion-MNIST, מאגר של תמונות פריטי לבוש הבנוי באותה צורה כמו MNIST, ולאחר מכן נבחין בין ספרה לאות במאגר EMNIST, שמכיל גם אותיות בכתב יד. בשני המקרים למאגר יש תוויות רבות — עשרה סוגי לבוש, או 62 תווים — ואנו מצמצמים אותן לשאלת כן/לא אחת, כפי שעשינו עם הספרה 7. בדרך נראה שני דברים חדשים: מאגר שדורש עיבוד מקדים של התמונות, וכלל שונה להפיכת התוויות לבינאריות.
השאלה המלאה — לאיזו מעשר הקטגוריות שייך הפריט, או איזה מ־62 התווים מופיע בתמונה — דורשת שכבת פלט ופונקציית הפסד אחרות, ואותן נכיר בפרק הבא.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: מצגת רשת נוירונים ANN (עותק מקומי) · Fashion-MNIST — תרגיל (עותק מקומי) · Fashion-MNIST — פתרון (עותק מקומי) · EMNIST — תרגיל (עותק מקומי) · EMNIST — פתרון (עותק מקומי)
Fashion-MNIST — ייבוא ובחירת התקן
נתחיל בהכנת סביבת החישוב למודל שיבחין בין שמלה לשאר פריטי הלבוש. הייבוא זהה לזה של פרק ג.13: PyTorch, Torchvision לטעינת התמונות ו־Matplotlib להצגתן.
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt
import torchvision
import torchvision.transforms as transforms
נבחר GPU אם הוא זמין, ואחרת CPU:
if torch.cuda.is_available():
    device = torch.device('cuda')
else:
    device = torch.device('cpu')
print(device)
טעינת נתוני הבגדים
Fashion-MNIST נוצר במכוון כתחליף ל־MNIST: אותו מספר תמונות, אותו גודל 28×28 בגוני אפור ואותן עשר קטגוריות, אלא שבמקום ספרות יש פריטי לבוש. לכן הטעינה זהה, ורק שם המחלקה מתחלף. נטען את קבוצות האימון והבדיקה ונמיר את התמונות לטנסורים באמצעות ToTensor, שגם מנרמלת את ערכי הפיקסלים ל־0–1:
train_dataset = torchvision.datasets.FashionMNIST(root='./data',
                                           train=True,
                                           transform=transforms.ToTensor(),
                                           download=True)

test_dataset = torchvision.datasets.FashionMNIST(root='./data',
                                          train=False,
                                          transform=transforms.ToTensor(),
                                          download=True)
נציג את פרטי המאגרים כדי לוודא שהטעינה הצליחה:
print(train_dataset)
print(test_dataset)
פלט
Dataset FashionMNIST
    Number of datapoints: 60000
    Root location: ./data
    Split: Train
    StandardTransform
Transform: ToTensor()
Dataset FashionMNIST
    Number of datapoints: 10000
    Root location: ./data
    Split: Test
    StandardTransform
Transform: ToTensor()
כמו ב־MNIST, 60,000 תמונות לאימון ו־10,000 לבדיקה. ב־MNIST התווית הייתה הספרה עצמה, אך כאן התווית היא מספר מ־0 עד 9 שמייצג סוג פריט, ולכן נדפיס את שמות הקטגוריות כדי לדעת איזה מספר מייצג מה:
print(f'Class names: {train_dataset.classes}')
for number, name in enumerate(train_dataset.classes):
    print(f"Class Number: {number}, Class Name: {name}")
פלט
Class names: ['T-shirt/top', 'Trouser', 'Pullover', 'Dress', 'Coat', 'Sandal', 'Shirt', 'Sneaker', 'Bag', 'Ankle boot']
Class Number: 0, Class Name: T-shirt/top
Class Number: 1, Class Name: Trouser
Class Number: 2, Class Name: Pullover
Class Number: 3, Class Name: Dress
Class Number: 4, Class Name: Coat
Class Number: 5, Class Name: Sandal
Class Number: 6, Class Name: Shirt
Class Number: 7, Class Name: Sneaker
Class Number: 8, Class Name: Bag
Class Number: 9, Class Name: Ankle boot
הרשימה classes ממפה כל מספר לשם: 0 היא חולצת טי, 1 מכנסיים, וכן הלאה. את השמלה, שאותה נזהה, מייצג המספר 3.
אצוות ותמונות לדוגמה
כמו ב־MNIST, המאגר גדול מכדי להעביר אותו ברשת בבת אחת, ולכן נחלק אותו לאצוות באמצעות DataLoader. נגדיר אצוות של 50 תמונות, עם ערבוב בקבוצת האימון בלבד:
batch_size = 50

train_loader = torch.utils.data.DataLoader(dataset=train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True)

test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle=False)
נבדוק את מספר האצוות:
print(len(train_loader))
print(len(test_loader))
פלט
1200
200
כצפוי, 1,200 אצוות אימון ו־200 אצוות בדיקה — בדיוק כמו ב־MNIST. לפני האימון נסתכל על הנתונים: נשלוף את האצווה השנייה (הקריאה הראשונה ל־next שולפת את הראשונה, והשנייה את זו שאחריה), נציג תשעה פריטים עם שם הקטגוריה שלהם בכותרת, ונדפיס גם שורת פיקסלים:
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data, example_targets = next(examples)

for i in range(9):
    plt.subplot(3,3,i+1)
    plt.title (train_dataset.classes[example_targets[i].item()])
    plt.imshow(example_data[i][0], cmap='gray')
    print(example_targets[i].item(), example_data[i].shape)

plt.show()
print(example_data[8][0][10])
פלט
4 torch.Size([1, 28, 28])
4 torch.Size([1, 28, 28])
5 torch.Size([1, 28, 28])
8 torch.Size([1, 28, 28])
2 torch.Size([1, 28, 28])
2 torch.Size([1, 28, 28])
8 torch.Size([1, 28, 28])
4 torch.Size([1, 28, 28])
8 torch.Size([1, 28, 28])
פלט
tensor([0.0000, 0.0000, 0.0000, 0.0588, 0.9843, 0.8039, 0.7961, 0.8353, 0.8275,
        0.8078, 0.8196, 0.8235, 0.8353, 0.8314, 0.8314, 0.8392, 0.8353, 0.8392,
        0.8471, 0.8392, 0.8314, 0.8196, 0.8392, 0.8275, 0.8235, 0.8235, 0.9020,
        0.2431])
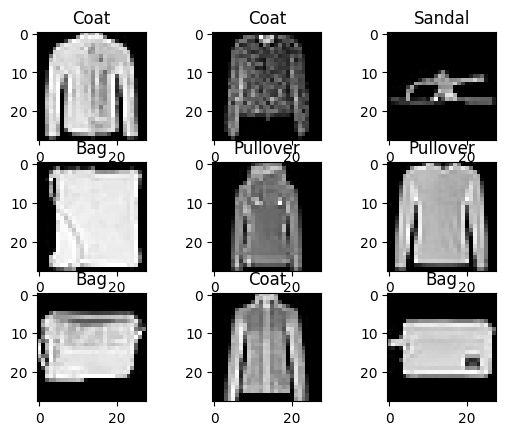
שורת הפיקסלים שונה מזו שראינו בספרות: במקום כמה פיקסלים בהירים על רקע שחור, יש כאן רצף ארוך של ערכים סביב 0.8 — פריט לבוש ממלא חלק גדול מהתמונה, ולרשת יש הרבה יותר פיקסלים "מוארים" להתבסס עליהם.
בחירת המשימה ומבנה הרשת
כעת נגדיר את השאלה הבינארית ואת הרשת. נבחר את תווית 3 — שמלה; ההדפסה מאשרת שהמספר אכן מייצג Dress. הרשת תכלול 784 קלטים, שתי שכבות חבויות של 200 ו־100 יחידות ופלט אחד. לעומת רשת הספרות, שהייתה בעלת שכבה חבויה אחת של 100 יחידות, כאן הרשת עמוקה ורחבה יותר, כי פריטי לבוש מגוונים יותר בצורתם מספרות. נאמן שלושה אפוקים בקצב למידה 0.01.
input_size = 784 # 28x28
hidden_size1 = 200
hidden_size2 = 100
output_size = 1
epochs = 3
learning_rate = 0.01
required_label = 3
print (train_dataset.classes[required_label])
פלט
Dress
נגדיר את הרשת לפי התבנית המוכרת — שכבות לינאריות עם ReLU ביניהן, ו־Sigmoid בפלט היחיד שמחזיר את ההסתברות לשמלה:
Model = nn.Sequential(
    nn.Linear(input_size,hidden_size1,device=device),
    nn.ReLU(),
    nn.Linear(hidden_size1,hidden_size2,device=device),
    nn.ReLU(),
    nn.Linear(hidden_size2, 1, device=device),
    nn.Sigmoid()
)
התשובה בינארית, ולכן נגדיר BCE כפונקציית ההפסד ואופטימייזר Adam:
Loss = nn.BCELoss()
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון — שמלה או לא שמלה
לולאת האימון זהה לזו של פרק ג.13. בכל אצווה נשטח את התמונות לצורה [50, 784] וניצור תווית 1 עבור שמלה ו־0 עבור שאר הפריטים, באמצעות השוואת התווית המקורית ל־required_label.
n_total_steps = len(train_loader)
for epoch in range(epochs):
    for i, (images, lables) in enumerate(train_loader):

        # origin shape: [50, 1, 28, 28]
        # resized: [50, 784]
        images = images.reshape(-1, 28*28).to(device)
        lables = lables.reshape(-1,1).to(device)
        lables = (torch.eq(lables, required_label)).float()


        # forward
        Y_predict = Model(images)

        # backward
        loss = Loss(Y_predict, lables)
        loss.backward()

        # update wights
        optim.step()

        if (i + epoch * n_total_steps) % 100 == 0:
            print(f"epoch= {epoch} i= {i} num= {i+epoch * n_total_steps} loss={loss.item():.4f} ")

        # zero grads
        optim.zero_grad()
תחילת הפלט השמור וסופו:
פלט
epoch= 0 i= 0 num= 0 loss=0.6926
epoch= 0 i= 100 num= 100 loss=0.0097
epoch= 0 i= 200 num= 200 loss=0.0658
epoch= 0 i= 300 num= 300 loss=0.1033
...
epoch= 2 i= 1100 num= 3500 loss=0.0225
ההפסד ההתחלתי, 0.6926, הוא בערך מה שמצפים מרשת שעדיין לא למדה דבר ומחזירה כ־0.5 לכל תמונה; הוא יורד במהירות, ובסוף האפוק השלישי הוא 0.0225. הפלטים הם דוגמאות שמורות ועשויים להשתנות בהרצה חדשה.
בדיקת המודל והצגת תחזיות
נעבור על תמונות הבדיקה, נמיר את התוויות באותו כלל בינארי, נעגל את פלט הרשת ונחשב את שיעור הסיווגים הנכונים:
with torch.no_grad():
    n_correct = 0
    n_samples = 0
    for images, lables in test_loader:
        images = images.reshape(-1, 28*28).to(device)
        lables = lables.reshape(-1,1).to(device)
        lables = (torch.eq(lables, required_label)).float()
        y_predict = Model(images).round()
        # print(y_predict.T)
        # print(lables.T)

        n_samples += lables.size(0)
        n_correct += (y_predict == lables).sum().item()

    acc = 100 * n_correct / n_samples
    print(f'Accuracy of the network on the {n_samples} test images: {acc} %')
פלט
Accuracy of the network on the 10000 test images: 96.89 %
הדיוק, 96.89%, נמוך מעט מ־99.21% שהשגנו בזיהוי הספרה 7. זה סביר: שמלה דומה לעיתים לחולצה או למעיל, ואילו הספרה 7 נבדלת היטב משאר הספרות.
כדי לראות את התנהגות הרשת על תמונות בודדות, נשלוף את האצווה הראשונה ונדפיס לכל פריט את ההסתברות, הקטגוריה המקורית וההחלטה הבינארית:
print(len(test_loader))
print (n_samples)
print(lables.shape)
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data = example_data.to(device)
example_targets = example_targets.to(device)
with torch.no_grad():
    example_predict = Model(example_data.reshape(-1, 28*28)).T #.round()
example_predict.shape
for i in range(len(example_data)):
    print (example_predict[0,i].item(), example_targets[i].item(), round(example_predict[0,i].item()) )
תחילת הפלט השמור וסופו:
פלט
200
10000
torch.Size([50, 1])
3.8038247885490236e-28 9 0
...
0.00022870743123348802 2 0
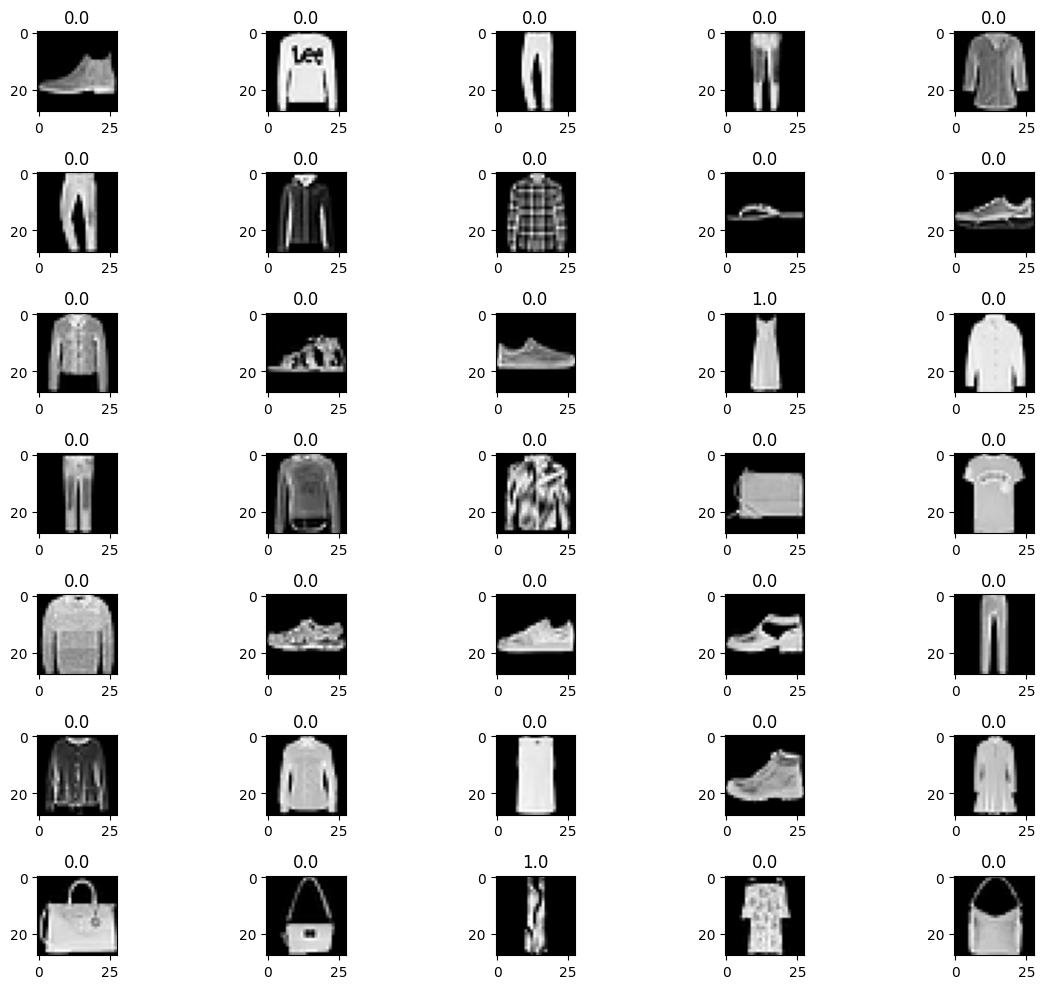
בשורה הראשונה, למשל, פריט מקטגוריה 9 (מגף) קיבל הסתברות זעירה להיות שמלה, וההחלטה היא 0 — נכון.
נציג 35 תמונות עם הסיווג הבינארי בכותרת. הטנסור המודפס הוא וקטור ההחלטות של כל 50 התמונות באצווה, ובו רק שתי תמונות סווגו כשמלה:
predict = example_predict.round().reshape(-1)
print(predict)
plt.figure(figsize=(12, 10))  # Adjust the figure size
for i in range(35):
    plt.subplot(7,5,i+1)

    plt.title (train_dataset.classes[example_targets[i].item()])
    plt.title(predict[i].item())
    plt.imshow(example_data[i][0].cpu(), cmap='gray')
    print(example_targets[i].item(), example_data[i].shape)
plt.tight_layout()
plt.show()
תחילת הפלט השמור וסופו:
פלט
tensor([0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 1., 0., 0., 0., 0.,
        0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 1., 0., 0., 0.,
        0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0.],
       device='cuda:0')
...
8 torch.Size([1, 28, 28])
EMNIST — ספרה או אות
הדוגמה השנייה שונה בשני היבטים. ראשית, השאלה הבינארית אינה "האם זו קטגוריה מסוימת" אלא "האם התמונה שייכת לקבוצה של קטגוריות" — ספרה (עשר קטגוריות) לעומת אות (52 קטגוריות). שנית, המאגר גדול בהרבה ודורש עיבוד מקדים. EMNIST הוא הרחבה של MNIST הכוללת גם אותיות בכתב יד, והוא מגיע בכמה חלוקות; נעבור למאגר byclass, הכולל ספרות ואותיות גדולות וקטנות, ובסך הכול 62 תווים. נייבא את הספריות ונבחר התקן:
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms
import matplotlib.pyplot as plt
הפעם נבחר את ההתקן בשורה אחת, בעזרת ביטוי תנאי — אותה בחירה בכתיב קצר יותר:
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print("Device:", device)
טעינת EMNIST ותיקון כיוון התמונות
תמונות EMNIST שמורות במאגר כשהן מסובבות ומשוקפות, ואם נטען אותן כמו שהן, התווים יופיעו שוכבים על הצד. כדי שהתמונות יוצגו בכיוון הרצוי, נתאים את כיוונן בזמן הטעינה. עד כה השתמשנו בהמרה אחת, ToTensor; הפעם נשרשר כמה המרות באמצעות transforms.Compose, שמפעילה אותן בזו אחר זו על כל תמונה: נמיר לטנסור, נשקף (flip) ונסובב ב־90 מעלות (rot90). נשתמש באותו עיבוד בשתי קבוצות הנתונים:
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Lambda(lambda x: x.flip(2)),
    transforms.Lambda(lambda x: torch.rot90(x, 1, [1, 2]))  # 90° CCW
])

train_dataset = torchvision.datasets.EMNIST(
    root="./data",
    split="byclass",
    train=True,
    transform=transform,
    download=True
)

test_dataset = torchvision.datasets.EMNIST(
    root="./data",
    split="byclass",
    train=False,
    transform=transform,
    download=True
)

print(train_dataset)
print(test_dataset)
פלט
Dataset EMNIST
    Number of datapoints: 697932
    Root location: ./data
    Split: Train
    StandardTransform
Transform: Compose(
               ToTensor()
               Lambda()
               Lambda()
           )
Dataset EMNIST
    Number of datapoints: 116323
    Root location: ./data
    Split: Test
    StandardTransform
Transform: Compose(
               ToTensor()
               Lambda()
               Lambda()
           )
המאגר גדול פי עשרה ויותר מקודמיו: 697,932 תמונות אימון ו־116,323 תמונות בדיקה. גם ההדפסה מראה את שלוש ההמרות שהוגדרו ב־Compose.
אצוות ומיפוי התוויות
נארגן את התמונות בקבוצות ונבדוק כיצד מספרי התוויות שלהן מייצגים את התווים.
נגדיר אצוות של 64 תמונות. עם מאגר גדול כל כך, גם מספר האצוות גדול:
batch_size = 64

train_loader = torch.utils.data.DataLoader(
    dataset=train_dataset,
    batch_size=batch_size,
    shuffle=True
)

test_loader = torch.utils.data.DataLoader(
    dataset=test_dataset,
    batch_size=batch_size,
    shuffle=False
)

print(len(train_loader), len(test_loader))
פלט
10906 1818
10,906 אצוות אימון ו־1,818 אצוות בדיקה, לעומת 1,200 ו־200 בשני המאגרים הקודמים; לכן כל אפוק יארך כאן הרבה יותר זמן.
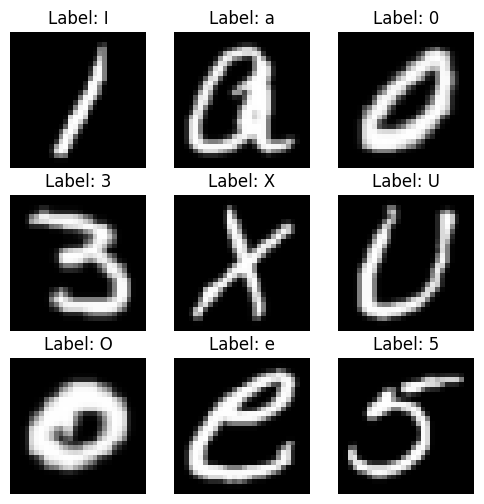
התוויות במאגר הן מספרים מ־0 עד 61: 0–9 מציינות ספרות, 10–35 אותיות גדולות ו־36–61 אותיות קטנות. הסדר הזה הוא שיאפשר לנו בהמשך להגדיר את השאלה הבינארית בפשטות. כדי להציג את התו עצמו ולא את מספרו, נגדיר פונקציה להמרת התווית לתו, בעזרת chr ו־ord שמתרגמים בין תו לקוד שלו:
def emnist_label_to_char(label: int) -> str:
    """
    Convert an EMNIST 'byclass' numeric label to its corresponding character.

    EMNIST byclass mapping:
    0–9   -> '0'–'9'
    10–35 -> 'A'–'Z'
    36–61 -> 'a'–'z'
    """
    if 0 <= label <= 9:
        return chr(ord('0') + label)
    elif 10 <= label <= 35:
        return chr(ord('A') + (label - 10))
    elif 36 <= label <= 61:
        return chr(ord('a') + (label - 36))
    else:
        raise ValueError(f"Invalid EMNIST byclass label: {label}")
נציג תשע תמונות מהאצווה הראשונה של קבוצת הבדיקה עם התווים המקוריים בכותרת. כך נוודא גם שתיקון הכיוון עבד והתווים קריאים:
examples = iter(test_loader)
example_data, example_targets = next(examples)

plt.figure(figsize=(6,6))
for i in range(9):
    plt.subplot(3,3,i+1)
    plt.imshow(example_data[i][0], cmap="gray")
    plt.title(f"Label: {emnist_label_to_char(example_targets[i].item())}")
    plt.axis("off")
plt.show()
הגדרת הרשת והאימון
התמונות הן באותו גודל של 28×28, ולכן הרשת יכולה להישאר כפי שהייתה. נגדיר 784 קלטים, שתי שכבות חבויות של 200 ו־100 יחידות, חמישה מעברים וקצב למידה 0.001 — קצב נמוך יותר מבעבר, שמתאים לאימון ארוך על מאגר גדול:
input_size = 28 * 28
hidden_size1 = 200
hidden_size2 = 100
epochs = 5
learning_rate = 0.001
הרשת זהה לזו של Fashion-MNIST — פלט יחיד עם Sigmoid, כי גם כאן השאלה בינארית:
Model = nn.Sequential(
    nn.Linear(input_size, hidden_size1, device=device),
    nn.ReLU(),
    nn.Linear(hidden_size1, hidden_size2, device=device),
    nn.ReLU(),
    nn.Linear(hidden_size2, 1, device=device),
    nn.Sigmoid()
)
וכך גם פונקציית ההפסד והאופטימייזר:
Loss = nn.BCELoss()
optimizer = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון — ספרה 1, אות 0
בכל צעד אימון נתרגם את תוויות התווים לשאלה הבינארית: האם התמונה מציגה ספרה או אות?
כאן ההבדל היחיד מהדוגמאות הקודמות. עד כה השווינו את התווית לערך אחד (torch.eq), ואילו הפעם התנאי labels < 10 הופך את התוויות לבינאריות: כל תווית של ספרה (0–9) הופכת ל־1, וכל תווית של אות (10 ומעלה) הופכת ל־0. הפלט היחיד מציין אם התמונה היא ספרה, ולא איזו ספרה או אות היא. שימו לב שכאן zero_grad נקרא לפני backward, ולא בסוף הצעד; שתי הדרכים שקולות, ובלבד שהנגזרות מאופסות לפני כל חישוב חדש.
n_total_steps = len(train_loader)

for epoch in range(epochs):
    for i, (images, labels) in enumerate(train_loader):

        # flatten images
        images = images.reshape(-1, 28*28).to(device)

        # binary labels:
        # digit (0–9)  -> 1
        # letter (>=10) -> 0
        labels = labels.to(device)
        labels = (labels < 10).float().view(-1, 1)

        # forward
        outputs = Model(images)
        loss = Loss(outputs, labels)

        # backward
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        if (i + epoch * n_total_steps) % 200 == 0:
            print(f"epoch={epoch} step={i} loss={loss.item():.4f}")
תחילת הפלט השמור וסופו:
פלט
epoch=0 step=0 loss=0.6922
epoch=0 step=200 loss=0.3900
epoch=0 step=400 loss=0.4345
epoch=0 step=600 loss=0.4177
...
epoch=4 step=10776 loss=0.1791
ההפסד יורד כאן לאט יותר מאשר בדוגמאות הקודמות — מ־0.6922 לכ־0.4 אחרי מאות אצוות, ול־0.1791 בסוף האפוק החמישי. המשימה קשה יותר: יש תווים שקשה להבחין ביניהם גם לעין אנושית, כמו הספרה 0 והאות O, או הספרה 1 והאות l.
בדיקת המודל
נשתמש באותו כלל תוויות גם בבדיקה, ונחשב את הדיוק על כל 116,323 תמונות הבדיקה. Model.eval() מעביר את הרשת למצב בדיקה, כפי שראינו בפרק הקודם:
Model.eval()
with torch.no_grad():
    n_correct = 0
    n_samples = 0

    for images, labels in test_loader:
        images = images.reshape(-1, 28*28).to(device)

        labels = labels.to(device)
        labels = (labels < 10).float().view(-1, 1)

        preds = Model(images).round()

        n_samples += labels.size(0)
        n_correct += (preds == labels).sum().item()

    acc = 100 * n_correct / n_samples
    print(f"Test Accuracy: {acc:.2f}%")
פלט
Test Accuracy: 90.93%
הדיוק, 90.93%, נמוך משני המאגרים הקודמים, מהסיבות שהזכרנו. זו תוצאה סבירה לרשת פשוטה על משימה שגם בני אדם טועים בה לעיתים.
הצגת התחזיות
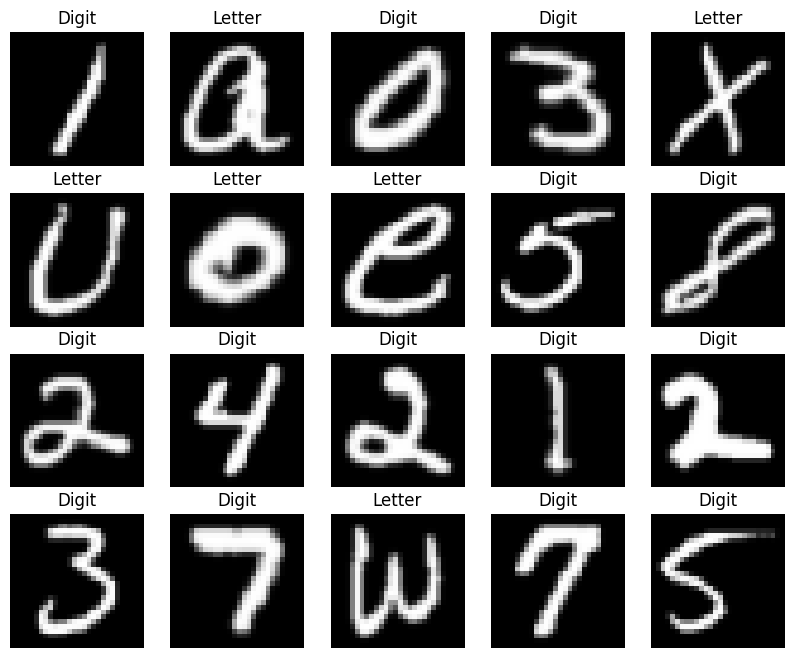
לסיום נציג 20 תמונות מהאצווה הראשונה של קבוצת הבדיקה, עם הכיתוב Digit או Letter לפי החלטת המודל. הכותרת מציגה את החלטת הרשת בלבד, ואפשר להשוות אותה בעין לתו שמופיע בתמונה:
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data = example_data.to(device)

with torch.no_grad():
    probs = Model(example_data.reshape(-1, 28*28))
    preds = probs.round().view(-1)

plt.figure(figsize=(10,8))
for i in range(20):
    plt.subplot(4,5,i+1)
    plt.imshow(example_data[i][0].cpu(), cmap="gray")
    title = "Digit" if preds[i].item() == 1 else "Letter"
    plt.title(title)
    plt.axis("off")
plt.show()