ג.12 רגרסיה לוגית ופונקציות אקטיבציה
בכל הפרקים עד כה המודל שלנו ענה על שאלה מסוג "כמה?": כמה שווה הדירה, כמה גבוה יהיה הילד. אבל רבות מהשאלות שאנו רוצים שמחשב יענה עליהן הן שאלות של כן או לא. האם ההודעה הזו היא ספאם? האם הלקוח יחזיר את ההלוואה? האם בתמונה יש חתול? האם הגידול שנמצא בבדיקה ממאיר או שפיר? האם הפרח הזה הוא מהמין המסוים שמחפשים? בכל אחת מהשאלות האלה יש קלט — טקסט, נתונים פיננסיים, תמונה, מדידות רפואיות — והתשובה היא אחת משתי אפשרויות בלבד. שאלה כזו נקראת סיווג בינארי — Binary Classification, ושתי התשובות האפשריות נקראות קטגוריות או תוויות — Labels, ומסומנות ב־0 וב־1.
מה בעצם ההבדל מרגרסיה? ברגרסיה הפלט הוא מספר על ציר רציף, וכל ערך הוא תשובה אפשרית. בסיווג יש רק שתי תשובות, ואם המודל יחזיר "0.7 ממאיר" זה חסר משמעות. ובכל זאת, במקום להמציא מודל חדש נעשה דבר פשוט: ניקח את אותו מודל לינארי שכבר יש לנו, ונגרום לו להחזיר מספר בין 0 ל־1 שנפרש כהסתברות שהתשובה היא "כן". הסתברות 0.97 פירושה "כמעט בטוח כן", 0.03 פירושה "כמעט בטוח לא", ו־0.5 פירושה שהמודל אינו יודע. כדי להחליט, נעגל: מעל 0.5 נסווג כ־1, ומתחת — כ־0. השיטה הזו נקראת רגרסיה לוגית — Logistic Regression, ולמרות שמה זהו אלגוריתם סיווג; השם נובע מכך שהיא בנויה על אותו חישוב לינארי של הרגרסיה.
כדי להפוך את פלט המודל הלינארי, שיכול להיות כל מספר, להסתברות בין 0 ל־1, נזדקק לרכיב חדש: פונקציה שמופעלת על התוצאה ו"מועכת" אותה לטווח הרצוי. זו הפעם הראשונה שנפגוש פונקציית אקטיבציה, רכיב שנמצא בלב כל רשת נוירונים ושילווה אותנו עד סוף הספר. גם פונקציית ההפסד תשתנה: MSE מתאים למדידת מרחק בין מספרים, אך למדידת טעות בהסתברויות יש פונקציה מתאימה יותר. אחרי ההסבר העקרוני נבנה שני מסווגים אמיתיים: אחד שמבחין בין גידולים ממאירים לשפירים לפי מדידות רפואיות, ואחד שמזהה מין של פרח לפי מידות עליו.
כעת נעבור מחיזוי מספר לסיווג דוגמה לאחת משתי קטגוריות. נכיר פונקציות אקטיבציה ונראה כיצד משלבים אותן במודל ובפונקציית ההפסד.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 7. רגרסיה לוגית (עותק מקומי) · 7. רגרסיה לוגית - אקטיבציה (עותק מקומי) · 7_Logic_regression (עותק מקומי) · Iris (עותק מקומי)
המודל הלינארי
נזכיר תחילה את נקודת המוצא. המודל שבנינו עד כה מחשב כפל וחיבור: כל קלט X מוכפל במשקל שלו (W), ומחברים את המכפלות (ובדרך כלל גם הטיה, שנשמיט כאן לשם הפשטות). עבור שלושה קלטים החישוב הוא:
WᵀX = X₁ × W₁ + X₂ × W₂ + X₃ × W₃
הסימון WᵀX הוא הדרך המקוצרת לכתוב את הסכום הזה: מכפלה של וקטור המשקלים בווקטור הקלטים. לאחר חישוב הפלט מחשבים את ההפסד, ובעזרת הנגזרות מעדכנים את המשקלים. התוצאה של החישוב הזה יכולה להיות כל מספר — שלילי, אפס או גדול מאוד — וזה בדיוק מה שאינו מתאים לשאלת כן/לא.
פרספטרון ופונקציית אקטיבציה
הפתרון הוא להוסיף שלב אחד אחרי החישוב הלינארי. כדי להוסיף חישוב לא־לינארי, מפעילים על תוצאת החישוב הלינארי פונקציה נוספת, הנקראת פונקציית אקטיבציה ומסומנת ב־σ. תחילה מחשבים WᵀX, אחר כך מפעילים את האקטיבציה, ולבסוף מחשבים את ההפסד. יחידה כזו — סכום משוקלל של קלטים ואחריו פונקציית אקטיבציה — נקראת פרספטרון — Perceptron, והיא הנוירון המלאכותי הבסיסי. רשת נוירונים, שנכיר בפרק הבא, אינה אלא הרבה פרספטרונים כאלה המחוברים זה לזה. השם "אקטיבציה" (הפעלה) לקוח מהנוירון הביולוגי, ש"נדלק" רק כשהגירוי שהוא מקבל חזק מספיק.
פונקציות אקטיבציה
יש כמה פונקציות אקטיבציה מקובלות, וכל אחת מתאימה למטרה אחרת; ההבדל העיקרי ביניהן הוא טווח הערכים שהן מחזירות. פונקציות אקטיבציה משנות את תוצאת החישוב הלינארי בדרכים שונות. נכיר את צורת הפעולה וטווח הערכים של כמה מהן. בטבלה z מסמן את תוצאת החישוב הלינארי, כלומר את WᵀX.
| פונקציה | הפעולה |
|---|---|
| Sigmoid | מחזירה ערך בין 0 ל־1: 1 / (1 + exp(-z)) |
| Tanh | מחזירה ערך בין −1 ל־1: (exp(z) - exp(-z)) / (exp(z) + exp(-z)) |
| ReLU | מחזירה את z כאשר הוא חיובי, ואפס אחרת |
| Leaky ReLU | מחזירה את z כאשר הוא חיובי, ו־a כפול z אחרת; בדוגמה a=0.2 |
Sigmoid ו־Tanh "מועכות" כל מספר לטווח קבוע וחסום, ולכן מתאימות לפלט שצריך להתפרש כהסתברות או כערך מנורמל. ReLU ו־Leaky ReLU פשוטות בהרבה ואינן חוסמות ערכים חיוביים; הן משמשות בעיקר בתוך רשתות נוירונים, כפי שנראה בפרקים הבאים. קיימת גם פונקציית Softmax, שאותה נלמד בהמשך.
Sigmoid וסיווג בינארי
לשאלת כן/לא מתאימה במיוחד Sigmoid, כי הפלט שלה נמצא תמיד בין 0 ל־1 ואפשר לקרוא אותו כהסתברות. נשתמש ב־Sigmoid כאשר התשובה היא אחת משתי קטגוריות, המסומנות ב־0 וב־1. הפונקציה מחזירה ערך בין 0 ל־1: מעל 0.5 נסווג כ־1, ומתחת ל־0.5 נסווג כ־0. עבור קלט 0 הפונקציה מחזירה 0.5. ככל שהקלט z חיובי וגדול יותר, הפלט מתקרב ל־1; ככל שהוא שלילי יותר, הפלט מתקרב ל־0. כך המודל הלינארי "מצביע" בעד או נגד, ו־Sigmoid מתרגמת את עוצמת ההצבעה להסתברות.
פונקציית ההפסד
אחרי שהמודל מחזיר הסתברות, צריך למדוד עד כמה היא טעתה. בוחרים את פונקציית ההפסד בהתאם למשימה ולפלט של המודל. בסיווג הבינארי שנבנה כאן נשתמש ב־Sigmoid וב־Binary Cross Entropy, ובסיווג למספר קטגוריות נפגוש Cross Entropy. הטבלה הבאה מסכמת אילו זוגות של אקטיבציה והפסד הולכים יחד:
| פונקציית אקטיבציה | פונקציית הפסד |
|---|---|
| Sigmoid | Binary Cross Entropy |
| Softmax | Categorical Cross Entropy |
| ReLU | Mean Squared Error במשימת רגרסיה מתאימה |
| Tanh | Mean Squared Error במשימת רגרסיה מתאימה |
| Leaky ReLU | Mean Squared Error במשימת רגרסיה מתאימה |
פלט Tanh עשוי להיות שלילי, ולכן אינו מתאים ישירות ל־BCE, המקבלת הסתברויות בין 0 ל־1.
כל הפונקציות האלה זמינות ב־PyTorch כרכיבים מוכנים בספריית torch.nn, ואפשר לשלב אותן במודל בדיוק כמו nn.Linear:
| אקטיבציה | פונקציית ההפסד |
|---|---|
nn.Sigmoid() |
nn.BCELoss() |
nn.Softmax(dim=1) להצגת הסתברויות |
nn.CrossEntropyLoss() מקבלת את הציונים שלפני Softmax |
nn.ReLU() |
nn.MSELoss() במשימת רגרסיה מתאימה |
nn.Tanh() |
nn.MSELoss() במשימת רגרסיה מתאימה |
nn.LeakyReLU() |
nn.MSELoss() במשימת רגרסיה מתאימה |
Binary Cross Entropy — BCE
מדוע לא להמשיך עם MSE? אפשר, אך כשהפלט הוא הסתברות יש מדד טבעי יותר: במקום לשאול "כמה רחוק המספר מהתשובה", שואלים "איזו הסתברות המודל נתן לתשובה הנכונה", ומענישים קשה במיוחד מודל שהיה בטוח בתשובה שגויה. BCE היא פונקציית הפסד לבדיקת הטעות בשאלות בינאריות. נסמן את התשובה האמיתית ב־y ואת ההסתברות שמחזיר המודל ב־p:
BCE = −mean(y × log(p) + (1 − y) × log(1 − p))
הנוסחה נראית מסובכת, אך למעשה בכל דוגמה רק אחד משני האיברים "פעיל". כאשר y=0, האיבר הראשון מתאפס ונשאר −log(1−p). כאשר y=1, האיבר השני מתאפס ונשאר −log(p). הממוצע (mean) מחושב על כל הדוגמאות, כמו ב־MSE.
כדי להבין את ההתנהגות נזכור ש־log של 1 הוא 0, ו־log של מספר שמתקרב לאפס שואף למינוס אינסוף. עבור תשובה אמיתית 1, ההפסד מתקרב לאפס כאשר p מתקרב ל־1, וגדל ללא גבול כאשר p מתקרב לאפס. עבור תשובה אמיתית 0, ההפסד מתקרב לאפס כאשר p מתקרב לאפס, וגדל ללא גבול כאשר p מתקרב ל־1. במילים אחרות: ניחוש נכון ובטוח כמעט אינו נענש, ניחוש שגוי ובטוח נענש בחומרה, וניחוש הססני (p קרוב ל־0.5) נענש במידה בינונית. זה בדיוק מה שרוצים מפונקציית הפסד לסיווג.
דוגמת Breast Cancer — טעינת הנתונים
אחרי שהכרנו את הרכיבים — מודל לינארי, Sigmoid ו־BCE — נחבר אותם לפתרון של בעיה אמיתית. המאגר Breast Cancer מכיל מדידות של גידולים, ולכל גידול ידוע אם הוא ממאיר או שפיר. השאלה שנשאל את המודל היא בדיוק שאלת כן/לא: לפי המדידות, האם הגידול ממאיר? נבנה מודל לסיווג דוגמאות לשתי תוויות: ממאיר ושפיר. המאגר מכיל 569 דוגמאות, ובכל אחת 30 תכונות מספריות.
נייבא את הספריות:
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
נטען את המאגר ונציג את שמות הקטגוריות, צורות המערכים ודוגמאות מהנתונים:
bc = datasets.load_breast_cancer()
X, y = bc.data, bc.target
print ("target_names",bc.target_names)
print ("X, y",X.shape, y.shape)
print (X[0:5])
print (y)
תחילת הפלט השמור:
פלט
target_names ['malignant' 'benign']
X, y (569, 30) (569,)
התווית 0 מציינת malignant והתווית 1 מציינת benign. נציג גם את תיאור המאגר:
print (bc.DESCR)
התיאור מפרט את התכונות, ובהן רדיוס, מרקם, היקף ושטח. התכונות חושבו מתמונות של דגימות שנלקחו במחט.
פיצול הנתונים ובניית טנסורים
כדי לדעת אם המודל באמת למד להכליל, ולא רק שינן את הדוגמאות שראה, נשמור חלק מהנתונים בצד ולא נשתמש בו באימון. את החלק הזה, נתוני הבדיקה — Test, נבחן רק בסוף. נחלק את הנתונים באקראי ל־80% אימון ו־20% בדיקה. נמיר את המערכים לטנסורים ואת התשובות לעמודה:
n_samples, n_features = X.shape
X_train_np, X_test_np, y_train_np, y_test_np = train_test_split (X,y, test_size=0.2, random_state = 2)

X_train = torch.from_numpy(X_train_np.astype(np.float32))
X_test = torch.from_numpy(X_test_np.astype(np.float32))

y_train = torch.from_numpy(y_train_np.astype(np.float32))
y_test = torch.from_numpy(y_test_np.astype(np.float32))

y_train = y_train.view(-1,1)
y_test = y_test.view(-1,1)
נציג את הצורות:
print (X_train.shape, y_train.shape)
print (X_test.shape, y_test.shape)
פלט
torch.Size([455, 30]) torch.Size([455, 1])
torch.Size([114, 30]) torch.Size([114, 1])
נרמול הנתונים
התכונות במאגר נמדדות בסולמות שונים מאוד: שטח יכול להגיע למאות ואלפים, ואילו מדדי צורה הם שברים קטנים מ־1. כפי שראינו בפרק הנרמול, הפרשי סולם כאלה מקשים על האימון ועלולים לגרום להתבדרות, ולכן ננרמל. כדי לנרמל כל תכונה לפי הערכים שלה, נחשב גדלים לכל עמודה בנפרד. נתחיל בחישוב מקסימום בכל עמודה:
t = torch.tensor([
    [4, 6, 3, 7, 9],
    [4, 2, 6, 9, 1]])

print(t.max(dim=0))
פלט
torch.return_types.max(
values=tensor([4, 6, 6, 9, 9]),
indices=tensor([0, 0, 1, 1, 0]))
נחשב את פרמטרי הנרמול מנתוני האימון ונגדיר את שתי הפונקציות:
max,__ = X_train.max(dim=0)
min, __ = X_train.min(dim=0)

def Normalize_minMax(X):
    return (X - min) / (max - min)

mean = X_train.mean(dim=0)
std = X_train.std(dim=0)

def Normalize_z(X):
    return (X - mean) / std

print (max.shape, min.shape)
print (mean.shape, std.shape)
פלט
torch.Size([30]) torch.Size([30])
torch.Size([30]) torch.Size([30])
נשתמש ב־Min–Max עבור שתי הקבוצות, עם אותם מינימום ומקסימום:
X_train = Normalize_minMax(X_train)
X_test = Normalize_minMax(X_test)
# X_train = Normalize_z(X_train)
# X_test = Normalize_z(X_test)
print (X_train[0:5])
print (X_train.max(dim=0))
פלט
tensor([[0.3346, 0.5898, 0.3289, 0.1938, 0.4212, 0.2769, 0.1045, 0.2139, 0.1975,
         0.2566, 0.0916, 0.2501, 0.1004, 0.0430, 0.1884, 0.1795, 0.0682, 0.3976,
         0.1573, 0.2007, 0.2622, 0.5637, 0.2480, 0.1282, 0.3495, 0.1932, 0.1059,
         0.3610, 0.1636, 0.1839],
        [0.1964, 0.2337, 0.1844, 0.1008, 0.2607, 0.0463, 0.0321, 0.0681, 0.1837,
         0.2516, 0.0109, 0.1341, 0.0099, 0.0054, 0.1418, 0.0246, 0.0309, 0.1513,
         0.1470, 0.0675, 0.1334, 0.2204, 0.1192, 0.0580, 0.2102, 0.0339, 0.0366,
         0.1393, 0.1972, 0.1026],
        [0.5774, 0.4322, 0.5785, 0.4261, 0.2943, 0.3707, 0.2610, 0.3366, 0.3203,
         0.1164, 0.1174, 0.1575, 0.1449, 0.0886, 0.1296, 0.2566, 0.0891, 0.2985,
         0.0609, 0.1139, 0.5489, 0.5341, 0.5777, 0.3693, 0.4030, 0.5169, 0.3087,
         0.5884, 0.4020, 0.2430],
        [0.3232, 0.4748, 0.3301, 0.1927, 0.7192, 0.4763, 0.3650, 0.4561, 0.5788,
         0.5296, 0.1641, 0.3469, 0.1485, 0.0858, 0.2417, 0.2120, 0.1024, 0.3156,
         0.1454, 0.1644, 0.4009, 0.7950, 0.3889, 0.2379, 1.0000, 0.4789, 0.3711,
         0.6934, 0.7153, 0.3506],
        [0.1878, 0.3936, 0.1943, 0.0965, 0.6326, 0.3055, 0.2446, 0.2818, 0.3887,
         0.4093, 0.0453, 0.2360, 0.0502, 0.0190, 0.2159, 0.1105, 0.0854, 0.2535,
         0.0525, 0.0977, 0.1747, 0.6215, 0.1833, 0.0808, 0.7907, 0.2353, 0.3213,
         0.4905, 0.3441, 0.2682]])
torch.return_types.max(
values=tensor([1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.,
        1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.]),
indices=tensor([ 39, 354,  39, 358, 241, 319, 289, 289,  53, 200,  39,  35,  39, 358,
        238, 208,  83,  11, 319, 286, 358, 146, 358, 358,   3, 276,  83, 189,
        433, 276]))
הגדרת המודל, ההפסד והאופטימייזר
נבנה מודל שמפיק ערך בין 0 ל־1 לצורך הסיווג הבינארי. nn.Sequential מפעילה את השכבות לפי סדרן: שכבה לינארית בעלת 30 קלטים ופלט אחד, ואחריה Sigmoid. נגדיר BCE ואופטימייזר Adam, בקצב למידה 0.1 וב־1,000 צעדים.
learning_rate = 0.1
epochs = 1000
losses = torch.zeros(epochs) # tensor to save losses for print

# design model
Model = nn.Sequential(
        nn.Linear(30,1),
        nn.Sigmoid()
)

#construct loss and optimizer
Loss = nn.BCELoss()

# init optimizer
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
לולאת האימון
הלולאה נשארת כפי שהכרנו: חיזוי, חישוב הפסד ונגזרות, עדכון המשקלים ואיפוס הנגזרות.
for epoch in range(epochs):
    # forward
    y_predict = Model(X_train)

    # backward
    loss = Loss(y_predict, y_train)
    loss.backward()

    # update wights
    optim.step()
    losses[epoch]=loss.item()

    if epoch % 10 == 0:
        print(f"epoch= {epoch} loss={loss.item():.4f} ")

    # zero grads
    optim.zero_grad()
שורות ראשונות ואחרונה מתוך הפלט השמור:
פלט
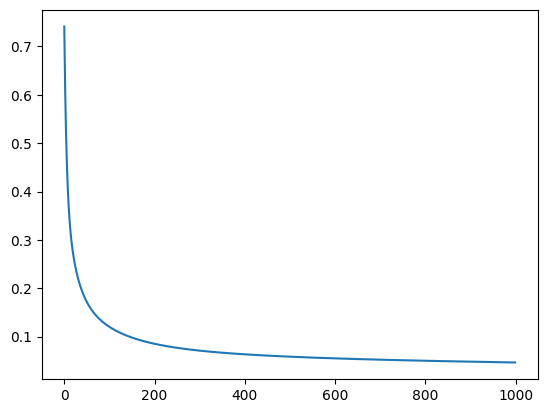
epoch= 0 loss=0.7413
epoch= 10 loss=0.3653
epoch= 20 loss=0.2684
...
epoch= 990 loss=0.0466
נציג את ההפסד לאורך האימון:
plt.plot(losses.detach())
plt.show()
בדיקת המודל
ההפסד יורד, אבל המדד שבאמת מעניין אותנו הוא כמה מהגידולים המודל מסווג נכון — ובעיקר על נתונים שלא ראה באימון. המודל מחזיר הסתברות, ולכן כדי לקבל תשובה של כן/לא נקבע סף: הסתברות מעל 0.5 תיחשב 1, ומתחתיו 0. נחשב תחזיות על נתוני הבדיקה, נעגל אותן ל־0 או ל־1 ונחשב את שיעור הסיווגים הנכונים — מדד שנקרא דיוק — Accuracy. round() מעגלת גם ערך של 0.5 בדיוק ל־0.
with torch.no_grad():
    y_predicted = Model(X_test)
    y_predicted_bin = y_predicted.round()
    accuracy = y_predicted_bin.eq(y_test).sum() / float(y_test.shape[0])
    print (f'accuracy = {accuracy:.4f}')

print(y_test.shape)
print(y_predicted_bin.shape)
פלט
accuracy = 0.9649
torch.Size([114, 1])
torch.Size([114, 1])
הפלטים הם דוגמאות שמורות; האתחול האקראי עשוי לשנות את התוצאה בהרצה חדשה.
נציג זו לצד זו את ההסתברות, התווית החזויה והתווית האמיתית:
print ("predicted, test \n", torch.cat((y_predicted,y_predicted_bin, y_test), dim=1))
שורות ראשונות ואחרונה מתוך הפלט השמור:
פלט
predicted, test
 tensor([[9.9294e-01, 1.0000e+00, 1.0000e+00],
        [5.5413e-01, 1.0000e+00, 1.0000e+00],
...
        [1.8337e-05, 0.0000e+00, 0.0000e+00]])
דוגמה נוספת — Iris
כדי לראות שאותו מתכון עובד גם על נתונים מסוג אחר, נחזור עליו על מאגר קטן ומפורסם, Iris, שבו כל דוגמה היא פרח ולא גידול. במאגר יש שלושה מיני פרחים, אבל בפרק זה נהפוך את השאלה לשאלת כן/לא: האם הפרח שייך למין מסוים או לא. סיווג לשלוש קטגוריות בבת אחת יחכה לפרק ג.18. נבצע סיווג בינארי גם בנתוני הפרחים. נתחיל בטעינת המאגר ובבחינת התכונות והתוויות שלו.
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
iris = datasets.load_iris()
data, targets = iris.data, iris.target

print(iris.DESCR)
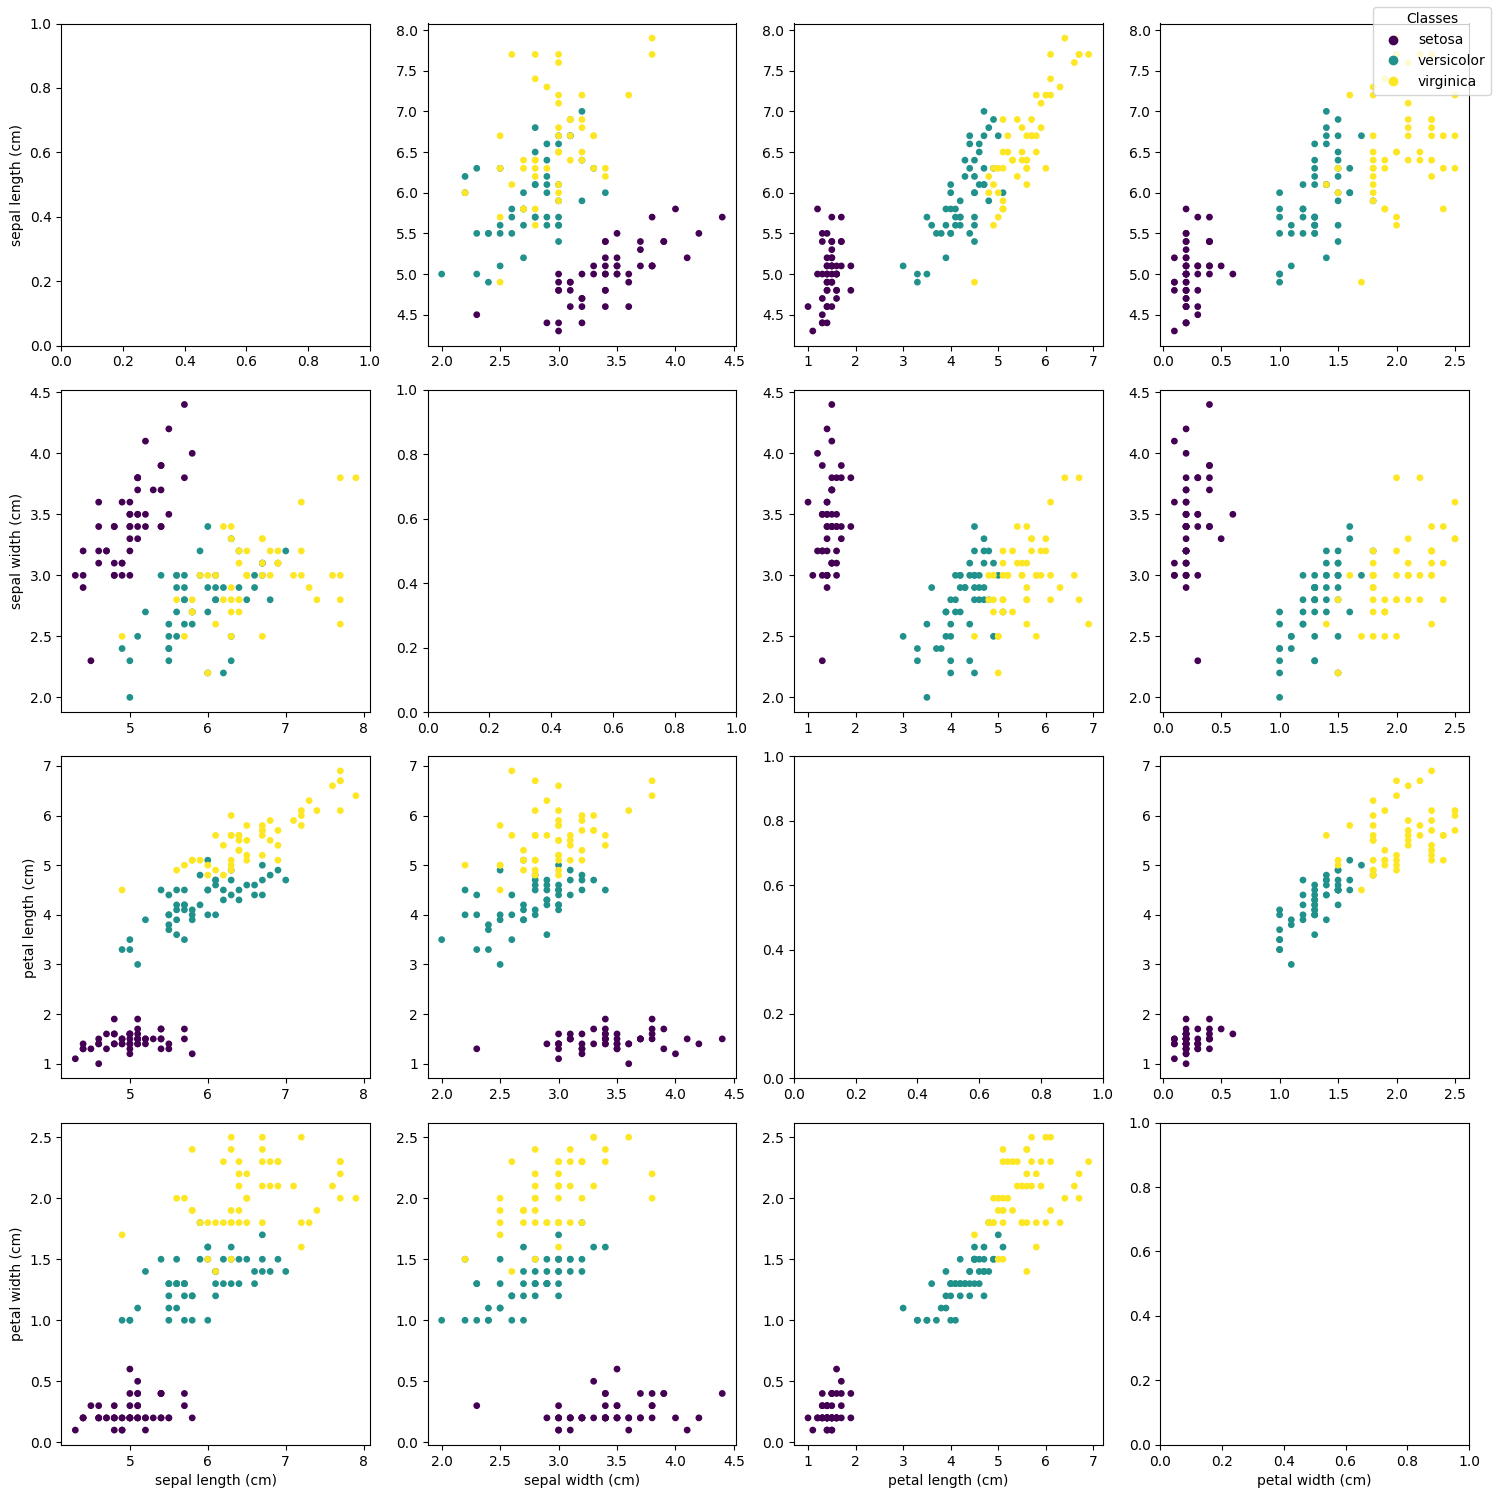
המאגר מכיל 150 פרחים משלושה מינים, ולכל פרח ארבע מדידות: אורך ורוחב של עלי הגביע ושל עלי הכותרת, בסנטימטרים.
print ("target_names",iris.target_names)
print ("X, y",data.shape, targets.shape)
print(data[0:5],'\n', targets)
פלט
target_names ['setosa' 'versicolor' 'virginica']
X, y (150, 4) (150,)
[[5.1 3.5 1.4 0.2]
 [4.9 3.  1.4 0.2]
 [4.7 3.2 1.3 0.2]
 [4.6 3.1 1.5 0.2]
 [5.  3.6 1.4 0.2]]
 [0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2 2
 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2
 2 2]
הצגת זוגות התכונות
נציג גרף לכל זוג תכונות, כשהצבעים מציינים את שלושת המינים המקוריים:
fig, axes = plt.subplots(4, 4, figsize=(15, 15))
features = iris.feature_names

for i in range(4):
    for j in range(4):
        ax = axes[i, j]
        # Plot scatter plots only on off-diagonal combinations
        if i != j:
            scatter = ax.scatter(data[:, j], data[:, i], c=iris.target, cmap='viridis', s=15)

        # Add labels to the outer edges of the grid
        if i == 3:
            ax.set_xlabel(features[j])
        if j == 0:
            ax.set_ylabel(features[i])

# Add a main legend to the figure
handles, labels = scatter.legend_elements()
fig.legend(handles, iris.target_names, loc='upper right', title="Classes")

plt.tight_layout()
plt.show()
מעבר לתוויות בינאריות
כדי להפוך את זיהוי שלושת המינים לשאלת כן/לא, נבחר מין אחד ונבדיל בינו לבין כל השאר. נגדיר 1 לפרח מסוג versicolor, שתוויתו המקורית היא 1, ו־0 לשאר הפרחים:
# Original logic:
# targets[targets == 0] = -1
# targets[targets != -1] = 0
# targets[targets == -1] = 1
targets = (targets == 1).astype(int)
print(targets)
פלט
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 0 0 0 0 0 0 0 0 0 0
 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
 0 0]
פיצול הנתונים ובניית טנסורים
נחלק ל־80% אימון ו־20% בדיקה ונמיר לטנסורים:
n_samples, n_features = data.shape
X_train_np, X_test_np, y_train_np, y_test_np = train_test_split (data,targets, test_size=0.2, random_state = 4)

X_train = torch.from_numpy(X_train_np.astype(np.float32))
X_test = torch.from_numpy(X_test_np.astype(np.float32))

y_train = torch.from_numpy(y_train_np.astype(np.float32))
y_test = torch.from_numpy(y_test_np.astype(np.float32))

y_train = y_train.view(-1,1)
y_test = y_test.view(-1,1)
print (X_train.shape, y_train.shape)
print (X_test.shape, y_test.shape)
פלט
torch.Size([120, 4]) torch.Size([120, 1])
torch.Size([30, 4]) torch.Size([30, 1])
נרמול Iris
נחשב מינימום ומקסימום מתוך קבוצת האימון ונשתמש בהם לנרמול שתי הקבוצות:
max_train,__ = X_train.max(dim=0)
min_train, __ = X_train.min(dim=0)

def Normalize_minMax(X):
    return (X - min_train) / (max_train - min_train)


print (max_train, min_train)
פלט
tensor([7.9000, 4.4000, 6.9000, 2.5000]) tensor([4.3000, 2.2000, 1.0000, 0.1000])
X_train = Normalize_minMax(X_train)
X_test = Normalize_minMax(X_test)
# X_train = Normalize_z(X_train)
# X_test = Normalize_z(X_test)
print (X_train[0:5])
max_val, max_idx = X_train.max(dim=0)
print (max_val, max_idx)
פלט
tensor([[0.3056, 0.3636, 0.5932, 0.5833],
        [0.0833, 0.4545, 0.0678, 0.0417],
        [0.6667, 0.1364, 0.8136, 0.7083],
        [0.1667, 0.3636, 0.0678, 0.0417],
        [0.1944, 0.0455, 0.3898, 0.3750]])
tensor([1., 1., 1., 1.]) tensor([102,  16,  22,   5])
המודל והאימון
נגדיר מודל עם ארבעה קלטים, Sigmoid ו־BCE. נשתמש ב־Adam בקצב 0.1 וב־1,000 צעדים:
learning_rate = 0.1
epochs = 1000
losses = [] # list to save losses for print

# design model
Model = nn.Sequential(
        nn.Linear(4,1),
        nn.Sigmoid()
)

#construct loss and optimizer
Loss = nn.BCELoss()

# init optimizer
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
for epoch in range(epochs):
    # forward
    y_predict = Model(X_train)

    # backward
    loss = Loss(y_predict, y_train)
    loss.backward()

    # update wights
    optim.step()
    losses.append(loss.item())

    if epoch % 10 == 0:
        print(f"epoch= {epoch} loss={loss.item():.4f} ")

    # zero grads
    optim.zero_grad()
שורות ראשונות ואחרונה מתוך הפלט השמור:
פלט
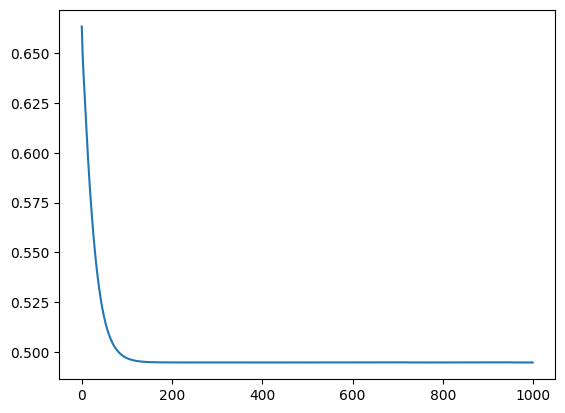
epoch= 0 loss=0.6635
epoch= 10 loss=0.6136
epoch= 20 loss=0.5757
...
epoch= 990 loss=0.4946
נציג את הפסד האימון:
plt.plot(losses)
plt.show()
בדיקת הסיווג ב־Iris
נחשב את שיעור הסיווגים הנכונים ונציג אותו באחוזים:
with torch.no_grad():
    y_predicted = Model(X_test)
    y_predicted_bin = y_predicted.round()
    accuracy = y_predicted_bin.eq(y_test).sum() / float(y_test.shape[0])
    print (f'accuracy = {accuracy*100:.4f}%')

print(y_test.shape)
print(y_predicted_bin.shape)
פלט
accuracy = 73.3333%
torch.Size([30, 1])
torch.Size([30, 1])
נציג את התווית החזויה לצד התווית האמיתית:
print ("predicted, test \n", torch.cat((y_predicted_bin, y_test), dim=1))
פלט
predicted, test
 tensor([[0., 0.],
        [0., 0.],
        [1., 0.],
        [1., 0.],
        [1., 0.],
        [0., 1.],
        [1., 1.],
        [0., 0.],
        [0., 0.],
        [1., 0.],
        [0., 0.],
        [0., 0.],
        [0., 0.],
        [1., 1.],
        [1., 0.],
        [0., 0.],
        [1., 1.],
        [0., 0.],
        [0., 0.],
        [1., 0.],
        [0., 0.],
        [0., 0.],
        [1., 1.],
        [0., 0.],
        [0., 0.],
        [0., 0.],
        [1., 0.],
        [0., 0.],
        [0., 0.],
        [0., 0.]])