ד.1 — מבוא ללמידת חיזוק
המצגת: מבוא ללמידת חיזוק (עותק מקומי)
בחלק ג בנינו מודלים שלומדים מדוגמאות: הראינו להם תמונות או נתונים מספריים לצד התשובה הנכונה, והם למדו לחקות אותה. אבל יש בעיות שבהן איש אינו יכול לתת לנו "תשובה נכונה" לכל מצב. איך מלמדים תוכנה לנצח במשחק איקס־עיגול, לנהוג במכונית או לשלוט ברובוט, כשאין טבלה שאומרת מהו המהלך הנכון בכל רגע? בשאלה הזאת עוסק חלק ד של הספר, והתשובה לה נקראת למידת חיזוק — Reinforcement Learning.
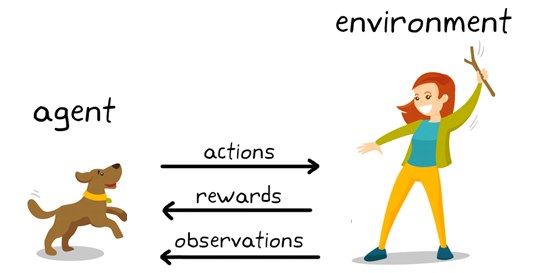
בלמידה מפוקחת נתנו למודל דוגמאות עם תשובות יעד. בלמידת חיזוק אין ליד כל מצב תשובה האומרת לסוכן איזה צעד עליו לבחור. במקום זאת יש סוכן — Agent (התוכנה שמקבלת החלטות) וסביבה — Environment (העולם שבו הוא פועל: המשחק, הכביש, החדר). הסוכן פועל, רואה מה קרה ומקבל משוב — תגמול — Reward. באמצעות התנסות חוזרת הוא לומד אילו בחירות מובילות לתוצאות טובות לאורך זמן, ולא רק ברגע הבא.
אפשר לחשוב על כלב הלומד התנהגות חדשה: הוא מנסה פעולה ומקבל תגמול בעקבות התנהגות רצויה. התגמול אינו רשימת הוראות לכל מצב; הוא מידע שממנו אפשר ללמוד. באופן דומה, סוכן במשחק מנסה מהלכים ומשתפר מתוך תוצאות המשחקים, גם כשלא נאמר לו מראש מהו המהלך הנכון.
ההבדל הזה משנה את כל דרך העבודה. בלמידה מפוקחת הטעות מחושבת מיד עבור כל דוגמה; בלמידת חיזוק התגמול עשוי להגיע רק בסוף — למשל ניצחון או הפסד אחרי עשרות מהלכים — והסוכן צריך להבין אילו מן המהלכים בדרך תרמו לתוצאה. בפרקים הבאים נבנה את הכלים לכך בהדרגה: תחילה נגדיר במדויק מהם מצב, פעולה, תגמול ומדיניות, אחר כך נלמד לחשב את המהלך הטוב ביותר כשחוקי המשחק ידועים לנו במלואם, ולבסוף נלמד מתוך ניסיון בלבד, בלי לדעת את החוקים מראש — עד לשילוב רשתות נוירונים בלמידת חיזוק.
המושגים והאלגוריתמים שנלמד בחלק זה מבוססים על הספר המרכזי בתחום. ספר לעיון נוסף הוא Reinforcement Learning: An Introduction, מהדורה שנייה, מאת Richard S. Sutton ו־Andrew G. Barto; מי שירצה להעמיק מעבר לחומר של הספר שלנו ימצא בו את הרקע המתמטי המלא.