א.24 — Pandas — טבלאות וניתוח נתונים
מערך NumPy מצוין למספרים, אבל נתונים אמיתיים נראים אחרת. גיליון של תלמידים מכיל שם (מחרוזת), גיל (מספר שלם), ממוצע (מספר ממשי) ועיר מגורים; לכל עמודה יש שם, ואנחנו רוצים לפנות אליה לפי השם ולא לפי מספר סידורי. ניסיון לדחוס טבלה כזאת למערך NumPy מסתבך מהר, כי למערך יש טיפוס אחד לכל האיברים ואין לו שמות עמודות. Pandas נבנתה בדיוק לצורך הזה: היא מוסיפה למערכים של NumPy שמות, תוויות ועמודות בטיפוסים שונים, ושומרת על כל הפעולות המהירות שהכרנו.
כשנתונים מתארים אנשים, מכוניות או תוצאות ניסוי, נוח לסדר אותם בטבלה: כל שורה היא רשומה וכל עמודה היא פרט מסוים. Pandas היא ספרייה לטעינה, לבחירה ולעיבוד של נתונים כאלה, בלי לכתוב לולאה נפרדת לכל עמודה.
נכיר שני מבנים: Series היא סדרת ערכים עם תוויות, ו־DataFrame היא טבלה של עמודות עם אינדקס לשורות. לעמודות שונות יכולים להיות טיפוסים שונים. אינדקס ב־Pandas אינו חייב להיות מספר סידורי או להיות ייחודי.
בלמידת מכונה טבלה כזאת נקראת מאגר נתונים — Dataset: כל שורה היא דוגמה שהמודל ילמד ממנה, וכל עמודה היא תכונה של הדוגמה או התשובה שרוצים לחזות. בחלק ג נטען כך טבלת גבהים של הורים וילדים ונחזה גובה, ונטען טבלת מדדים רפואיים ונחזה מחלה. כמעט כל פרויקט למידה מתחיל בטעינת טבלה, בבחירת העמודות הרלוונטיות ובסינון שורות בעייתיות, וזה מה שנלמד בחלקו הראשון של הפרק. בחלקו השני נטפל בערכים חסרים, נסכם תוצאות לפי קבוצות וניישם את הכלים על טבלה אמיתית של נוסעי הטיטאניק.
מחברות האוניברסיטה הפתוחה — 13 קבצים וחבילות
יוצרים Series
נתחיל במבנה הפשוט מבין השניים. Series דומה למערך חד־ממדי של NumPy, בתוספת אחת: לכל ערך יש תווית, כמו מפתח במילון. סדרה מאפשרת להצמיד תווית לכל ערך ולבחור אותו לפי התווית או לפי מיקומו. ניצור סדרה ממילון, שבו המפתחות הופכים לתוויות, ונראה את שתי דרכי הגישה. נייבא את Pandas בשם הקצר pd, כפי שנהוג.
import pandas as pd
s = pd.Series({"a": 100, "b": 200, "c": 300})
print(s.loc["b"])
print(s.iloc[1])
print(s.mean())
פלט
200
200
200.0
loc בוחרת לפי תווית; iloc לפי מיקום שמתחיל באפס. כאן שתי הבחירות מגיעות לאותו ערך, אבל מסיבות שונות: "b" היא התווית של הערך השני, ו־1 הוא מיקומו. הפלט השלישי מראה שסדרה יודעת לחשב על עצמה סיכומים כמו ב־NumPy, וכאן ממוצע שלושת הערכים הוא 200.0. אפשר ליצור סדרה גם מרשימה, ואז מתקבל אינדקס מספרי כברירת מחדל.
יוצרים DataFrame ממילון
כעת נעבור לטבלה שלמה. DataFrame הוא אוסף של סדרות שחולקות אותו אינדקס: כל עמודה היא Series, ושמות העמודות מאפשרים לפנות לכל אחת בשמה. כדי ליצור טבלה ממילון, נשתמש בכל מפתח כשם עמודה וברשימה המתאימה לו כערכי העמודה. רשימות אלה צריכות להיות באותו אורך, כי כל מיקום ברשימות מייצג שורה אחת — כאן אדם אחד עם שם, גיל ועיר.
data = {
    "Name": ["Alice", "Bob", "Charlie"],
    "Age": [25, 30, 35],
    "City": ["New York", "Los Angeles", "Chicago"]
}
people = pd.DataFrame(data)
print(people["Age"].tolist())
print(people.shape)
פלט
[25, 30, 35]
(3, 3)
people["Age"] בוחרת את עמודת הגילים, ו־tolist() ממירה אותה לרשימת פייתון רגילה לצורך ההדפסה. shape מחזירה מספר שורות ומספר עמודות, כמו ב־NumPy: שלושה אנשים ושלוש עמודות. בחירה בשם עמודה יחיד מחזירה Series; בחירה ברשימת שמות, כגון people[["Name", "Age"]], מחזירה טבלה.
שורות ותוויות
בטבלה שיצרנו השורות ממוספרות 0, 1, 2, אבל בדרך כלל יש לרשומה מזהה טבעי יותר: שם התלמיד, מספר הנוסע או תאריך. נוח לפנות לשורה לפי המזהה הזה במקום לזכור באיזה מיקום היא נמצאת. אפשר לבחור עמודה שתשמש לזיהוי השורות, ואז לפנות לשורה לפי התווית שלה. הבחירה לפי מיקום נשארת אפשרות נפרדת. בדוגמה נהפוך את עמודת השמות לאינדקס, ונשלוף את הגיל של Bob לפי שמו:
named = people.set_index("Name")
print(named.loc["Bob", "Age"])
print(people.iloc[0]["Name"])
פלט
30
Alice
set_index בוחרת עמודה כאינדקס ומחזירה טבלה חדשה; people המקורית לא השתנתה, ולכן בשורה השלישית עדיין אפשר לגשת אליה לפי מיקום עם iloc[0] ולקבל את השורה הראשונה, ומתוכה את השם. ב־named.loc["Bob", "Age"] הארגומנט הראשון הוא תווית השורה והשני הוא שם העמודה. reset_index מחזירה את התוויות לעמודה ואת האינדקס למספרים; drop=True מוותרת על שמירת האינדקס הישן. חיתוך מיקומים ב־iloc אינו כולל את הגבול האחרון; חיתוך תוויות ב־loc כולל בדרך כלל גם את תווית הסיום.
סינון ועדכון
שאלות כמו „מי מעל גיל 30?” או „אילו נוסעים שרדו?” הן לב העבודה עם נתונים, ובלמידת מכונה הן משמשות לבחירת הדוגמאות שנאמן עליהן. סינון מאפשר לבחור רק את הרשומות שעומדות בתנאי, ובהמשך לעדכן נתונים נבחרים. המנגנון זהה לזה שלמדנו ב־NumPy: השוואה של עמודה למספר יוצרת מסכה בוליאנית — סדרה של True ו־False, ערך לכל שורה. משתמשים בה לבחירת השורות שבהן התנאי מתקיים. בהמשך הדוגמה נוסיף גם עמודה חדשה, שמחושבת מעמודה קיימת בפעולה אחת על כל השורות:
selected = people[people["Age"] >= 30]
print(selected["Name"].tolist())
people["NextAge"] = people["Age"] + 1
print(people["NextAge"].tolist())
פלט
['Bob', 'Charlie']
[26, 31, 36]
רק Bob ו־Charlie בני 30 ומעלה, ולכן רק הם נבחרו. ההשמה people["NextAge"] = ... יוצרת עמודה חדשה בשם NextAge, שכל ערך בה גדול באחד מהגיל באותה שורה. לחיבור תנאים על עמודות משתמשים ב־& או ב־|, עם סוגריים סביב כל תנאי. and ו־or אינן מחברות מסכות שלמות. לפעמים רוצים לא רק לבחור שורות, אלא לשנות ערך בעמודה מסוימת רק בשורות שעומדות בתנאי. עדכון ממוקד נכתב בפעולת loc אחת: תנאי לשורות, ואחריו שם העמודה. בדוגמה נמיין גם את הטבלה לפי גיל, מהגדול לקטן:
people.loc[people["Age"] >= 30, "City"] = "Updated"
ordered = people.sort_values("Age", ascending=False)
print(ordered["Name"].tolist())
פלט
['Charlie', 'Bob', 'Alice']
sort_values("Age", ascending=False) מסדרת את השורות לפי עמודת הגיל בסדר יורד, ולכן Charlie, המבוגר ביותר, מופיע ראשון. drop מסירה שורה לפי תווית, או עמודות באמצעות columns. פעולות רבות מחזירות טבלה חדשה; שומרים אותה בהשמה אם רוצים להמשיך איתה.
טעינה ושמירה של CSV
עד כאן בנינו את הטבלה בקוד, אבל במציאות הנתונים מגיעים מקובץ: מאגרי נתונים ללמידת מכונה מופצים כמעט תמיד כקובצי CSV — קובץ טקסט פשוט שבו כל שורה היא רשומה והערכים מופרדים בפסיקים (Comma-Separated Values). כל גיליון אלקטרוני יודע לייצא לפורמט הזה, ו־Pandas יודעת לקרוא אותו בשורה אחת. כדי לשמור טבלה לשימוש בהרצה אחרת, נכתוב אותה לקובץ CSV. לאחר מכן נטען את הקובץ בחזרה לטבלה.
path = "/content/people.csv"
people.to_csv(path, index=False)
loaded = pd.read_csv(path)
print(loaded.shape)
פלט
(3, 4)
כעת יש ארבע עמודות, כולל NextAge. index=False מונעת הוספת אינדקס השורות כעמודה בקובץ. כשטוענים קובץ שלא אנחנו יצרנו, הצעד הראשון הוא להציץ בו ולהבין מה יש בו, ול־Pandas יש לכך כמה פעולות מוכנות. לאחר טעינה, head() ו־tail() מציגות שורות מתחילת הטבלה ומסופה; info() מציגה טיפוסים ומספר ערכים שאינם חסרים, ו־describe() מסכמת עמודות מספריות. מריצים info() ישירות: היא כבר מדפיסה את המידע.
מנתונים שבנינו בקוד לנתונים אמיתיים
עד כאן למדנו לבנות טבלה, לבחור ממנה עמודות ושורות ולטעון אותה מקובץ. אבל נתונים שנאספו בעולם האמיתי כמעט אף פעם אינם נקיים. ברשימת נוסעי ספינה, למשל, לחלק מהנוסעים לא נרשם הגיל; בטבלת דירות יש מחירים שהוקלדו כטקסט; ובסקר יש שורות כפולות. אם נזין טבלה כזאת כמו שהיא למודל למידת מכונה, הוא ילמד מהשגיאות לא פחות מאשר מהנתונים, ולעיתים פשוט ייכשל, כי חישוב עם ערך חסר מחזיר ערך חסר.
טבלה שנקראת מקובץ אינה בהכרח מוכנה לניתוח. ייתכן שחסרים בה ערכים, שהעמודות מכילות טיפוסים לא מתאימים, או שהשאלה דורשת להשוות בין קבוצות. נלמד לבדוק את הנתונים, לבחור טיפול מפורש בחסרים ולסכם תוצאות.
שלב ההכנה הזה נקרא לעיתים ניקוי נתונים, והוא תופס חלק גדול מזמנו של מי שעוסק בלמידת מכונה — לרוב יותר מבניית המודל עצמו. השלב השני, סיכום לפי קבוצות, עוזר לנו להבין את הנתונים לפני שמאמנים עליהם: אילו הבדלים באמת קיימים בין קבוצות, ומה המודל צפוי ללמוד. נתחיל בטבלה זעירה שבה רואים כל ערך, ואז ניישם את אותם כלים על טבלה אמיתית של כמעט תשע מאות נוסעים.
מתחילים מטבלה קטנה
נבנה טבלה של שלושה ציונים בשתי קבוצות, שבה ציון אחד לא נרשם. בקוד מסמנים נתון חסר ב־None, ו־Pandas מציגה אותו כ־NaN (Not a Number). ערך חסר אומר שהנתון אינו ידוע; הוא אינו שקול לאפס: תלמיד שלא נבחן אינו תלמיד שקיבל אפס. השאלה הראשונה שנשאל היא כמה ערכים חסרים יש בכל עמודה. isna() מסמנת חסרים ו־sum() סופרת אותם בכל עמודה.
data = pd.DataFrame({
    "Group": ["A", "A", "B"],
    "Score": [80, None, 100]
})
print(data["Score"].isna().sum())
print(data["Score"].mean())
פלט
1
90.0
בעמודה Score חסר ערך אחד. הממוצע מחושב מהערכים הקיימים: (80 + 100) / 2 = 90, ו־Pandas מדלגת על החסר בעצמה. כעת צריך להחליט מה לעשות עם הרשומה החסרה, ויש שתי אפשרויות עיקריות. נחליט אם להסיר רשומה באמצעות dropna, או למלא בעזרת fillna. הסרה פשוטה, אבל מאבדת גם את שאר הנתונים של אותה רשומה; מילוי שומר את הרשומה, אבל ממציא ערך. מילוי בממוצע אינו נתון שנמדד, ויש להבין כיצד הוא משפיע על המסקנות. בדוגמה נמלא את החסר בממוצע העמודה, על עותק של הטבלה כדי לשמור על המקור:
filled = data.copy()
filled["Score"] = filled["Score"].fillna(
    filled["Score"].mean())
print(filled["Score"].tolist())
פלט
[80.0, 90.0, 100.0]
הערך החסר הוחלף ב־90.0, ממוצע שני הציונים הידועים. יש גם דרכי מילוי אחרות: ffill מעתיקה את הערך הקודם ו־bfill את הבא. משתמשים בהן רק אם לסדר הרשומות יש משמעות שמצדיקה זאת, ולא כהשלמה אוטומטית לכל טבלה.
קיבוץ — groupby
עד עכשיו חישבנו ממוצע של עמודה שלמה. אבל שאלות מעניינות על נתונים הן כמעט תמיד השוואתיות: האם קבוצה A הצליחה יותר מקבוצה B? האם נוסעים במחלקה הראשונה שרדו יותר? כדי להשוות קבוצות בטבלה, נחשב סיכום נפרד לכל קבוצה. groupby מחלקת רשומות לקבוצות לפי ערכי עמודה. אחריה בוחרים עמודה מספרית ופעולת סיכום. התוצאה היא סדרה שבה התוויות הן שמות הקבוצות, ולכן ניגשים אליה עם loc:
means = filled.groupby("Group")["Score"].mean()
print(means.loc["A"])
print(means.loc["B"])
פלט
85.0
100.0
קבוצה A מכילה שני ציונים, 80 ו־90 שמילאנו, ולכן הממוצע שלה 85.0; קבוצה B מכילה ציון אחד, 100. שימו לב שהמילוי שביצענו קודם משפיע ישירות על התוצאה כאן: לו הסרנו את הרשומה החסרה, ממוצע קבוצה A היה 80. value_counts סופרת הופעות של כל ערך; count סופרת ערכים שאינם חסרים. תמיד בדקו מה נספר ומאיזו טבלה חושבה התוצאה.
דוגמת המחברת — Titanic
כעת נעבור מטבלה של שלוש שורות לטבלה אמיתית. רשימת נוסעי הטיטאניק היא אחד ממאגרי הנתונים המפורסמים ביותר ללימוד למידת מכונה: לכל נוסע רשומים פרטים כמו גיל, מין ומחלקת נסיעה, וגם אם שרד את הטביעה. השאלה שמאגר כזה מזמין היא האם אפשר לחזות הישרדות מתוך הפרטים, ולפני שמאמנים מודל צריך להכיר את הנתונים. ניישם את בדיקת החסרים והקיבוץ על נתוני נוסעי Titanic. פתחו במחברת 13 את קובץ הליווי titanic.csv והעלו אותו לנתיב המופיע בדוגמה. כל שורה מייצגת נוסע; Age היא גיל, Pclass מחלקת נסיעה ו־Survived מציינת 1 לשורד ו־0 למי שלא שרד.
df = pd.read_csv("/content/sample_data/titanic.csv")
print(df.shape)
print(df["Age"].isna().sum())
פלט
(891, 12)
177
הטבלה מכילה 891 נוסעים ו־12 עמודות, ובעמודת הגיל חסרים 177 ערכים. אלה נתוני הגרסה שבמחברת: 714 גילים ידועים מתוך 891. זהו חסר משמעותי, כחמישית מהנוסעים, ולכן ההחלטה כיצד לטפל בו תשפיע על כל ניתוח של הגילים.
כעת נשאל את השאלה ההשוואתית: האם שיעור ההישרדות היה שונה בין נשים לגברים? העמודה Survived מכילה רק 0 ו־1, ולכן יש כאן טריק שימושי. אפשר לחשב שיעור הישרדות בקבוצות באמצעות ממוצע העמודה הבינארית:
rates = df.groupby("Sex")["Survived"].mean()
print(round(rates.loc["female"], 6))
print(round(rates.loc["male"], 6))
פלט
0.742038
0.188908
ממוצע של אפסים ואחדים הוא החלק היחסי של האחדים: אם מתוך עשרה נוסעים שרדו שבעה, סכום העמודה הוא 7 והממוצע הוא 0.7. לפי הפלט, כ־74% מהנשים בטבלה שרדו לעומת כ־19% מהגברים. זה תיאור של הקבוצות שבטבלה, ולא הוכחה לסיבת ההבדל. בחלק ג נראה שמודל סיווג לומד בדיוק דפוסים מסוג זה מתוך הנתונים, ולכן חשוב לדעת מראש מה הם.
מציגים התפלגות
מספרי סיכום כמו ממוצע מסתירים הרבה: ממוצע גיל של 30 יכול לתאר קבוצה של בני שלושים, או תערובת של תינוקות וקשישים. כדי לראות את התמונה המלאה נצייר היסטוגרמה, כפי שלמדנו בפרק PyPlot. התפלגות הגילים מראה כמה נוסעים נמצאים בכל טווח גיל. בדוגמה משלימים גילים חסרים בממוצע ואז מציגים חמישה טווחים בהיסטוגרמה. ל־Pandas יש קיצור נוח: לכל סדרה יש מתודת plot שמשתמשת ב־PyPlot מאחורי הקלעים, ו־kind="hist" בוחרת היסטוגרמה:
import matplotlib.pyplot as plt
ages = df["Age"].fillna(df["Age"].mean())
ages.plot(kind="hist", bins=5, title="Age Distribution")
plt.show()
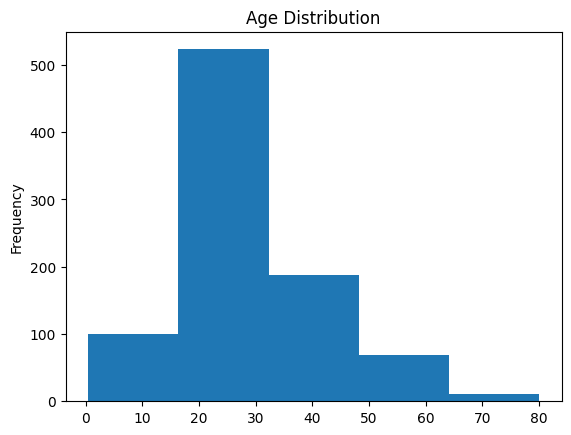
ריבוי הערכים סביב הממוצע מושפע גם מהמילוי שביצענו: 177 הנוסעים שגילם לא היה ידוע קיבלו כולם את אותו ערך, וכולם נופלים לאותו טווח בהיסטוגרמה. כדי לראות את ההתפלגות של הגילים הידועים בלבד, אפשר לצייר את העמודה לפני המילוי ולציין שהחסרים לא נספרו. plot(kind="bar") מתאימה להשוואת קבוצות, ואילו hist מציגה טווחים מספריים.
ממשיכים לאותה שאלה בנתונים אחרים
הכלים שלמדנו אינם מיוחדים לטיטאניק; אותו תהליך חוזר על עצמו בכל מאגר נתונים חדש. בחלק הבא של מחברת 13 מנותח דו״ח האושר העולמי לשנת 2017: בודקים רשומות, מאתרים מדינות ומחשבים ממוצע לפי אזור. מחברת 15.1 מדגימה ניקוי וסינון של טבלת דירות Airbnb. בשתיהן נשאל אותן שאלות: מה מייצגת שורה, מה משמעות עמודה, אילו ערכים חסרים ומה בדיוק מסכם הגרף. פלטי המקור הם תוצאות של גרסאות הנתונים שבמחברות, ולא נתונים עדכניים על המדינות או הדירות.