ג.20 שמירה וטעינה של מודלים
בכל הפרקים עד כה אימנו רשת, בדקנו אותה — וברגע שסגרנו את המחברת, כל מה שהיא למדה נעלם. בפעם הבאה היה צריך לאמן מחדש מאפס. באימונים קצרים של כמה שניות זה לא מפריע, אבל מודלים אמיתיים מתאמנים שעות או ימים על מחשבים יקרים, ואף אחד לא מאמן אותם מחדש בכל פעם שרוצים לזהות תמונה. גם המשחק שנבנה בהמשך הספר יצטרך "מוח" מאומן שנטען מקובץ, ולא רשת שמתחילה ללמוד בכל הפעלה.
מה בעצם צריך לשמור? כל הידע שהרשת רכשה באימון נמצא בפרמטרים שלה — המשקלים וההטיות של כל שכבה. מבנה הרשת, לעומת זאת, כתוב בקוד שלנו. לכן יש שתי אפשרויות: לשמור את אובייקט המודל כולו, מבנה ופרמטרים יחד, או לשמור את הפרמטרים בלבד ולבנות את המבנה מחדש מהקוד בזמן הטעינה. הדרך השנייה נפוצה יותר בפועל, ונראה בהמשך מדוע.
לאחר אימון נרצה לשמור את המודל כדי להשתמש בו בהמשך בלי לאמן אותו מחדש. נלמד שתי דרכים: שמירת המודל כולו ושמירת הפרמטרים בלבד. כדי שיהיה לנו מה לשמור, נאמן תחילה רשת קטנה לסיווג עשר הספרות של MNIST, כפי שעשינו בפרק ג.17, ונוודא שהמודל שנטען מקובץ נותן את אותן תחזיות כמו המודל המקורי.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: מצגת שמירה וטעינה (עותק מקומי) · מחברת שמירה וטעינה (עותק מקומי)
הכנת הנתונים והרשת
נכין מודל ודוגמאות אימון שישמשו להדגמת השמירה והטעינה. החלק הזה של הפרק אינו חדש: הוא חוזר על בניית רשת לסיווג ספרות MNIST שכבר הכרנו, ולכן נעבור עליו בקצרה. החידוש מתחיל בסעיף "שמירת המודל כולו".
נייבא את הספריות. הפעם נשתמש גם ב־torch.nn.functional, שמאפשר להפעיל את ReLU כפונקציה בתוך forward במקום להגדיר אותה כשכבה:
import torch
import torch.nn as nn
import torch.nn.functional as F
import numpy as np
import matplotlib.pyplot as plt
import torchvision
import torchvision.transforms as transforms
נבחר התקן חישוב: מעבד גרפי (GPU) אם הוא זמין, ואחרת המעבד הרגיל:
if torch.cuda.is_available():
    device = torch.device('cuda')
else:
    device = torch.device('cpu')
נטען את MNIST — קבוצת אימון וקבוצת בדיקה — וניצור באמצעות DataLoader אצוות של 50 תמונות. את קבוצת האימון נערבב, ואת קבוצת הבדיקה נשאיר בסדרה המקורי, כדי שאותה אצווה ראשונה תשמש אותנו להשוואה לפני השמירה ואחרי הטעינה:
batch_size = 50

train_dataset = torchvision.datasets.MNIST(root='./data',
                                           train=True,
                                           transform=transforms.ToTensor(),
                                           download=True)

test_dataset = torchvision.datasets.MNIST(root='./data',
                                          train=False,
                                          transform=transforms.ToTensor())

# Data loader
train_loader = torch.utils.data.DataLoader(dataset=train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True)

test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle=False)
נציג שש תמונות מהאצווה הראשונה של הבדיקה ואת התוויות שלהן, רק כדי לראות עם מה אנחנו עובדים:
examples = iter(test_loader)
example_data, example_targets = next(examples)

for i in range(6):
    plt.subplot(2,3,i+1)
    plt.imshow(example_data[i][0], cmap='gray')
    print(example_targets[i].item(),end = " ")
plt.show()
פלט
7 2 1 0 4 1
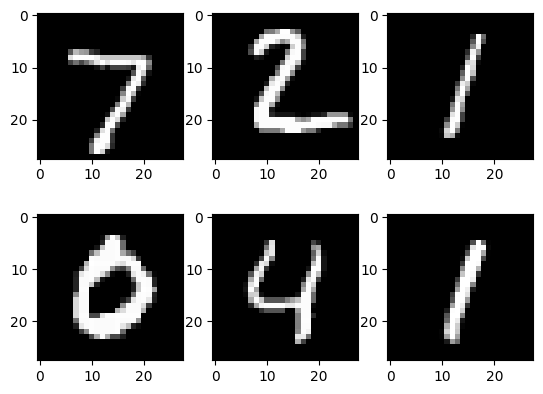
נגדיר את הפרמטרים של הרשת והאימון: 784 קלטים (28×28 פיקסלים), שכבה נסתרת של 200 נוירונים, עשרה פלטים — אחד לכל ספרה — ושתי תקופות אימון בקצב למידה 0.01. שתי תקופות מספיקות כאן, כי המטרה היא רק מודל סביר להדגמת השמירה, לא מודל מושלם:
input_size = 784 # 28x28
hidden_size = 200
num_classes = 10
epochs = 2
learning_rate = 0.01
# losses = torch.zeros(epochs*len(train_loader)//10)
נגדיר את מחלקת הרשת ANN_Model, עם ReLU אחרי השכבה הראשונה. השורות בהערה מראות שאפשר היה לבנות אותה רשת גם ב־nn.Sequential, אך המחלקה חשובה לנו במיוחד בפרק זה: כשנטען מודל מקובץ, ההגדרה שלה תצטרך להיות זמינה בקוד:
# Model = nn.Sequential(
#     nn.Linear(input_size,hidden_size,device=device),
#     nn.ReLU(),
#     nn.Linear(hidden_size, num_classes, device=device),
# )

class ANN_Model(nn.Module):
    def __init__(self):
        super().__init__()
        self.linear1 = nn.Linear(input_size,hidden_size,device=device)
        self.linear2 = nn.Linear(hidden_size, num_classes, device=device)

    def forward(self, x):
        x = self.linear1(x)
        x = F.relu(x)
        x = self.linear2(x)
        return x

Model = ANN_Model().to(device)
נגדיר את פונקציית ההפסד CrossEntropyLoss, המתאימה לסיווג לעשר קטגוריות ומפעילה בעצמה Softmax על הפלט, ואת האופטימייזר Adam:
# Loss = nn.MSELoss()
# Loss = nn.BCELoss()
Loss = nn.CrossEntropyLoss () # applies nn.LogSoftmax + nn.NLLLoss, No softmax in last layer

# init optimizer
# optim = torch.optim.SGD(Model.parameters(), lr=learning_rate,momentum=0.9)
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון המודל
נאמן את הרשת באצוות, בלולאה שהכרנו: בכל אצווה נשטח את התמונות לווקטורים של 784 ערכים, נעביר אותן ואת התוויות להתקן, נחשב פלט והפסד, נחשב נגזרות, נעדכן משקלים ונאפס את הגרדיאנטים. כל 100 אצוות נדפיס את ההפסד:
n_total_steps = len(train_loader)

for epoch in range(epochs):
    for i, (images, lables) in enumerate(train_loader):

        # origin shape: [50, 1, 28, 28]
        # resized: [50, 784]
        images = images.reshape(-1, 28*28).to(device)
        lables = lables.to(device)

        # forward
        Y_predict = Model(images)

        # backward
        loss = Loss(Y_predict, lables)
        loss.backward()

        # update wights
        optim.step()

        if i % 100 == 0:
            print(f"epoch= {epoch} i= {i+epoch * n_total_steps} loss={loss.item():.4f} ")

        # zero grads
        optim.zero_grad()
תחילת הפלט וסופו, בדילוג על שורות הביניים:
פלט
epoch= 0 i= 0 loss=2.3142
epoch= 0 i= 100 loss=0.3428
...
epoch= 1 i= 2300 loss=0.2180
ההפסד ההתחלתי, כ־2.3, הוא הערך הצפוי מרשת שעדיין אינה יודעת דבר ומחלקת את ההסתברות שווה בשווה בין עשר ספרות (ln 10 ≈ 2.3). כבר אחרי 100 אצוות הוא יורד ל־0.34, ובסוף התקופה השנייה הוא סביב 0.22.
בדיקת המודל לפני השמירה
לפני שנשמור את המודל נמדוד את ביצועיו, כדי שיהיה לנו למה להשוות אחרי הטעינה. נחשב את אחוז התחזיות הנכונות על קבוצת הבדיקה; torch.max על ציר 1 מחזיר לכל תמונה את הציון הגבוה ביותר ואת מיקומו, והמיקום הוא הספרה שהרשת בחרה:
with torch.no_grad():
    n_correct = 0
    n_samples = 0
    for images, lables in test_loader:
        images = images.reshape(-1, 28*28).to(device)
        lables = lables.to(device)
        __,y_predict = torch.max(Model(images),1)
        n_samples += lables.size(0)
        n_correct += (y_predict == lables).sum().item()

    acc = 100 * n_correct / n_samples
    print(f'Accuracy of the network on the {n_samples} test images: {acc} %')
פלט
Accuracy of the network on the 10000 test images: 96.01 %
המודל מזהה נכון כ־96% מ־10,000 תמונות הבדיקה. את המספר הזה נרצה לקבל גם מהמודל שנטען מקובץ.
נציג תחזיות ותוויות מאצוות הבדיקה הראשונה, 50 התמונות. רשימה זו תשמש אותנו כ"טביעת אצבע" של המודל: אם המודל שנטען יחזיר בדיוק את אותן תחזיות, נדע שהשמירה והטעינה הצליחו:
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data = example_data.to(device)
example_targets = example_targets.to(device)
_, example_predict_arg = torch.max(Model(example_data.reshape(-1, 28*28)),1)
# print(example_predict_arg)
for i in range(len(example_data)):
    print ("Predict: ",example_predict_arg[i].item(), "target Label: ",example_targets[i].item() )
פלט
Predict:  7 target Label:  7
Predict:  2 target Label:  2
Predict:  1 target Label:  1
Predict:  0 target Label:  0
Predict:  4 target Label:  4
Predict:  1 target Label:  1
Predict:  4 target Label:  4
Predict:  9 target Label:  9
Predict:  6 target Label:  5
Predict:  9 target Label:  9
Predict:  0 target Label:  0
Predict:  6 target Label:  6
Predict:  9 target Label:  9
Predict:  0 target Label:  0
Predict:  1 target Label:  1
Predict:  5 target Label:  5
Predict:  9 target Label:  9
Predict:  7 target Label:  7
Predict:  8 target Label:  3
Predict:  4 target Label:  4
Predict:  9 target Label:  9
Predict:  6 target Label:  6
Predict:  6 target Label:  6
Predict:  5 target Label:  5
Predict:  4 target Label:  4
Predict:  0 target Label:  0
Predict:  7 target Label:  7
Predict:  4 target Label:  4
Predict:  0 target Label:  0
Predict:  1 target Label:  1
Predict:  3 target Label:  3
Predict:  1 target Label:  1
Predict:  3 target Label:  3
Predict:  4 target Label:  4
Predict:  7 target Label:  7
Predict:  2 target Label:  2
Predict:  7 target Label:  7
Predict:  1 target Label:  1
Predict:  2 target Label:  2
Predict:  1 target Label:  1
Predict:  1 target Label:  1
Predict:  7 target Label:  7
Predict:  4 target Label:  4
Predict:  2 target Label:  2
Predict:  3 target Label:  3
Predict:  5 target Label:  5
Predict:  1 target Label:  1
Predict:  2 target Label:  2
Predict:  4 target Label:  4
Predict:  4 target Label:  4
ברוב השורות התחזית תואמת את התווית; אפשר למצוא ברשימה שתי טעויות, למשל 5 שזוהה כ־6 ו־3 שזוהה כ־8. גם הטעויות האלה הן חלק מ"טביעת האצבע" — מודל שנטען נכון יטעה בדיוק באותם מקומות.
שמירת המודל כולו
הדרך הפשוטה ביותר היא לשמור את אובייקט המודל כפי שהוא: torch.save מקבלת את המודל ושם קובץ, ורושמת לדיסק את האובייקט כולו — אילו שכבות יש בו ומהם הפרמטרים של כל אחת. הסיומת .pth מקובלת לקובצי PyTorch. נשמור את אובייקט המודל המאומן בקובץ:
File = "MINST_Model.pth"
torch.save (Model, File)
כעת נעשה את הפעולה ההפוכה: torch.load קוראת את הקובץ ומחזירה אובייקט מודל חדש, new_model, שמכיל את אותם פרמטרים מאומנים. נעביר אותו למצב הערכה באמצעות eval(), כפי שעושים תמיד לפני חיזוי. שימו לב לשתי נקודות. ראשית, הקובץ מכיל את הפרמטרים ואת שמות השכבות, אך לא את הקוד של המחלקה עצמה, ולכן ההגדרה של ANN_Model צריכה להיות זמינה בעת הטעינה — אם נטען את הקובץ במחברת אחרת בלי להגדיר בה את המחלקה, הטעינה תיכשל. שנית, weights_only=False מאפשרת טעינת אובייקט מלא; משתמשים בה רק לקובץ ששמרנו בעצמנו או שמקורו מהימן, משום שטעינה כזו יכולה להפעיל קוד שנמצא בקובץ.
new_model = torch.load(File, weights_only=False)
new_model.eval()
הפעלת המודל שנטען
נבדוק שהמודל שנטען יכול לשמש לחיזוי, בלי שאימנו אותו אפילו צעד אחד. נחשב תחזיות באמצעות new_model על אותה אצווה ראשונה של הבדיקה; הפלט אמור להיות זהה לרשימת התחזיות שקיבלנו מ־Model לפני השמירה:
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data = example_data.to(device)
example_targets = example_targets.to(device)
_, example_predict_arg = torch.max(new_model(example_data.reshape(-1, 28*28)),1)
# print(example_predict_arg)
for i in range(len(example_data)):
    print ("Predict: ",example_predict_arg[i].item(), "target Label: ",example_targets[i].item() )
שמירת הפרמטרים בלבד
הדרך השנייה, המומלצת בתיעוד של PyTorch, מפרידה בין שני הדברים: מבנה הרשת נשאר בקוד, ולקובץ נשמרים רק הערכים שנלמדו. כך הקובץ קטן יותר, אינו תלוי בגרסת הקוד המדויקת שבה נוצר, וטעינתו בטוחה יותר. הפעולה state_dict() מחזירה מילון מצב — state_dict: מילון שבו לכל שכבה יש מפתחות כמו linear1.weight ו־linear1.bias, והערכים הם טנסורי המשקלים וההטיות. נשמור אותו בנפרד:
FILE2 = "model2.pth"
torch.save(Model.state_dict(), FILE2)
בטעינה עלינו לבנות תחילה "שלד" — ניצור רשת חדשה מאותה מחלקה, עם משקלים אקראיים. אחר כך נטען את המילון מהקובץ ונעביר את הפרמטרים לרשת באמצעות load_state_dict, שמתאימה כל ערך במילון לשכבה בעלת אותו שם. מכאן ואילך new_model2 זהה למודל המאומן:
new_model2 = ANN_Model().to(device)
state_dict = torch.load(FILE2)
new_model2.load_state_dict(state_dict)
new_model2.eval()
נפעיל את new_model2 על אצוות הבדיקה הראשונה, ונצפה שוב לאותן תחזיות בדיוק:
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data = example_data.to(device)
example_targets = example_targets.to(device)
_, example_predict_arg = torch.max(new_model2(example_data.reshape(-1, 28*28)),1)
# print(example_predict_arg)
for i in range(len(example_data)):
    print ("Predict: ",example_predict_arg[i].item(), "target Label: ",example_targets[i].item() )
שמירה ב־Google Drive
נשארה בעיה מעשית אחת. הקבצים בסביבת הריצה של Colab זמניים: כשהמחברת נסגרת או שסביבת הריצה מתאפסת, MINST_Model.pth ו־model2.pth נמחקים יחד איתה, ואיבדנו את מה ששמרנו. לשמירה מתמשכת מחברים את Drive באמצעות אייקון Mount Drive בתפריט הקבצים, ומוודאים שהתיקייה Colab Notebooks/Models קיימת ב־MyDrive לפני השמירה:
FILE3 = "/content/drive/MyDrive/Colab Notebooks/Models/model2.pth"
torch.save(Model, FILE3)
הפקודה כאן שומרת את המודל כולו, משום שנמסר לה Model, למרות שם הקובץ model2.pth. ההבדל בין שתי הדרכים אינו בשם הקובץ אלא במה שמעבירים ל־torch.save: האובייקט עצמו או המילון שמחזירה state_dict(). את הקובץ ששמרנו ב־Drive נוכל לטעון בכל מחברת עתידית, וכך "המוח" המאומן ילווה אותנו הלאה — גם למשחקים שנבנה בחלק ד.