ג.5 Gradient Descent במשתנה אחד
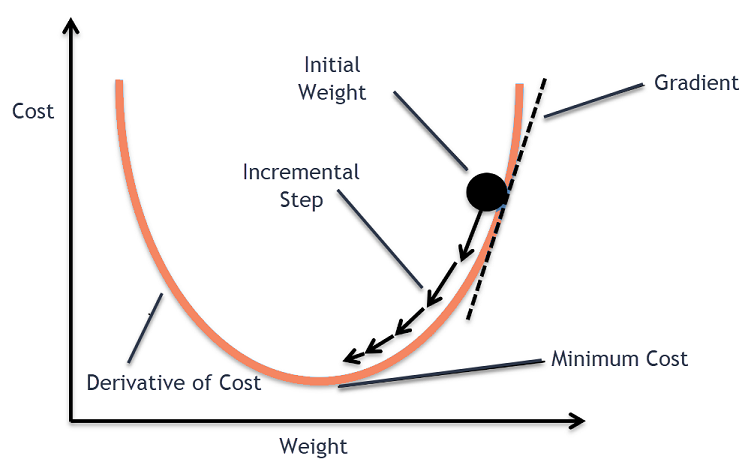
בפרק זה נכיר אלגוריתם שמטרתו פשוטה לניסוח: למצוא את המינימום של פונקציה — כלומר את הנקודה שבה הפונקציה מקבלת את ערכה הנמוך ביותר. נדמיין מטייל שעומד על צלע הר בערפל כבד ורוצה להגיע לתחתית העמק. הוא אינו רואה את העמק, אך הוא יכול להרגיש את שיפוע הקרקע מתחת לרגליו. אסטרטגיה סבירה היא לעשות צעד קטן בכיוון שבו הקרקע יורדת, לבדוק שוב את השיפוע, ולחזור על כך עד שהקרקע נעשית שטוחה. זהו בדיוק הרעיון של ירידה בגרדיאנט — Gradient Descent: השיפוע של הפונקציה בנקודה הוא הנגזרת שלה, שלמדנו לחשב בפרק הקודם, וכיוון הירידה הוא הכיוון ההפוך לנגזרת.
מדוע מציאת מינימום מעניינת אותנו? בלמידת מכונה כל מודל — ובפרט רשת נוירונים — מכיל פרמטרים מספריים, המכונים משקלים, שערכיהם קובעים את התוצאה שהמודל מפיק. עבור כל בחירה של משקלים אפשר למדוד עד כמה המודל טועה על הנתונים. הטעות הזו היא פונקציה של המשקלים, ואימון המודל פירושו למצוא את המשקלים שעבורם הטעות היא הקטנה ביותר — כלומר למצוא את המינימום של פונקציית הטעות. איננו צריכים עדיין להבין כיצד רשת נוירונים בנויה; מספיק לזכור שאימון הוא חיפוש מינימום, וש־Gradient Descent הוא הכלי שמבצע את החיפוש.
בפרק זה נתרכז במקרה הפשוט ביותר, פונקציה של משתנה אחד, כדי להבין את האלגוריתם עצמו לפני שנשתמש בו במודלים אמיתיים. נראה את כלל העדכון, נממש אותו בעצמנו בעזרת Autograd, נכיר את האופטימייזר של PyTorch שעושה זאת בשבילנו, ונלמד מהדוגמאות מה עלול להשתבש: קצב למידה לא מתאים ומינימום מקומי. בפרק הבא נרחיב את אותו רעיון לפונקציה של שני משתנים, ובהמשך למודלים עם אלפי פרמטרים.
באימון רשת נוירונים מתחילים מערכים התחלתיים של המשקלים ומעדכנים אותם כדי להקטין את הטעות. פונקציית ההפסד — Loss, הנקראת גם פונקציית מחיר — Cost, מתארת את הטעות כתלות במשקלים. אנו מחפשים ערכי משקלים שעבורם ההפסד קטן ככל האפשר.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 4. Gradient Descent · השיעור באתר הקורס · מחברת Gradient Descent ב־Colab
האלגוריתם — Stochastic Gradient Descent (SGD)
גרדיאנט — Gradient הוא השם הכללי לנגזרת של פונקציה, ובפונקציה של משתנה אחד הוא פשוט הנגזרת הרגילה. הנגזרת אומרת לנו לאן הפונקציה עולה: נגזרת חיובית פירושה שהפונקציה עולה כשמגדילים את המשתנה, ונגזרת שלילית פירושה שהיא יורדת. מכאן נובע האלגוריתם.
מתחילים בנקודה כלשהי ומתקדמים בצעדים בכיוון ההפוך לנגזרת. אם הנגזרת חיובית, מקטינים את המשקל; אם היא שלילית, מגדילים אותו. כך מחפשים מינימום מקומי של פונקציית ההפסד.
מדוע לא פשוט לגזור ולהשוות לאפס? בשיעורי המתמטיקה למדנו דרך מדויקת למצוא מינימום: גוזרים את הפונקציה, משווים את הנגזרת לאפס ופותרים את המשוואה. לפרבולה שנפגוש מיד הדרך הזו עובדת מצוין: הנגזרת של w² − 4w + 8 היא 2w − 4, היא מתאפסת כאשר w=2, וזהו המינימום. אלא שהדרך הזו דורשת שני דברים: לכתוב את פונקציית הנגזרת בצורה מפורשת, ולפתור את המשוואה "נגזרת שווה אפס".
ברשת נוירונים פונקציית ההפסד היא הרכבה של אלפי פעולות על מיליוני משקלים. אין דרך אלגברית לכתוב את המשוואה "הנגזרת שווה אפס" עבור כל המשקלים יחד ולפתור אותה. מה שכן אפשר לעשות, בכל נקודה נתונה, הוא לחשב את הערך של הנגזרת באותה נקודה, וזה בדיוק מה ש־Autograd עושה בשבילנו. Gradient Descent בנוי על היכולת הזו בלבד: איננו פותרים משוואה, אלא חוזרים שוב ושוב על צעד פשוט, מחשבים את הנגזרת בנקודה הנוכחית ומתקדמים מעט במורד. איננו צריכים לדעת דבר על צורת הפונקציה כולה. לכן זו השיטה שבה מאמנים רשתות נוירונים, ולכן נלמד אותה כאן דווקא על פונקציות פשוטות, שבהן עדיין אפשר לבדוק את התשובה ביד.
נתרגם עתה את הרעיון לאלגוריתם: רצף פעולות קבוע שחוזרים עליו שוב ושוב. שמו המלא של האלגוריתם הוא SGD — Stochastic Gradient Descent, ירידה בגרדיאנט סטוכסטית. סטוכסטי פירושו אקראי: האלגוריתם אינו יודע היכן המינימום, ולכן הוא מתחיל מנקודה אקראית. באימון רשתות נוירונים מצטרף לכך מקור אקראיות נוסף, שנכיר בהמשך: בכל צעד מחשבים את הנגזרת על קבוצה אקראית של דוגמאות מתוך הנתונים.
נתונה פונקציה f(w), למשל פונקציית ההפסד, ואנו מחפשים את הערך w שבו היא מינימלית. אלו שלבי האלגוריתם:
- בוחרים נקודת התחלה אקראית w, וקובעים את קצב הלמידה — learning rate: מספר קטן שקובע עד כמה גדול יהיה כל צעד.
- חישוב קדימה: מחשבים את ערך הפונקציה בנקודה הנוכחית, f(w).
- חישוב לאחור: מחשבים את הנגזרת של הפונקציה בנקודה זו.
- עדכון: מזיזים את w צעד קטן בכיוון ההפוך לנגזרת.
- מאפסים את הנגזרת וחוזרים לשלב 2.
כלל העדכון בשלב 4 הוא:
w = w - learning_rate * gradient
לדוגמה, אם הנגזרת היא 2 וקצב הלמידה הוא 0.01, מקטינים את המשקל ב־0.02. סימן המינוס הוא שמבטיח שהצעד יהיה תמיד במורד. שימו לב שגודל הצעד תלוי גם בנגזרת: רחוק מהמינימום, במקום שבו השיפוע תלול, הצעדים גדולים; ככל שמתקרבים למינימום השיפוע מתמתן והצעדים נעשים קטנים מאליהם. האיפוס בשלב 5 נדרש מפני ש־Autograd צובר נגזרות, כפי שראינו בפרק הקודם, ואנו רוצים שכל איטרציה תתחיל מנגזרת נקייה.
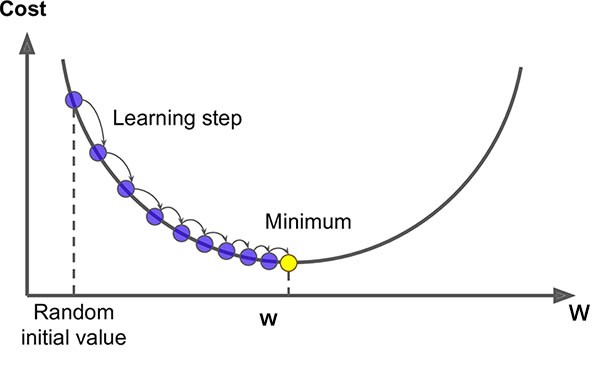
מתי עוצרים? להלכה, האלגוריתם הגיע ליעדו כשהנגזרת קרובה לאפס: הקרקע שטוחה ואין עוד לאן לרדת. למעשה, בלמידת מכונה נהוג לקבוע מראש כמה איטרציות יבצע האימון, ובסיומו להסתכל על גרף ההפסד לאורך האיטרציות. אם הגרף התיישר, הגענו למינימום; אם הוא עדיין יורד, מריצים איטרציות נוספות. כך גם בקוד שבפרק זה: הלולאה רצה מספר קבוע של פעמים, ואנו בודקים בפלט אם המשקל והנגזרת התייצבו.
מציאת מינימום של פונקציה פשוטה
כדי לראות את האלגוריתם בפעולה נבחר תחילה פונקציה שאת המינימום שלה אנו יודעים לחשב בעצמנו: פרבולה. כך נוכל להשוות את תוצאת החיפוש לתשובה הנכונה. נדגים את החיפוש על הפונקציה:
נייבא את הספריות ונגדיר את הפונקציה:
import torch
import numpy as np
import matplotlib.pyplot as plt
def Loss(w):
    return w**2 - 4*w + 8
לפני שנחפש את המינימום נצייר את הפונקציה, כדי שנוכל לראות בעין היכן הוא נמצא. לשם כך ניצור 101 ערכים במרווחים שווים בין 0 ל־4:
# 101 linearly spaced numbers
w_values = np.linspace(0,4,101)
print(w_values)
פלט
[0.   0.04 0.08 0.12 0.16 0.2  0.24 0.28 0.32 0.36 0.4  0.44 0.48 0.52
 0.56 0.6  0.64 0.68 0.72 0.76 0.8  0.84 0.88 0.92 0.96 1.   1.04 1.08
 1.12 1.16 1.2  1.24 1.28 1.32 1.36 1.4  1.44 1.48 1.52 1.56 1.6  1.64
 1.68 1.72 1.76 1.8  1.84 1.88 1.92 1.96 2.   2.04 2.08 2.12 2.16 2.2
 2.24 2.28 2.32 2.36 2.4  2.44 2.48 2.52 2.56 2.6  2.64 2.68 2.72 2.76
 2.8  2.84 2.88 2.92 2.96 3.   3.04 3.08 3.12 3.16 3.2  3.24 3.28 3.32
 3.36 3.4  3.44 3.48 3.52 3.56 3.6  3.64 3.68 3.72 3.76 3.8  3.84 3.88
 3.92 3.96 4.  ]
נחשב את ההפסד בכל ערך ונצייר את הפונקציה:
# Calculate loss values
loss_values = Loss(w_values)

def graph():
    plt.plot(w_values,loss_values, 'r')
    plt.title("loss = w^2 - 4w + 8")
    plt.ylabel("loss")
    plt.xlabel("W")

graph()
# print(w)
print(loss_values)
פלט
[8.     7.8416 7.6864 7.5344 7.3856 7.24   7.0976 6.9584 6.8224 6.6896
 6.56   6.4336 6.3104 6.1904 6.0736 5.96   5.8496 5.7424 5.6384 5.5376
 5.44   5.3456 5.2544 5.1664 5.0816 5.     4.9216 4.8464 4.7744 4.7056
 4.64   4.5776 4.5184 4.4624 4.4096 4.36   4.3136 4.2704 4.2304 4.1936
 4.16   4.1296 4.1024 4.0784 4.0576 4.04   4.0256 4.0144 4.0064 4.0016
 4.     4.0016 4.0064 4.0144 4.0256 4.04   4.0576 4.0784 4.1024 4.1296
 4.16   4.1936 4.2304 4.2704 4.3136 4.36   4.4096 4.4624 4.5184 4.5776
 4.64   4.7056 4.7744 4.8464 4.9216 5.     5.0816 5.1664 5.2544 5.3456
 5.44   5.5376 5.6384 5.7424 5.8496 5.96   6.0736 6.1904 6.3104 6.4336
 6.56   6.6896 6.8224 6.9584 7.0976 7.24   7.3856 7.5344 7.6864 7.8416
 8.    ]
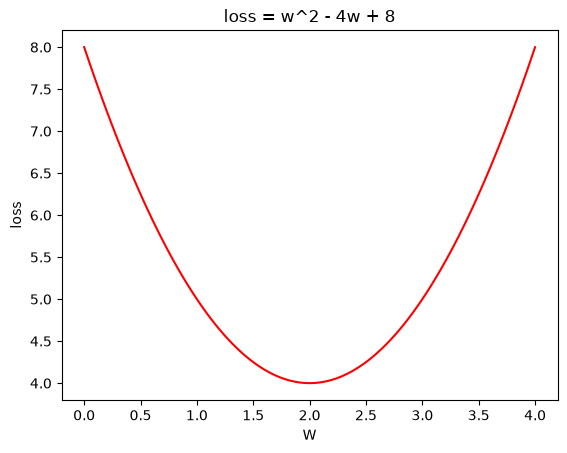
בפלט רואים שערכי ההפסד יורדים עד 4 ואז עולים בחזרה. הערך הנמוך ביותר, 4, מתקבל באמצע הרשימה — עבור w=2, וזו גם תחתית הפרבולה שבגרף. זהו המינימום שאנו מצפים שהאלגוריתם ימצא.
מימוש בקוד
כעת נכתוב בעצמנו את עדכון המשקל וניעזר ב־Autograd לחישוב הנגזרת. נאתחל את המשקל ל־5.5 ואת קצב הלמידה ל־0.1, ונבצע 300 איטרציות. בקוד כל איטרציה נקראת epoch; בהמשך הספר נשתמש במונח אפוק — epoch לתיאור מעבר שלם על נתוני האימון, וכאן, כשאין נתונים, הוא פשוט מונה איטרציות. העדכון מתבצע בתוך torch.no_grad(), כדי ש־Autograd לא יתעד את פעולת העדכון עצמה כחלק מגרף החישוב, ולאחריו מאפסים את הנגזרת לקראת האיטרציה הבאה.
# Initialize weight and parameters
w = torch.tensor(5.5, requires_grad=True)
learning_rate = 0.1

for epoch in range (300):
    # Forward
    loss = Loss(w)

    # Backward - calculate gradients
    loss.backward()

    if epoch <= 10:
        print(f"epoch= {epoch} W= {w.item():.5f} model={loss:.5f} grad= {w.grad:.5f}")

    elif epoch % 10 == 0:
        print(f"epoch= {epoch} W= {w.item():.5f} model={loss:.5f} grad= {w.grad:.5f}")

    # Update weight
    with torch.no_grad():
        w -= learning_rate * w.grad

    # zero grads
    w.grad.zero_()

print(f"End W= {w.item():.3f} model={loss:.3f} ")
פלט
epoch= 0 W= 5.50000 model=16.25000 grad= 7.00000
epoch= 1 W= 4.80000 model=11.84000 grad= 5.60000
epoch= 2 W= 4.24000 model=9.01760 grad= 4.48000
epoch= 3 W= 3.79200 model=7.21126 grad= 3.58400
epoch= 4 W= 3.43360 model=6.05521 grad= 2.86720
epoch= 5 W= 3.14688 model=5.31533 grad= 2.29376
epoch= 6 W= 2.91750 model=4.84181 grad= 1.83501
epoch= 7 W= 2.73400 model=4.53876 grad= 1.46801
epoch= 8 W= 2.58720 model=4.34481 grad= 1.17441
epoch= 9 W= 2.46976 model=4.22068 grad= 0.93952
epoch= 10 W= 2.37581 model=4.14123 grad= 0.75162
epoch= 20 W= 2.04035 model=4.00163 grad= 0.08070
epoch= 30 W= 2.00433 model=4.00002 grad= 0.00867
epoch= 40 W= 2.00046 model=4.00000 grad= 0.00093
epoch= 50 W= 2.00005 model=4.00000 grad= 0.00010
epoch= 60 W= 2.00001 model=4.00000 grad= 0.00001
epoch= 70 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 80 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 90 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 100 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 110 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 120 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 130 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 140 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 150 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 160 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 170 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 180 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 190 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 200 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 210 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 220 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 230 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 240 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 250 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 260 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 270 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 280 W= 2.00000 model=4.00000 grad= 0.00000
epoch= 290 W= 2.00000 model=4.00000 grad= 0.00000
End W= 2.000 model=4.000
נתבונן בפלט. בכל שורה מודפסים המשקל לפני העדכון, ערך ההפסד באותה נקודה (בפלט הוא נקרא model) והנגזרת. באיטרציה הראשונה, ב־w=5.5, הנגזרת היא 7, ולכן הצעד הוא 0.1·7=0.7 והמשקל יורד ל־4.8. בנקודה החדשה הנגזרת כבר קטנה יותר, 5.6, ולכן גם הצעד הבא קטן יותר, 0.56. כך זה נמשך: הנגזרת של הפרבולה היא 2w − 4, וככל שהמשקל מתקרב ל־2 היא מתקרבת לאפס. בדוגמה זו הנגזרת קטנה בכל איטרציה ב־20% בדיוק, 7, 5.6, 4.48, 3.584 וכן הלאה, ואיתה מתקצרים הצעדים מאליהם, בלי שאיש הורה לאלגוריתם להאט.
אחרי 20 איטרציות הנגזרת היא 0.08, אחרי 40 היא 0.001, ובסביבות איטרציה 70 היא מתאפסת בדיוק המודפס. מכאן ואילך המשקל וההפסד אינם משתנים עוד, ו־230 האיטרציות הנותרות אינן משנות דבר. זו בדיוק התופעה שתיארנו בסעיף "מתי עוצרים?": קבענו מראש 300 איטרציות, ומהפלט אנו רואים שהמינימום הושג הרבה לפני כן.
נציג את התוצאה ונסמן אותה על גרף הפונקציה:
min_w = w.item()
min_loss = loss.item()
print (min_w, min_loss)

plt.plot(w_values,loss_values, 'r')
plt.plot(min_w, min_loss, '*')
plt.title("loss = w^2 - 4w + 8")
plt.ylabel("loss")
plt.xlabel("W")
פלט
2.000000476837158 4.0
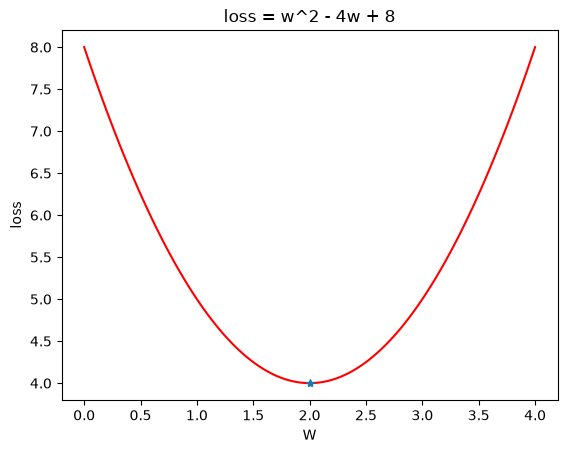
החיפוש הגיע בקירוב ל־w=2, שבו ההפסד הוא 4. זו בדיוק התשובה שראינו בגרף, אף שהאלגוריתם לא "ידע" דבר על צורת הפרבולה — הוא רק עקב אחרי הנגזרת.
Optimizer SGD
את עדכון המשקל כתבנו בעצמנו, אך זהו קטע קוד שחוזר על עצמו בכל אימון. PyTorch מספקת לשם כך אובייקט מוכן: אופטימייזר — Optimizer. השם SGD הוא קיצור של Stochastic Gradient Descent, הגרסה של ירידה בגרדיאנט שבה משתמשים באימון רשתות; בדוגמה שלנו, שבה אין נתונים ויש משקל אחד, הוא מבצע בדיוק את כלל העדכון שכתבנו קודם.
האופטימייזר מחליף שני שלבים שכתבנו בעצמנו בלולאה הקודמת. יוצרים אותו באמצעות torch.optim.SGD עם רשימת הפרמטרים לעדכון ועם קצב הלמידה. הפעולה step() מבצעת את כלל העדכון על כל הפרמטרים שברשימה, במקום שורת העדכון שכתבנו בתוך torch.no_grad(). גם את איפוס הנגזרות האופטימייזר עושה בשבילנו: הפעולה zero_grad() מאפסת את הנגזרות של כל הפרמטרים שברשימה, במקום w.grad.zero_() שקראנו לה בעצמנו. גם כאן חובה לקרוא לה בכל איטרציה; אם נשכח, הנגזרות ייצברו מאיטרציה לאיטרציה והצעדים יהיו שגויים.
נאתחל הפעם את המשקל ל־3.5 ונבצע 100 איטרציות:
# Initialize weight and parameters
w = torch.tensor(3.5, requires_grad=True)
learning_rate = 0.1

# init optimizer
optimizer = torch.optim.SGD([w], lr=learning_rate)

for epoch in range (100):
    # Forward
    loss = Loss(w)

    # Backward - calculate gradients
    loss.backward()

    # Update weight
    optimizer.step() # w = w - grad * LR

    if epoch % 10 == 0:
        print(f"epoch= {epoch} w= {w.item():.3f} model={loss:.3f} grad= {w.grad:.3f}")

    # zero Grads
    optimizer.zero_grad()

print(f"End W= {w.item():.3f} model={loss:.3f} ")
פלט
epoch= 0 w= 3.200 model=6.250 grad= 3.000
epoch= 10 w= 2.129 model=4.026 grad= 0.322
epoch= 20 w= 2.014 model=4.000 grad= 0.035
epoch= 30 w= 2.001 model=4.000 grad= 0.004
epoch= 40 w= 2.000 model=4.000 grad= 0.000
epoch= 50 w= 2.000 model=4.000 grad= 0.000
epoch= 60 w= 2.000 model=4.000 grad= 0.000
epoch= 70 w= 2.000 model=4.000 grad= 0.000
epoch= 80 w= 2.000 model=4.000 grad= 0.000
epoch= 90 w= 2.000 model=4.000 grad= 0.000
End W= 2.000 model=4.000
שימו לב להבדל קטן לעומת הלולאה הקודמת: כאן ההדפסה נמצאת אחרי step(), ולכן המשקל מודפס אחרי העדכון, ואילו ההפסד והנגזרת חושבו לפניו. התמונה עצמה זהה למה שראינו במימוש בקוד: הנגזרת מתכווצת מאיטרציה לאיטרציה, וכבר אחרי כ־40 איטרציות המשקל התייצב על 2.
קצב הלמידה
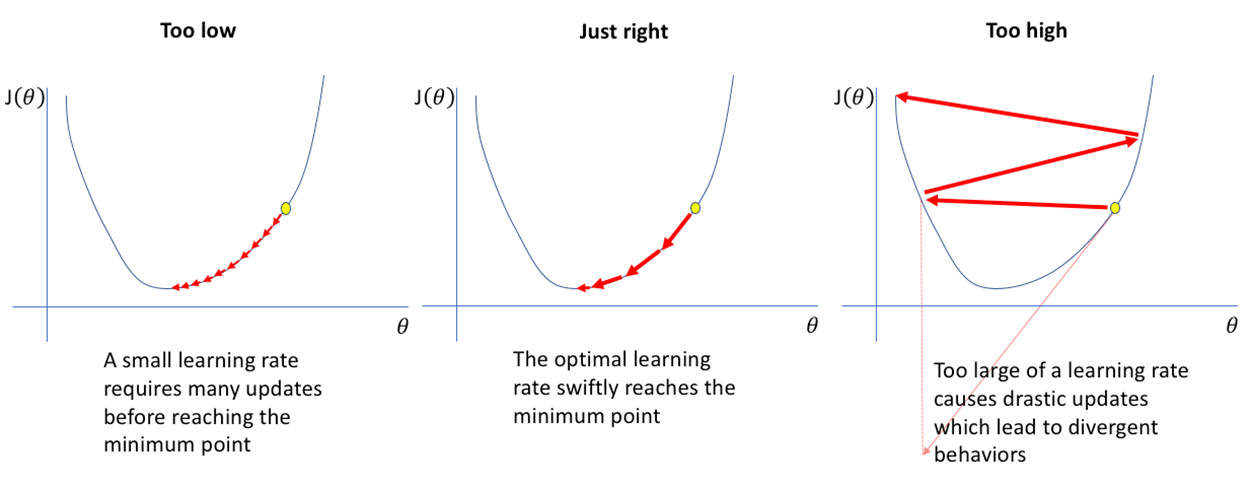
עד כה השתמשנו בקצב למידה 0.1 והכול עבד יפה, אך הבחירה בקצב אינה מובנת מאליה. קצב הלמידה, יחד עם הנגזרת, קובע את גודל הצעד בכל איטרציה. קצב קטן מדי עלול להאט את ההתקדמות, ונצטרך אלפי איטרציות כדי להתקרב למינימום; קצב גדול מדי עלול לגרום לקפיצות שמתרחקות מהמינימום — המשקל "מדלג" מעל התחתית מצד לצד, ובמקרה הגרוע ההפסד גדל בכל צעד במקום לקטון. בדוגמאות נבחן קצבים שונים ונשווה את התוצאות.
השפעת הפרמטרים ההתחלתיים
הפרבולה שבדקנו נוחה במיוחד: יש לה תחתית אחת בלבד, ומכל נקודת התחלה נגיע אליה. פונקציות רבות אינן כאלה, ויש להן כמה "עמקים". לעיתים האלגוריתם מגיע למינימום מקומי — Local Minimum: ערך נמוך בסביבתו הקרובה, אך לא הנמוך ביותר בפונקציה. מכיוון שהאלגוריתם יורד תמיד במורד, הוא נעצר בעמק הראשון שאליו הגיע ואינו יודע שיש עמק עמוק יותר במקום אחר. לכן שינוי נקודת ההתחלה עשוי להוביל לתוצאה אחרת.
תרגיל
נבדוק את התופעה הזו על פונקציה שיש לה יותר ממינימום אחד. מצאו מינימום של הפונקציה הבאה. הריצו מנקודות ההתחלה 0, 2 ו־−4, והשוו את התוצאות.
נגדיר את הפונקציה ונצייר אותה:
def L (w):
    return w ** 4 + 3* w**3 - w**2 - 3* w
w = np.linspace(-4,2,100)

plt.plot(w, L(w), 'r')
plt.title("loss = w^4 + 3w^3 - w^2 - 3w")
plt.ylabel("L")
plt.xlabel("w")
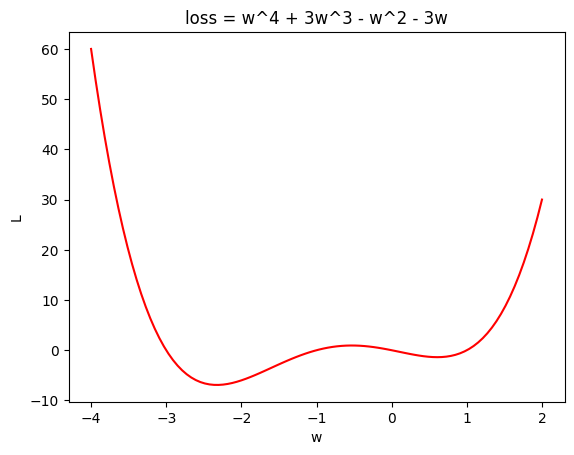
בגרף רואים שני עמקים: עמק רדוד מימין, בסביבות w=0.6, ועמק עמוק בהרבה משמאל, בסביבות w=−2.3. נריץ את האופטימייזר מנקודת ההתחלה 2, בקצב למידה 0.01, במשך 1,000 איטרציות. קצב הלמידה כאן קטן מבעבר מפני שהפולינום תלול מאוד בקצוות, ונגזרת גדולה יחד עם קצב 0.1 הייתה מובילה לקפיצות עצומות:
# Initialize weight and parameters
W = torch.tensor(2.0, requires_grad=True) # 0.0, 1.0, 2, -1, -4
learning_rate = 0.01

# init optimizer
optimizer = torch.optim.SGD([W], lr=learning_rate)

for epoch in range (1000):
    # Forward
    l = L(W)

    # Backward - calculate gradients
    l.backward()

    # Update weight
    optimizer.step()

    if epoch % 10 == 0:
        print(f"epoch= {epoch} W= {W.item():.3f} model={l:.3f} grad= {W.grad:.3f}")

    # Zero gradients
    optimizer.zero_grad()

print(f"End W= {W.item():.3f} model={l:.3f} ")
השורה האחרונה של הפלט:
פלט
End W= 0.607 model=-1.383
נסמן את התוצאה על גרף הפונקציה:
plt.plot(w, L(w), 'r')
plt.title("loss = w^4 + 3w^3 - w^2 - 3w")
plt.ylabel("L")
plt.xlabel("w")
plt.plot(W.item(), l.item(), '*',color='b')
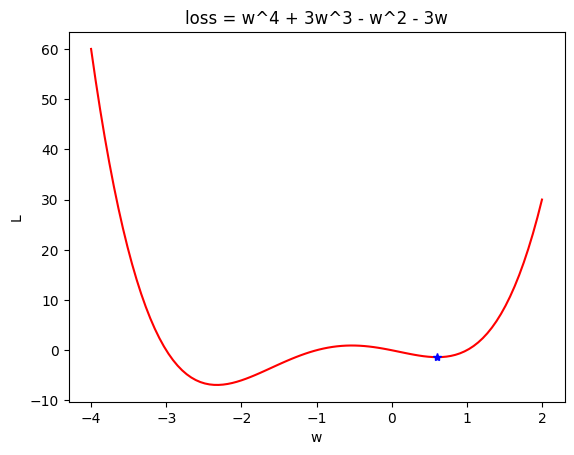
החיפוש שהתחיל ב־2 גלש למטה ונעצר בעמק הימני, הרדוד. זהו מינימום מקומי: מבחינת האלגוריתם הנגזרת התאפסה והחיפוש הסתיים, אף שבצד השמאלי של הגרף יש נקודה נמוכה בהרבה.
תרגול נוסף
בסעיף זה נתרגל את מה שלמדנו על כמה פונקציות, ובעיקר נראה כיצד נקודת ההתחלה וצורת הפונקציה משפיעות על התוצאה. נריץ תחילה את הפולינום מהסעיף הקודם עם נקודת התחלה −1, בקצב 0.01, במשך 100 איטרציות:
# Initialize parameter
W = torch.tensor(-1.0, requires_grad=True) # 0.0, 1.0, 2, -1, -4
learning_rate = 0.01

# init optimizer
optimizer = torch.optim.SGD([W], lr=learning_rate)

for epoch in range (100):
    # Forward
    l = L(W)

    # Calculate gradients
    l.backward()

    # Update parameter
    optimizer.step()

    if epoch % 10 == 0:
        print(f"epoch= {epoch} W= {W.item():.3f} model={l:.3f} grad= {W.grad:.3f}")

    # Zero gradients
    optimizer.zero_grad()

print(f"End W= {W.item():.3f} model={l:.3f} ")
השורה האחרונה של הפלט:
פלט
End W= -2.326 model=-6.914
plt.plot(w, L(w), 'r')
plt.title("loss = w^4 + 3w^3 - w^2 - 3w")
plt.ylabel("L")
plt.xlabel("w")
plt.plot(W.item(), l.item(), '*',color='b')
התחלה זו הובילה לעמק השמאלי, שערכו נמוך מזה שהתקבל בהתחלה מ־2. אותה פונקציה, אותו אלגוריתם ואותו קצב למידה — ובכל זאת תוצאה שונה, רק בגלל נקודת ההתחלה. זו הסיבה שבאימון רשתות נהוג לעיתים לאתחל את המשקלים באקראי ולהריץ כמה פעמים.
כעת נבחן את ארבע הפונקציות הבאות בתחום −5<x<5, לפי סדר התרגילים. בכל דוגמה נגדיר את הפונקציה, נבצע את החיפוש ונציג את התוצאה. בכל תרגיל נגדיר את הפונקציה פעמיים: גרסה עם torch, שעליה יופעל Autograd במהלך החיפוש, וגרסה עם numpy לציור הגרף.
תרגיל 1 — x² sin(x)
def F (x):
    return x**2 * torch.sin(x)

def F_numpy (x):
    return x**2 * np.sin(x)
# Initialize parameter
x = torch.tensor(2, requires_grad=True, dtype=torch.float32)   # -0.1, -5
learning_rate = 0.1

for epoch in range (300):
    # Forward
    f = F(x)

    # Calculate gradients
    f.backward()

    if epoch <= 10:
        print(f"epoch= {epoch} W= {x.item():.5f} model={f:.5f} grad= {x.grad:.5f}")

    elif epoch % 10 == 0:
        print(f"epoch= {epoch} W= {x.item():.5f} model={f:.5f} grad= {x.grad:.5f}")

    # Update parameter
    with torch.no_grad():
        x -= learning_rate * x.grad

    # zero grads
    x.grad.zero_()

print(f"End W= {x.item():.3f} model={f:.3f} ")
השורה האחרונה של הפלט:
פלט
End W= 0.011 model=0.000
x_values = np.linspace(-5,5,101)
f_values = F_numpy(x_values)

plt.plot(x_values, f_values, 'r')
plt.title("f(x) = x^2 * sin(x)")
plt.ylabel("F")
plt.xlabel("x")
plt.plot(x.item(), f.item(), '*',color='b')
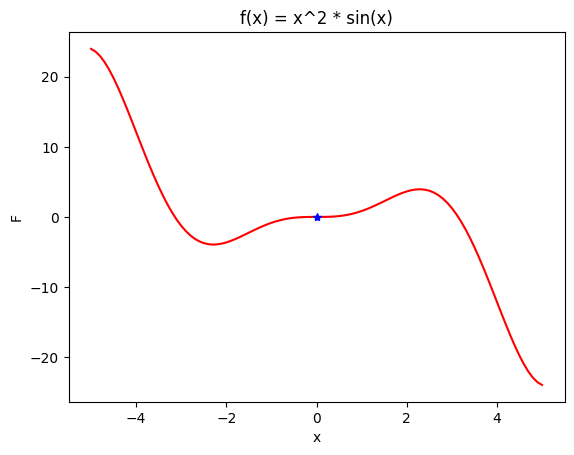
החיפוש מתקרב לאפס, אך אפס אינו מינימום של הפונקציה: בסמוך לו יש גם ערכים שליליים. ב־x=0 הנגזרת מתאפסת מפני שהגרף שטוח שם לרגע, ואז ממשיך לרדת — נקודה כזו נקראת נקודת פיתול. האלגוריתם עוצר בה מפני שהצעדים, שגודלם תלוי בנגזרת, נעשים זעירים. לכן תוצאה עם נגזרת קטנה אינה מספיקה כדי לקבוע שנמצא מינימום.
תרגיל 2 — x² cos(x)
def F (x):
    return x**2 * torch.cos(x)

def F_numpy (x):
    return x**2 * np.cos(x)
# Initialize parameter
x = torch.tensor(2, requires_grad=True, dtype=torch.float32)   # -0.1, -5, 2
learning_rate = 0.1

for epoch in range (300):
    # Forward
    f = F(x)

    # Calculate gradients
    f.backward()

    if epoch <= 10:
        print(f"epoch= {epoch} W= {x.item():.5f} model={f:.5f} grad= {x.grad:.5f}")

    elif epoch % 10 == 0:
        print(f"epoch= {epoch} W= {x.item():.5f} model={f:.5f} grad= {x.grad:.5f}")

    # Update parameter
    with torch.no_grad():
        x -= learning_rate * x.grad

    # zero grads
    x.grad.zero_()

print(f"End W= {x.item():.3f} model={f:.3f} ")
השורה האחרונה של הפלט:
פלט
End W= 3.644 model=-11.638
x_values = np.linspace(-5,5,101)
f_values = F_numpy(x_values)

plt.plot(x_values, f_values, 'r')
plt.title("f(x) = x^2 * cos(x)")
plt.ylabel("F")
plt.xlabel("x")
plt.plot(x.item(), f.item(), '*',color='b')
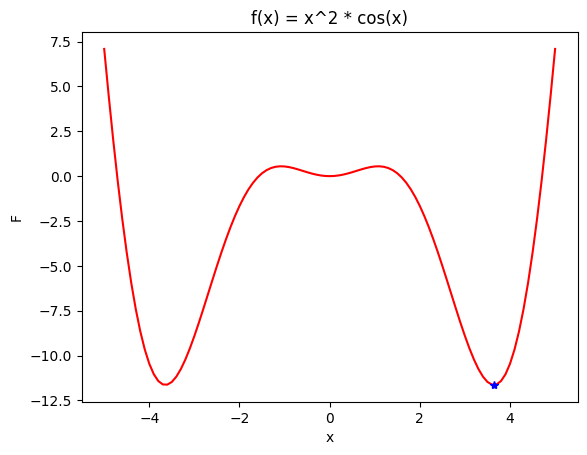
הפעם, מאותה נקודת התחלה 2, החיפוש גלש ימינה והגיע לעמק עמוק בסביבות x=3.6. נסו להריץ גם מנקודות ההתחלה −0.1 ו־−5 המופיעות בהערה שבקוד, וראו לאיזה עמק מגיעים בכל פעם.
תרגיל 3 — סכום פונקציות מעריכיות
def F (x):
    return torch.exp(-(x+2)**2) + torch.exp(-(x-2)**2)-0.5

def F_numpy (x):
    return np.exp(-(x+2)**2) + np.exp(-(x-2)**2)-0.5
# Initialize parameter
x = torch.tensor(1.5, requires_grad=True, dtype=torch.float32)   # -0.1, -5, 2
learning_rate = 0.1

# init optimizer
optimizer = torch.optim.SGD([x], lr=learning_rate)

for epoch in range (300):
    # Forward
    f = F(x)

    # Calculate gradients
    f.backward()

    if epoch <= 10:
        print(f"epoch= {epoch} W= {x.item():.5f} model={f:.5f} grad= {x.grad:.5f}")

    elif epoch % 10 == 0:
        print(f"epoch= {epoch} W= {x.item():.5f} model={f:.5f} grad= {x.grad:.5f}")

    # Update parameter
    optimizer.step()

    # zero grads
    optimizer.zero_grad()

print(f"End W= {x.item():.3f} model={f:.3f} ")
השורה האחרונה של הפלט:
פלט
End W= 0.000 model=-0.463
x_values = np.linspace(-5,5,101)
f_values = F_numpy(x_values)

plt.plot(x_values, f_values, 'r')
plt.title("f(x) = e^-(x+2)^2 + e^-(x-2)^2 - 0.5")
plt.ylabel("F")
plt.xlabel("x")
plt.plot(x.item(), f.item(), '*',color='b')
התוצאה נמצאת במינימום המקומי שבין שתי הפסגות. הפונקציה בנויה משתי "גבעות" סביב x=−2 ו־x=2, ובין שתיהן יש שקע קטן ב־x=0. נקודת ההתחלה 1.5 נמצאת על המדרון הפנימי של הגבעה הימנית, ולכן הירידה מובילה אל השקע שביניהן, אף שמחוץ לשתי הגבעות הפונקציה יורדת לערכים נמוכים עוד יותר.
תרגיל 4 — sin(3x) + cos(2x)
def F (x):
    return torch.sin(3*x) + torch.cos(2*x)

def F_numpy (x):
    return np.sin(3*x) + np.cos(2*x)
# Initialize parameter
x = torch.tensor(0, requires_grad=True, dtype=torch.float32)   # -0.1, -5, 2
learning_rate = 0.1

# init optimizer
optimizer = torch.optim.SGD([x], lr=learning_rate)

for epoch in range (300):
    # Forward
    f = F(x)

    # Calculate gradients
    f.backward()

    if epoch <= 10:
        print(f"epoch= {epoch} W= {x.item():.5f} model={f:.5f} grad= {x.grad:.5f}")

    elif epoch % 10 == 0:
        print(f"epoch= {epoch} W= {x.item():.5f} model={f:.5f} grad= {x.grad:.5f}")

    # Update parameter
    optimizer.step()

    # zero grads
    optimizer.zero_grad()

print(f"End W= {x.item():.3f} model={f:.3f} ")
השורה האחרונה של הפלט:
פלט
End W= -0.767 model=-0.708
x_values = np.linspace(-5,5,101)
f_values = F_numpy(x_values)

plt.plot(x_values, f_values, 'r')
plt.title("f(x) = sin(3x) + cos(2x)")
plt.ylabel("F")
plt.xlabel("x")
plt.plot(x.item(), f.item(), '*',color='b')
פונקציה זו מחזורית, ויש לה עמקים רבים בעומקים שונים לאורך כל התחום. מנקודת ההתחלה 0 החיפוש התגלגל לעמק הקרוב, בסביבות x=−0.77. המסקנה מארבעת התרגילים אחת: ירידה בגרדיאנט מוצאת מינימום מקומי בסביבת נקודת ההתחלה, ולא בהכרח את המינימום הנמוך ביותר. באימון רשתות נוירונים נחיה עם המגבלה הזו, ונראה בהמשך שבפועל היא מפריעה פחות ממה שנדמה.