ג.11 גלטון — הכנת טבלה וחיזוי גובה
האם אפשר לנחש כמה גבוה יהיה ילד לפי גובה הוריו? השאלה הזו העסיקה את פרנסיס גלטון, מדען בריטי בן המאה ה־19, שאסף נתוני גובה של מאות משפחות כדי לבדוק עד כמה תכונות עוברות בתורשה. מהמחקר שלו נולד המונח "רגרסיה" עצמו, ואותם נתונים בדיוק — כמעט אלף ילדים והוריהם — ישמשו אותנו בפרק זה. זו הפעם הראשונה שנעבוד עם נתונים אמיתיים שנאספו בעולם, ולא עם מספרים שיצרנו בעצמנו.
בפרקים הקודמים הנתונים הגיעו מוכנים: כמה מספרים שהקלדנו לתוך טנסור. בעולם האמיתי נתונים מגיעים כטבלה — קובץ CSV, גיליון אלקטרוני או בסיס נתונים — ויש בה עמודות שאינן רלוונטיות, ערכים שכתובים כטקסט ולא כמספר, יחידות מדידה שאינן נוחות לנו, וטעויות הקלדה. רוב העבודה בפרויקט למידת מכונה אמיתי אינה בניית המודל אלא הכנת הנתונים — Data Preparation: ניקוי הטבלה, המרת הטקסט למספרים, הפרדת הקלט מהתשובה ונרמול. זהו הנושא העיקרי של הפרק, והמודל עצמו — רגרסיה לינארית בחמישה משתנים — הוא בדיוק המודל מהפרק הקודם, רק עם יותר קלטים.
נבנה מודל רגרסיה לינארית לחיזוי גובה ילד לפי חמש תכונות: גובה האב, גובה האם, מספר הילדים במשפחה, המספר הסידורי של הילד ומינו. נשתמש בנתוני הגבהים של גלטון, נמיר את הגבהים מאינצ׳ים לסנטימטרים וננרמל את הנתונים. לטיפול בטבלה ניעזר בספריית pandas, שהכרנו בחלק א.
המשימה היא להמיר את הטבלה לטנסור, להוציא עמודות שאינן משמשות לחיזוי ולהפריד את גובה הילד לטנסור התשובות. בסיום נחשב תחזיות לארבע הדוגמאות הבאות — ילדים שאינם בטבלה, כלומר הכללה של ממש; אפשר לנסות גם את נתוני המשפחה שלכם.
| גובה האב | גובה האם | מספר ילדים | מספר הילד | מין: 0 זכר, 1 נקבה |
|---|---|---|---|---|
| 184 | 161 | 4 | 1 | 0 |
| 184 | 161 | 4 | 3 | 1 |
| 179 | 170 | 2 | 1 | 0 |
| 175 | 177 | 3 | 3 | 1 |
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: מצגת רגרסיה במספר משתנים (עותק מקומי) · מחברת התרגיל (עותק מקומי) · מחברת הפתרון (עותק מקומי)
טעינת הטבלה
נתחיל בקריאת טבלת הגבהים ובהיכרות עם העמודות שישמשו בהמשך לחיזוי. לפני שנוגעים במודל, כדאי תמיד להסתכל על הנתונים בעיניים: מה יש בכל עמודה, מאיזה סוג הערכים ואיזה טיפול הם דורשים.
נייבא את הספריות. החדשה כאן היא pandas, ספריית הטבלאות של פייתון:
import torch
import pandas as pd
import numpy as np
import torch.nn as nn
import matplotlib.pyplot as plt
הנתונים שמורים בקובץ CSV באינטרנט, ו־pandas יודעת לקרוא אותו ישירות מכתובת URL. נטען את קובץ ה־CSV לאובייקט DataFrame של pandas ונדפיס את חמש השורות הראשונות:
url = "https://raw.githubusercontent.com/MarkmanGilad/Galton_Heights/refs/heads/main/Data/galton.csv"
df = pd.read_csv(url)

print(df.head())
פלט
family  father  mother  children  childNum  gender  childHeight
0      1    78.5    67.0         4         1    male         73.2
1      1    78.5    67.0         4         2  female         69.2
2      1    78.5    67.0         4         3  female         69.0
3      1    78.5    67.0         4         4  female         69.0
4      2    75.5    66.5         4         1    male         73.5
כל שורה היא ילד אחד. העמודות: מספר המשפחה (family), גובה האב והאם (father, mother) באינצ׳ים, מספר הילדים במשפחה (children), המספר הסידורי של הילד בין אחיו (childNum), מינו (gender) וגובהו (childHeight), גם הוא באינצ׳ים. ארבע השורות הראשונות, למשל, הן ארבעת ילדיה של משפחה מספר 1, שבה האב גבוה במיוחד — 78.5 אינצ׳.
נבדוק את סוגי העמודות ואת מספר השורות. הפקודה info() מציגה לכל עמודה את מספר הערכים הלא־ריקים ואת סוג הנתונים שלה:
print(df.info())
פלט
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 934 entries, 0 to 933
Data columns (total 7 columns):
 #   Column       Non-Null Count  Dtype
---  ------       --------------  -----
 0   family       934 non-null    object
 1   father       934 non-null    float64
 2   mother       934 non-null    float64
 3   children     934 non-null    int64
 4   childNum     934 non-null    int64
 5   gender       934 non-null    object
 6   childHeight  934 non-null    float64
dtypes: float64(3), int64(2), object(2)
memory usage: 51.2+ KB
None
בטבלה 934 שורות, ובכל העמודות 934 ערכים לא־ריקים — כלומר אין ערכים חסרים, וזו חדשה טובה. הסוגים float64 ו־int64 הם מספרים, אך שתי עמודות מסוג object, כלומר טקסט: gender באופן צפוי, אך גם family, שאמורה להכיל מספרים. זהו סימן שמשהו בעמודה הזו אינו מספר, ונברר זאת מיד.
המרת עמודות הטקסט למספרים
מודל יודע לחשב רק עם מספרים; מילה כמו male אינה אומרת לו דבר. לכן, כדי להעביר את הנתונים למודל, נצטרך לייצג את עמודות הטקסט במספרים. העמודות family ו־gender מופיעות מסוג object. תחילה נמצא את ערכי המשפחה שאינם ניתנים להמרה למספר. הפקודה to_numeric עם errors='coerce' מנסה להמיר כל ערך למספר ומסמנת ב־NaN את מה שנכשל, ו־isna() מאתרת את הסימונים האלה:
invalid_mask = pd.to_numeric(df['family'], errors='coerce').isna()
invalid_values = df.loc[invalid_mask, 'family']
print(invalid_values)
פלט
609    136A
610    136A
611    136A
612    136A
613    136A
614    136A
615    136A
616    136A
Name: family, dtype: object
מצאנו את האשם: משפחה אחת, שמונה ילדים, קיבלה במקור את המזהה 136A, שאינו מספר. זו דוגמה אופיינית ל"לכלוך" בנתונים אמיתיים. נחליף את המזהה 136A בשורות 609–616 ב־205, מספר פנוי שאינו מתנגש עם משפחה קיימת, ולאחר מכן נמיר את העמודה למספר שלם:
df.loc[609:616, 'family'] = "205"
df["family"] = df['family'].astype(int)
עמודת המין מכילה שני ערכים אפשריים בלבד, ולכן די במספר בינארי כדי לייצג אותה. נקודד את המין: female יהיה 1 ו־male יהיה 0. הפונקציה np.where בודקת את התנאי לכל שורה ובוחרת את הערך הראשון אם הוא מתקיים ואת השני אם לא.
df["gender"] = np.where(df["gender"] == "female", 1, 0)
נבדוק שוב את הטבלה ואת סוגי העמודות, כדי לוודא שכל העמודות הפכו למספריות:
print(df.head())
print(df.info())
פלט
family  father  mother  children  childNum  gender  childHeight
0       1    78.5    67.0         4         1       0         73.2
1       1    78.5    67.0         4         2       1         69.2
2       1    78.5    67.0         4         3       1         69.0
3       1    78.5    67.0         4         4       1         69.0
4       2    75.5    66.5         4         1       0         73.5
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 934 entries, 0 to 933
Data columns (total 7 columns):
 #   Column       Non-Null Count  Dtype
---  ------       --------------  -----
 0   family       934 non-null    int64
 1   father       934 non-null    float64
 2   mother       934 non-null    float64
 3   children     934 non-null    int64
 4   childNum     934 non-null    int64
 5   gender       934 non-null    int64
 6   childHeight  934 non-null    float64
dtypes: float64(3), int64(4)
memory usage: 51.2 KB
None
עתה כל שבע העמודות מספריות: שלוש מסוג float64 וארבע מסוג int64, ואין עוד עמודות object. הטבלה מוכנה להפוך לטנסור.
המרה לטנסור והפרדת הקלט מהתשובה
הטבלה כולה היא מספרים, ולכן אפשר להפוך אותה למטריצה של 934 שורות ו־7 עמודות. יש שתי דרכים לעשות זאת. נציג תחילה המרה למערך NumPy מסוג float32:
array_np = df.to_numpy(dtype=np.float32)
print(array_np)
print(array_np.dtype)
פלט
[[  1.   78.5  67.  ...   1.    0.   73.2]
 [  1.   78.5  67.  ...   2.    1.   69.2]
 [  1.   78.5  67.  ...   3.    1.   69. ]
 ...
 [203.   62.   66.  ...   3.    1.   61. ]
 [204.   62.5  63.  ...   1.    0.   66.5]
 [204.   62.5  63.  ...   2.    1.   57. ]]
float32
הדרך השנייה, שבה נמשיך, היא ליצור טנסור ישירות מערכי הטבלה (df.values):
tensor = torch.tensor(df.values, dtype=torch.float32)
print(tensor[0:5])
print(tensor.shape)
פלט
tensor([[ 1.0000, 78.5000, 67.0000,  4.0000,  1.0000,  0.0000, 73.2000],
        [ 1.0000, 78.5000, 67.0000,  4.0000,  2.0000,  1.0000, 69.2000],
        [ 1.0000, 78.5000, 67.0000,  4.0000,  3.0000,  1.0000, 69.0000],
        [ 1.0000, 78.5000, 67.0000,  4.0000,  4.0000,  1.0000, 69.0000],
        [ 2.0000, 75.5000, 66.5000,  4.0000,  1.0000,  0.0000, 73.5000]])
torch.Size([934, 7])
כעת נפריד את הטבלה לשני חלקים, כפי שעשינו בכל פרקי הרגרסיה: X — מה שהמודל מקבל, ו־Y — מה שהוא צריך לחזות. נבחר את חמש עמודות הקלט ואת עמודת גובה הילד. עמודת מספר המשפחה אינה נכללת ב־X: היא רק מזהה מנהלי, ואין סיבה להניח שמשפחה מספר 200 תהיה גבוהה ממשפחה מספר 100. תכונה שאין לה קשר סיבתי לתוצאה עלולה רק לבלבל את המודל. החיתוך [:,1:6] לוקח את כל השורות ואת העמודות 1 עד 5, ו־[:,6:] לוקח את העמודה השישית כטנסור של עמודה אחת:
X = tensor[:,1:6] # slice: father, mother, children, childNum, gender
Y = tensor[:,6:] # childHeight
print(X[0:5])
print(Y[0:5])
פלט
tensor([[78.5000, 67.0000,  4.0000,  1.0000,  0.0000],
        [78.5000, 67.0000,  4.0000,  2.0000,  1.0000],
        [78.5000, 67.0000,  4.0000,  3.0000,  1.0000],
        [78.5000, 67.0000,  4.0000,  4.0000,  1.0000],
        [75.5000, 66.5000,  4.0000,  1.0000,  0.0000]])
tensor([[73.2000],
        [69.2000],
        [69.0000],
        [69.0000],
        [73.5000]])
המרה מאינצ׳ים לסנטימטרים
גלטון מדד באינצ׳ים, ואנחנו רגילים לסנטימטרים. ההמרה אינה הכרחית למודל — הוא היה לומד גם באינצ׳ים — אך היא תאפשר לנו לקרוא את התחזיות ביחידות מוכרות ולהזין את נתוני המשפחה שלנו בלי לחשב המרות. נכפיל את גבהי ההורים ואת גובה הילד ב־2.54. יתר עמודות הקלט מוכפלות ב־1 ונשארות ללא שינוי; הטריק של טנסור עם ערך לכל עמודה חוסך את הצורך לטפל בכל עמודה בנפרד.
inches = torch.tensor([2.54, 2.54, 1, 1, 1])
X = X*inches
Y = Y*2.54
נדפיס את השורות הראשונות ואת הצורות כדי לוודא שההמרה פעלה רק על עמודות הגובה:
print(X[0:5])
print(Y[0:5])
print ("shape x, y",X.shape, Y.shape)
פלט
tensor([[199.3900, 170.1800,   4.0000,   1.0000,   0.0000],
        [199.3900, 170.1800,   4.0000,   2.0000,   1.0000],
        [199.3900, 170.1800,   4.0000,   3.0000,   1.0000],
        [199.3900, 170.1800,   4.0000,   4.0000,   1.0000],
        [191.7700, 168.9100,   4.0000,   1.0000,   0.0000]])
tensor([[185.9280],
        [175.7680],
        [175.2600],
        [175.2600],
        [186.6900]])
shape x, y torch.Size([934, 5]) torch.Size([934, 1])
האב הגבוה של משפחה 1 הוא עתה 199.39 ס"מ, ובנו הבכור 185.93 ס"מ; עמודות הילדים, המספר הסידורי והמין לא השתנו. ל־X יש 934 שורות ו־5 עמודות, ל־Y — 934 שורות ועמודה אחת, כנדרש.
נרמול הנתונים
התכונות שלנו נעות בסולמות שונים מאוד: גבהים במאות סנטימטרים, מספר ילדים בין 1 ל־15, ומין שהוא 0 או 1. כפי שלמדנו בשני הפרקים הקודמים, פערים כאלה מקשים על האימון, ולכן ננרמל כל עמודה בנפרד. הפעם ננרמל גם את Y, גובה הילד, כדי שגם התחזיות יהיו בסולם 0–1; לכן נצטרך את הפעולה ההפוכה גם כדי לקרוא את תחזיות הגובה ביחידות המקוריות. שימו לב שהפונקציות מקבלות את המינימום והמקסימום כפרמטרים, מפני שנשתמש בהן גם ל־X וגם ל־Y, עם ערכים שונים לכל אחד. נגדיר את שתי הפעולות:
def Normalize_minMax(X, min, max):
    return (X - min) / (max - min)

def UnNormalize_minMax(X, min, max):
    return X * (max-min) + min
נחשב מינימום ומקסימום לכל תכונה וננרמל את X:
minX, minIndexX = X.min(dim=0)
maxX, maxIndexX = X.max(dim=0)
print (minX, minIndexX)
print (maxX, maxIndexX)

X = Normalize_minMax(X, minX, maxX)
print(X[0:5])
פלט
tensor([157.4800, 147.3200,   1.0000,   1.0000,   0.0000]) tensor([929, 234,  21,   0,   0])
tensor([199.3900, 179.0700,  15.0000,  15.0000,   1.0000]) tensor([  0, 570, 844, 858,   1])
tensor([[1.0000, 0.7200, 0.2143, 0.0000, 0.0000],
        [1.0000, 0.7200, 0.2143, 0.0714, 1.0000],
        [1.0000, 0.7200, 0.2143, 0.1429, 1.0000],
        [1.0000, 0.7200, 0.2143, 0.2143, 1.0000],
        [0.8182, 0.6800, 0.2143, 0.0000, 0.0000]])
מהפלט אפשר ללמוד על טווח הנתונים: האב הנמוך ביותר בטבלה הוא 157.48 ס"מ והגבוה ביותר 199.39 (האב של משפחה 1 — ולכן בשורה הראשונה של X המנורמל עמודת האב מקבלת בדיוק 1.0); האם הנמוכה ביותר 147.32 והגבוהה ביותר 179.07; ויש משפחות עם 15 ילדים. את ערכי המינימום והמקסימום, minX ו־maxX, נשמור, כי נזדקק להם בכל חיזוי עתידי.
נחשב גם את המינימום והמקסימום של גובה הילד. כאן Y הוא עמודה אחת, ולכן די ב־min() ו־max() על הטנסור כולו:
minY = Y.min()
maxY = Y.max()
print(maxY, minY)
פלט
tensor(200.6600) tensor(142.2400)
הילד הנמוך ביותר בטבלה הוא 142.24 ס"מ והגבוה ביותר 200.66. ננרמל את Y:
Y = Normalize_minMax(Y, minY, maxY)
print(Y[0:5])
פלט
tensor([[0.7478],
        [0.5739],
        [0.5652],
        [0.5652],
        [0.7609]])
הגדרת המודל, ההפסד והאופטימייזר
אחרי כל ההכנה, הגדרת המודל היא החלק הקצר: זהו אותו nn.Linear מהפרק הקודם, רק עם חמישה קלטים במקום שניים. למודל חמישה קלטים ופלט אחד, ולכן הוא ילמד חמישה משקלים והטיה. במקום לכתוב את המספר 5 ידנית, נקרא אותו מצורת X — כך הקוד ימשיך לעבוד גם אם נוסיף או נסיר תכונה. נאמן אותו ב־SGD, עם MSE, קצב למידה 0.01 ו־2,000 צעדים.
learning_rate = 0.01
epochs = 2000
losses = []

in_features = X.shape[1] #5
out_features=1
Model = nn.Linear(in_features, out_features, bias=True)

#construct loss and optimizer
Loss = nn.MSELoss()

# init optimizer
optim = torch.optim.SGD(Model.parameters(), lr=learning_rate)
# optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
לולאת האימון
לולאת האימון זהה לזו שכתבנו בפרקים הקודמים — גם כשהמודל מקבל חמישה קלטים ו־934 דוגמאות, הקוד אינו משתנה. נעדכן את פרמטרי המודל בצעדים חוזרים לפי ההפרש בין הגבהים החזויים לגבהים שבנתונים.
for epoch in range(epochs):
    # forward
    Y_predict = Model(X)

    # backward
    loss = Loss(Y_predict, Y)
    loss.backward()

    # update wights
    optim.step()

    if epoch % 10 == 0:
        print(f"epoch= {epoch} loss={loss.item():.9f} ")
        # print (Y_predict)

    losses.append(loss.item())

    # zero grads
    optim.zero_grad()
שורות ראשונות ואחרונה מתוך פלט האימון השמור; האתחול האקראי עשוי לשנות את התוצאות בהרצה חדשה.
פלט
epoch= 0 loss=0.194146290
epoch= 10 loss=0.099102013
epoch= 20 loss=0.054675732
...
epoch= 1990 loss=0.007299490
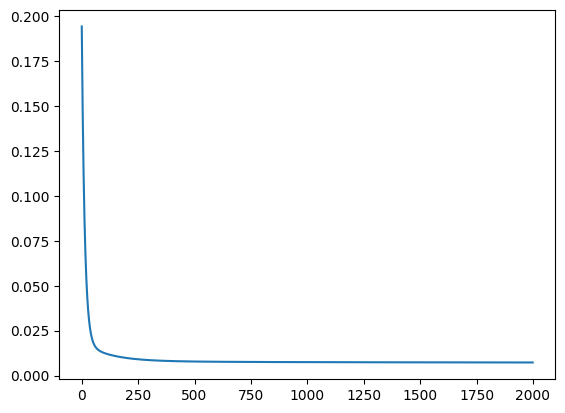
ההפסד מתחיל בכ־0.19, יורד לכ־0.055 אחרי 20 אפוקים ומתייצב לבסוף על כ־0.0073. הערכים קטנים מפני שהם בסולם המנורמל, שבו כל הגבהים בין 0 ל־1. נציג את ההפסד לאורך האימון:
plt.plot(losses)
בדיקת תחזיות לשורות מתוך הטבלה
לפני שנחזה גבהים לילדים חדשים, נבדוק כיצד המודל מתפקד על שורות שהוא כבר מכיר, כדי לוודא שהצינור כולו — נרמול, מודל, ביטול נרמול — עובד כהלכה. נבחר את שש השורות 100–105, שהן שישה ילדים של משפחה אחת (משפחה 28). תחילה נגדיר טנסור המרה לשבע עמודות הטבלה המקורית, ונציג את השורות לפני ההמרה לסנטימטרים ואחריה:
inchesTensor = torch.tensor([1, 2.5400, 2.5400, 1.0000, 1.0000, 1.0000, 2.5400])
print(inchesTensor)
פלט
tensor([1.0000, 2.5400, 2.5400, 1.0000, 1.0000, 1.0000, 2.5400])
startidx = 100
endIdx = 106
print(df.iloc[startidx:endIdx])
print(df.iloc[startidx:endIdx]*inchesTensor)
פלט
family  father  mother  children  childNum  gender  childHeight
100      28    72.0    63.0         6         1       0         73.0
101      28    72.0    63.0         6         2       0         67.0
102      28    72.0    63.0         6         3       1         70.5
103      28    72.0    63.0         6         4       1         70.0
104      28    72.0    63.0         6         5       1         66.5
105      28    72.0    63.0         6         6       1         63.0
     family      father      mother  children  childNum  gender  childHeight
100    28.0  182.879997  160.019998       6.0       1.0     0.0   185.419997
101    28.0  182.879997  160.019998       6.0       2.0     0.0   170.179997
102    28.0  182.879997  160.019998       6.0       3.0     1.0   179.069997
103    28.0  182.879997  160.019998       6.0       4.0     1.0   177.799997
104    28.0  182.879997  160.019998       6.0       5.0     1.0   168.909997
105    28.0  182.879997  160.019998       6.0       6.0     1.0   160.019998
שישה ילדים לאותם הורים — אב בגובה 182.88 ס"מ ואם בגובה 160.02 — ובכל זאת הגבהים נעים בין 160 ל־185 ס"מ. זה מזכיר לנו שהמודל יכול לתפוס רק חלק מהסיפור. נציג את טנסורי הקלט והתשובות, לפני ביטול הנרמול ואחריו, ונוודא שהפעולה ההפוכה מחזירה בדיוק את הערכים שראינו בטבלה:
print(X[startidx:endIdx])
print(UnNormalize_minMax(X[startidx:endIdx], minX, maxX))
print(Y[startidx:endIdx])
print(UnNormalize_minMax(Y[startidx:endIdx], minY, maxY))
פלט
tensor([[0.6061, 0.4000, 0.3571, 0.0000, 0.0000],
        [0.6061, 0.4000, 0.3571, 0.0714, 0.0000],
        [0.6061, 0.4000, 0.3571, 0.1429, 1.0000],
        [0.6061, 0.4000, 0.3571, 0.2143, 1.0000],
        [0.6061, 0.4000, 0.3571, 0.2857, 1.0000],
        [0.6061, 0.4000, 0.3571, 0.3571, 1.0000]])
tensor([[182.8800, 160.0200,   6.0000,   1.0000,   0.0000],
        [182.8800, 160.0200,   6.0000,   2.0000,   0.0000],
        [182.8800, 160.0200,   6.0000,   3.0000,   1.0000],
        [182.8800, 160.0200,   6.0000,   4.0000,   1.0000],
        [182.8800, 160.0200,   6.0000,   5.0000,   1.0000],
        [182.8800, 160.0200,   6.0000,   6.0000,   1.0000]])
tensor([[0.7391],
        [0.4783],
        [0.6304],
        [0.6087],
        [0.4565],
        [0.3043]])
tensor([[185.4200],
        [170.1800],
        [179.0700],
        [177.8000],
        [168.9100],
        [160.0200]])
נחשב תחזיות לשורות שבחרנו ונחזיר אותן לסנטימטרים. המודל מקבל את הקלט המנורמל ומחזיר גובה מנורמל, ורק ביטול הנרמול עם minY ו־maxY הופך אותו לסנטימטרים:
testData = X[startidx:endIdx]
testResult = Model(testData)
print(testResult)
print(UnNormalize_minMax(testResult, minY, maxY))
פלט
tensor([[0.6417],
        [0.6132],
        [0.4330],
        [0.4045],
        [0.3760],
        [0.3475]], grad_fn=<AddmmBackward0>)
tensor([[179.7292],
        [178.0646],
        [167.5353],
        [165.8707],
        [164.2061],
        [162.5416]], grad_fn=<AddBackward0>)
נשווה לגבהים האמיתיים: לבן הבכור (185.42 ס"מ) המודל חוזה כ־179.7; לבן השני (170.18) הוא חוזה כ־178.1; ולבת השישית (160.02) הוא חוזה כ־162.5. התחזיות סבירות אך אינן מדויקות — טעויות של כמה סנטימטרים הן צפויות, כי גובה תלוי גם בגורמים שאינם בטבלה. שימו לב גם לדפוס: לילדים בעלי אותם נתונים המודל מוריד כ־1.7 ס"מ לכל ילד נוסף במספר הסידורי, ולבנות הוא חוזה גובה נמוך משמעותית מלבנים.
השורות האלה כבר השתתפו באימון, גם אם שם המשתנה הוא testData. לכן הצלחה עליהן אינה מוכיחה שהמודל מכליל היטב; בפרקים הבאים נלמד להפריד נתוני בדיקה שהמודל לא ראה באימון.
חיזוי לדוגמאות נוספות
עכשיו נגיע למטרה האמיתית: חיזוי לילדים שאינם בטבלה. נגדיר את ארבע הדוגמאות מהפתיחה ועוד ארבע דוגמאות, כשהגבהים כבר בסנטימטרים. ארבע הדוגמאות הנוספות הן אותם הורים (184 ו־161) עם ארבעה בנים במספרים סידוריים שונים, כדי לראות את השפעת המספר הסידורי לבדו:
testData2 = torch.tensor([
    [184, 161, 4, 1, 0],
    [184, 161, 4, 3, 1],
    [179, 170, 2, 1, 0],
    [175, 177, 3, 3, 1],
    [184, 161, 4, 4, 0],
    [184, 161, 4, 3, 0],
    [184, 161, 4, 2, 0],
    [184, 161, 4, 1, 0]])
testData2
פלט
tensor([[184, 161,   4,   1,   0],
        [184, 161,   4,   3,   1],
        [179, 170,   2,   1,   0],
        [175, 177,   3,   3,   1],
        [184, 161,   4,   4,   0],
        [184, 161,   4,   3,   0],
        [184, 161,   4,   2,   0],
        [184, 161,   4,   1,   0]])
זהו הרגע שבו חשוב לזכור את הכלל מפרק ג.9: המודל אומן על נתונים מנורמלים, ולכן כל קלט חדש חייב לעבור את אותו נרמול בדיוק — עם minX ו־maxX של נתוני האימון, לא עם המינימום והמקסימום של הדוגמאות החדשות. ננרמל באמצעות הערכים ששמרנו, נחשב תחזיות ונבטל את נרמול הפלט:
normTestData2 = Normalize_minMax(testData2, minX, maxX)
res = Model(normTestData2)
print(res, UnNormalize_minMax(res, minY, maxY), sep="\n")
פלט
tensor([[0.6312],
        [0.4225],
        [0.6338],
        [0.4583],
        [0.5457],
        [0.5742],
        [0.6027],
        [0.6312]], grad_fn=<AddmmBackward0>)
tensor([[179.1142],
        [166.9203],
        [179.2650],
        [169.0162],
        [174.1205],
        [175.7851],
        [177.4496],
        [179.1142]], grad_fn=<AddBackward0>)
לבן בכור של אב בגובה 184 ואם בגובה 161 המודל חוזה כ־179.1 ס"מ, ולבת השלישית באותה משפחה כ־166.9. הדוגמה השלישית — הורים בגובה 179 ו־170 — מקבלת תחזית דומה לראשונה, כ־179.3: האם הגבוהה יותר מפצה על האב הנמוך יותר. ארבע השורות האחרונות מראות את השפעת המספר הסידורי בבידוד: בן רביעי, שלישי, שני ובכור מקבלים 174.1, 175.8, 177.4 ו־179.1 — כ־1.7 ס"מ לכל מקום. אלו הערכות בלבד, אך הן מבוססות על כמעט אלף ילדים אמיתיים.
הצגת המשקלים וההטיה
ברגרסיה לינארית המשקלים אינם רק מספרים פנימיים של המודל — הם מספרים לנו כיצד כל תכונה משפיעה על התחזית. נציג את הפרמטרים שהתקבלו באימון: המשקלים של תכונות הקלט והאיבר הקבוע של המודל.
print("Regression Coefficients (Weights):")
print(Model.weight)

print("\nRegression Intercept (Bias):")
print(Model.bias)
פלט
Regression Coefficients (Weights):
Parameter containing:
tensor([[ 0.2908,  0.2200,  0.1756, -0.3989, -0.1517]], requires_grad=True)

Regression Intercept (Bias):
Parameter containing:
tensor([0.3147], requires_grad=True)
חמשת המשקלים מתאימים, לפי הסדר, לגובה האב, לגובה האם, למספר הילדים, למספר הסידורי ולמין. שלושת הראשונים חיוביים: הורים גבוהים יותר — ילד גבוה יותר, וגובה האב (0.29) משפיע קצת יותר מגובה האם (0.22). שני האחרונים שליליים: מספר סידורי גבוה יותר מנבא ילד נמוך יותר, ומשקל המין, −0.15, מבטא את הפער הממוצע בין בנות לבנים. יש לזכור שהמשקלים מתייחסים לקלט המנורמל, ולכן הם משווים בין תכונות בסולם אחיד ולא בסנטימטרים ישירות.
מדדי השגיאה
עד עכשיו התרשמנו מהמודל דרך דוגמאות בודדות. כדי לסכם במספר אחד עד כמה התחזיות קרובות לגבהים שבנתונים, נחשב שני מדדי שגיאה: MSE, ממוצע ריבועי השגיאות, שכבר משמש אותנו כפונקציית ההפסד, ו־MAE, ממוצע השגיאה המוחלטת — Mean Absolute Error, שהוא ממוצע המרחקים בערך מוחלט בין התחזית לערך האמיתי. MAE קל יותר לפירוש, כי הוא באותן יחידות של הנתונים ולא בריבוען. נשתמש בפונקציות המוכנות של scikit-learn. נחשב מחדש את התחזיות ונציג MSE ואת ממוצע השגיאה המוחלטת, MAE:
from sklearn.metrics import mean_squared_error, mean_absolute_error

# Ensure Y_predict is up-to-date from the last training epoch
Model.eval() # Set model to evaluation mode
with torch.no_grad():
        Y_predict_final = Model(X)
Model.train() # Set model back to training mode if further training is planned

mse = mean_squared_error(Y.numpy(), Y_predict_final.numpy())
mae = mean_absolute_error(Y.numpy(), Y_predict_final.numpy())

print(f"Mean Squared Error (MSE): {mse:.4f}")
print(f"Mean Absolute Error (MAE): {mae:.4f}")
פלט
Mean Squared Error (MSE): 0.0073
Mean Absolute Error (MAE): 0.0670
המדדים מחושבים כאן על נתוני האימון המנורמלים, ולכן אינם נמדדים בסנטימטרים. ה־MSE, 0.0073, זהה להפסד שראינו בסוף האימון, כצפוי. ה־MAE, 0.067, אומר שבממוצע התחזית סוטה מהגובה האמיתי בכ־6.7% מטווח הגבהים; מכיוון שהטווח הוא כ־58 ס"מ (בין 142.24 ל־200.66), מדובר בסטייה ממוצעת של כמה סנטימטרים. הקריאות Model.eval() ו־Model.train() מחליפות את המודל בין מצב הערכה למצב אימון; לשכבה לינארית פשוטה אין להן השפעה, אך זהו הרגל טוב שיהיה חשוב ברשתות מורכבות יותר.
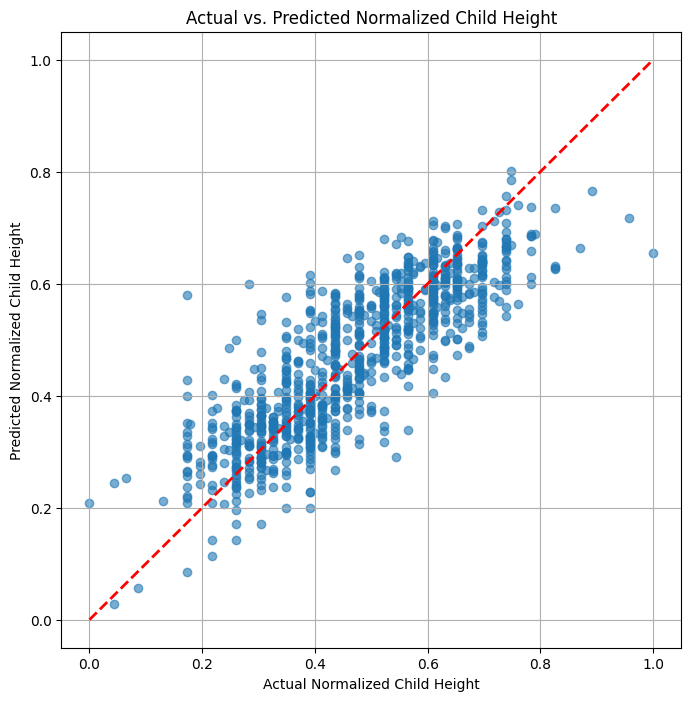
גובה אמיתי מול גובה חזוי
דרך נוחה להעריך מודל רגרסיה בעין היא לצייר את התחזית מול הערך האמיתי לכל דוגמה. אילו המודל היה מושלם, כל הנקודות היו מונחות על האלכסון; ככל שהן מפוזרות סביבו יותר, כך הטעויות גדולות יותר. נציג את הגובה האמיתי מול הגובה החזוי. נקודה על האלכסון האדום מציינת תחזית השווה לערך האמיתי.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 8))
plt.scatter(Y.numpy(), Y_predict_final.numpy(), alpha=0.6)
plt.plot([Y.min(), Y.max()], [Y.min(), Y.max()], 'r--', lw=2) # 45-degree line
plt.xlabel('Actual Normalized Child Height')
plt.ylabel('Predicted Normalized Child Height')
plt.title('Actual vs. Predicted Normalized Child Height')
plt.grid(True)
plt.show()