ג.6 Gradient Descent בשני משתנים
בפרק הקודם למדנו לרדת אל המינימום של פונקציה במשתנה אחד: המטייל בערפל הרגיש את שיפוע השביל ופסע במורד. אבל רשת נוירונים אמיתית אינה תלויה במשקל אחד אלא באלפים רבים, ופונקציית ההפסד שלה היא פונקציה של כל המשקלים יחד. כדי להתקרב למצב הזה נעשה עתה את הצעד הבא: שני משתנים. זהו המקרה הפשוט ביותר של "הרבה משתנים", ויש לו יתרון גדול: עדיין אפשר לצייר אותו ולראות בעיניים מה קורה.
פונקציה במשתנה אחד מתארת עקומה במישור. פונקציה בשני משתנים מתארת משטח במרחב: לכל זוג ערכים x ו־y מתאים גובה. כשיש יותר משני משתני קלט, אי אפשר להציג את כל גרף הפונקציה במרחב תלת־ממדי רגיל. המטייל שלנו עומד עכשיו לא על שביל אלא על נוף של הרים ועמקים, ויכול לפסוע לכל כיוון במישור.
גם בפונקציות במספר משתנים אפשר לחפש מינימום מקומי בעזרת Gradient Descent. הרעיון זהה לזה שבפרק הקודם, וכל מה שמשתנה הוא שבמקום נגזרת אחת יש נגזרת חלקית לכל משתנה; למדנו לחשב אותן בפרק Autograd. בכל איטרציה מחשבים נגזרת חלקית לפי כל משתנה ומעדכנים את המשתנים בהתאם לנגזרות ולקצב הלמידה. כל משתנה מתעדכן לפי הנגזרת שלו, באותו כלל עדכון מהפרק הקודם, וכל העדכונים נעשים יחד באותו צעד.
בפרק זה נראה את האלגוריתם על משטח עם כמה עמקים, נעקוב אחרי המסלול שהוא עובר, ונגלה שגם כאן נקודת ההתחלה וקצב הלמידה קובעים לאיזה עמק נגיע. מה שנלמד תקף ללא שינוי גם לאלפי משתנים; ההבדל היחיד הוא שכבר לא נוכל לצייר את המשטח.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 4. Gradient Descent (עותק מקומי) · מחברת Gradient Descent 2D (עותק מקומי)
נייבא את הספריות:
import torch
import numpy as np
import matplotlib.pyplot as plt
פונקציית Peaks
כמו בפרק הקודם, נבחר תחילה פונקציה לדוגמה שאינה קשורה לרשת נוירונים, כדי להתרכז באלגוריתם עצמו. הפעם נרצה משטח מעניין, עם כמה פסגות וכמה עמקים, כדי שנוכל לראות כיצד האלגוריתם מתמודד עם מינימום מקומי. נשתמש בפונקציית Peaks כדי לבחון חיפוש מינימום על משטח שתלוי בשני משתנים:
$$ z=3(1-x)^2e^{-x^2-(y+1)^2} -10\left(\frac{x}{5}-x^3-y^5\right)e^{-x^2-y^2} -\frac{1}{3}e^{-(x+1)^2-y^2} $$
הנוסחה נראית מפחידה, אך אין צורך להבין אותה; היא רק "מייצרת נוף" של גבעות ובורות, ואנו נניח ל־Autograd לגזור אותה. הדוגמה מבוססת על הקורס A deep understanding of deep learning של Mike X Cohen. במפת הצבעים, צהוב מציין נקודות גבוהות וכחול נקודות נמוכות; זו הדרך המקובלת לצייר משטח תלת־ממדי על מסך שטוח, כמו מפה טופוגרפית.
הצגת הגרף
כדי לראות את המשטח שעליו יתבצע החיפוש, נחשב את גובהו בנקודות רבות. נגדיר את הפונקציה באמצעות NumPy. בפרק הקודם יצרנו ב־linspace רצף של ערכי w וחישבנו את הפונקציה בכל אחד מהם; כאן יש שני צירים, ולכן צריך לחשב את הפונקציה בכל צירוף של x ו־y. הפעולה meshgrid יוצרת רשת של זוגות ערכי x ו־y, שעליה נחשב את גובה המשטח.
# From Udemy, A deep understanding of deep learning, Mike X Cohen
# the "peaks" function
def peaks(x,y):
    # expand to a 2D mesh
    x,y = np.meshgrid(x,y)

    z = 3*(1-x)**2 * np.exp(-(x**2) - (y+1)**2) \
            - 10*(x/5 - x**3 - y**5) * np.exp(-x**2-y**2) \
            - 1/3*np.exp(-(x+1)**2 - y**2)
    return z
ניצור את ערכי הצירים, 201 נקודות בין −3 ל־3 בכל ציר, ונציג את מפת הצבעים. הפרמטרים vmin ו־vmax קובעים אילו גבהים ימופו לקצוות סולם הצבעים:
# create the landscape
x = np.linspace(-3,3,201)
y = np.linspace(-3,3,201)

z = peaks(x,y)

# let's have a look!
plt.imshow(z,extent=[x[0],x[-1],y[0],y[-1]],vmin=-5,vmax=5,origin='lower')
plt.show()
מפת הצבעים נוחה למעקב אחרי מסלול, אך קשה לחוש בה את הגובה. לכן נציג גם את המשטח במרחב:
from matplotlib import projections
# create a surface plot with the jet color scheme
figure = plt.figure(figsize=(10, 8))
axis = plt.subplot(projection='3d')
grid_x, grid_y = np.meshgrid(x, y)
axis.plot_surface(grid_x, grid_y, z, cmap='jet', vmin=-5, vmax=5)

# Add labels and a title
axis.set_xlabel('X-axis')
axis.set_ylabel('Y-axis')
axis.set_zlabel('Z-axis (f(x,y))')
axis.set_title('Peaks')

# Adjust view angle for better visualization
axis.view_init(elev=30, azim=-45)

# show the plot
plt.show()
כדי לקבל תחושה למספרים שמאחורי הצבעים, נחשב את ערך הפונקציה בשלוש נקודות:
print(peaks(0.5,-1.5))
print(peaks(0.5,2))
print(peaks(0,0))
פלט
[[-5.76161334]]
[[4.56754951]]
[[0.98101184]]
הנקודה (0.5, −1.5) נמצאת בעמק עמוק, הנקודה (0.5, 2) על פסגה גבוהה, והראשית קרובה לגובה אפס. התוצאות מודפסות כמערך דו־ממדי בגודל 1×1 מפני ש־meshgrid פועלת גם על מספר בודד.
הגדרת הפונקציה באמצעות טנסורים
הגרסה של NumPy טובה לציור, אך Autograd יודע לעקוב רק אחרי פעולות על טנסורים. לכן נגדיר את אותה פונקציה פעם נוספת, הפעם עם torch.exp במקום np.exp, כפי שעשינו בפרק הקודם. נשתמש בפעולות של PyTorch כדי שנוכל לחשב נגזרות:
def Peaks(x, y):
    return 3*(1-x)**2 * torch.exp(-(x**2) - (y+1)**2) \
            - 10*(x/5 - x**3 - y**5) * torch.exp(-x**2-y**2) \
            - 1/3*torch.exp(-(x+1)**2 - y**2)
כעת נבחר נקודת התחלה על המפה. שני המשתנים הם טנסורים במעקב, בדיוק כמו המשקל w בפרק הקודם, אלא שהפעם יש שניים. נתחיל מהנקודה (1.5, −1). נאתחל את שני המשתנים ואת קצב הלמידה:
# Initialize parameters
X = torch.tensor(1.5, dtype=torch.float32 ,requires_grad=True)
Y = torch.tensor(-1.0, dtype=torch.float32,requires_grad=True)
learning_rate = 0.01
print (X, Y)
פלט
tensor(1.5000, requires_grad=True) tensor(-1., requires_grad=True)
בפרק הקודם הכרנו את האופטימייזר SGD, שמבצע את כלל העדכון בשבילנו. הוא מקבל רשימה של הפרמטרים שעליו לעדכן; בפרק הקודם הייתה בה משתנה אחד, ועכשיו שניים. ניצור אופטימייזר שמקבל את שני המשתנים:
# init optimizer
optimizer = torch.optim.SGD([X,Y], lr=learning_rate)
חישוב Gradient Descent
כעת נפעיל את החיפוש ונעקוב אחר המסלול על המשטח. הלולאה זהה במבנה ללולאה מהפרק הקודם: חישוב קדימה, חישוב לאחור, צעד של האופטימייזר ואיפוס הנגזרות. קריאה אחת ל־backward() מחשבת את שתי הנגזרות החלקיות, ו־optimizer.step() מעדכן את שני המשתנים יחד. התוספת היחידה היא שתי רשימות שבהן נשמור את המיקום בכל צעד, כדי שנוכל לצייר את המסלול בסוף. נבצע 200 איטרציות. בכל איטרציה נשמור את המיקום ברשימות, נחשב את הנגזרות, נעדכן את שני המשתנים ונאפס את הנגזרות:
x_lst, y_lst = [], []
for epoch in range (200):
    # Forward
    Z = Peaks(X,Y)

    x_lst.append(X.item())
    y_lst.append(Y.item())

    # Calculate gradients
    Z.backward()

    if epoch % 10 == 0:
        print(f"epoch= {epoch} \t X,Y = {X.item():.3f}, {Y.item():.3f} \t Z={Z:.3f} \t X_grad, Y_grad= {X.grad:.3f} , {Y.grad:.3f}")

    # Update parameters
    optimizer.step()


    # Zero gradients
    optimizer.zero_grad()

print(f"End X,Y = {X.item():.3f}, {Y.item():.3f} Z={Z:.3f}")
השורה האחרונה של הפלט:
פלט
End X,Y = 0.228, -1.626 Z=-6.551
החיפוש הגיע לנקודה (0.228, −1.626), שגובהה −6.551: עמק נמוך אף מהנקודה (0.5, −1.5) שבדקנו קודם, שגובהה היה −5.76. ההדפסה בכל עשר איטרציות מאפשרת לעקוב אחרי המיקום, הגובה ושתי הנגזרות לאורך הדרך.
נציג את המסלול ואת נקודת הסיום על מפת הפונקציה. הרשימות x_lst ו־y_lst שאספנו בלולאה מצוירות כנקודות ורודות, ונקודת הסיום מסומנת בכוכב אדום:
plt.imshow(z,extent=[x[0],x[-1],y[0],y[-1]],vmin=-5,vmax=5,origin='lower')
plt.plot(x_lst, y_lst, '*', color='pink', markersize=2)
plt.plot(X.item(), Y.item(),'*', color='red')
plt.show()
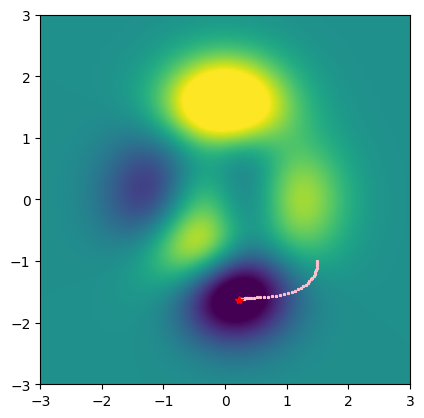
בפרק הקודם ראינו שהאלגוריתם נעצר בעמק הראשון שאליו הוא מגיע. במשטח עם כמה עמקים זה אומר שהתוצאה תלויה בנקודה שממנה יצאנו. כעת שנו את נקודת ההתחלה של Peaks ל־(−1, −1) והריצו שוב 200 איטרציות בקצב 0.01. מתקבלת נקודת סיום אחרת:
פלט
End X,Y = -1.347, 0.205 Z=-3.050
זו דוגמה להשפעת נקודת ההתחלה על המינימום המקומי שאליו מגיע החיפוש. הפעם הגענו לעמק בגובה −3.050, רדוד מהעמק הקודם שגובהו −6.551. האלגוריתם אינו "יודע" שקיים עמק עמוק יותר; הוא רואה רק את השיפוע מתחת לרגליו. באימון רשתות זו הסיבה לכך שאתחול המשקלים משפיע על התוצאה, ושלעיתים מריצים את האימון כמה פעמים מאתחולים שונים.
תרגיל
בתרגיל הבא נבדוק בשיטתיות את שני הגורמים שמשפיעים על התוצאה: נקודת ההתחלה וקצב הלמידה. שימו לב במיוחד לשורה האחרונה, שבה קצב הלמידה גדול במיוחד, וזכרו מה קרה בפרק הקודם כשקצב הלמידה היה גדול מדי. הריצו שוב את החיפוש ב־Peaks עם צירופי האתחול וקצב הלמידה הבאים, והסבירו את ההבדלים בתוצאות:
| קצב למידה | x התחלתי | y התחלתי |
|---|---|---|
| 0.1 | 0 | 1.5 |
| 0.1 | 0 | 2 |
| 0.01 | 0 | −1 |
| 0.01 | −2 | 0 |
| 0.5 | −2 | 0 |
לאחר מכן נעבור לפונקציה חדשה ופשוטה יותר, שיש לה בור אחד וגבעה אחת. חפשו נקודת מינימום של הפונקציה:
$$ f(x,y)=xe^{-(x^2+y^2)} $$
נציג תחילה את הפונקציה. שימו לב שהפעם ערכי הפונקציה קטנים בהרבה מאלה של Peaks, ולכן תחום הצבעים vmin ו־vmax הותאם ל־−0.5 עד 0.5; בלי ההתאמה הזו המפה הייתה נראית כמעט אחידה:
def graph(x,y):
    x,y = np.meshgrid(x,y)
    return x * np.exp(-(x**2+y**2))

# create the landscape
x = np.linspace(-3,3,201)
y = np.linspace(-3,3,201)

z = graph(x,y)

# let's have a look!
plt.imshow(z,extent=[x[0],x[-1],y[0],y[-1]],vmin=-0.5,vmax=0.5,origin='lower')
plt.show()
נגדיר אותה באמצעות טנסורים ונריץ 2,000 איטרציות מנקודת ההתחלה (0.5, 1). מספר האיטרציות גדול פי עשרה מבדוגמת Peaks מפני שהמשטח כאן מתון: הנגזרות קטנות, ולכן, באותו קצב למידה, כל צעד קטן ונדרשים צעדים רבים יותר:
def f(x,y):
    return x * torch.exp(-(x**2+y**2))

x_lst, y_lst = [], []
# Initialize parameters
X = torch.tensor(0.5, dtype=torch.float32 ,requires_grad=True)
Y = torch.tensor(1, dtype=torch.float32,requires_grad=True)
learning_rate = 0.01

# init optimizer
optimizer = torch.optim.SGD([X,Y], lr=learning_rate)

for epoch in range(2000):
    # Forward
    F = f(X,Y)

    x_lst.append(X.item())
    y_lst.append(Y.item())

    # Calculate gradients
    F.backward()

    # Update parameters
    optimizer.step()

    if epoch % 100 == 0:
        print(f"epoch= {epoch} \t X,Y = {X.item():.3f}, {Y.item():.3f} \t F={F:.3f} \t X_grad, Y_grad= {X.grad:.3f} , {Y.grad:.3f}")

    # zero Grads
    optimizer.zero_grad()

print(f"End X,Y = {X.item():.3f}, {Y.item():.3f} F={F:.3f}")
השורה האחרונה של הפלט:
פלט
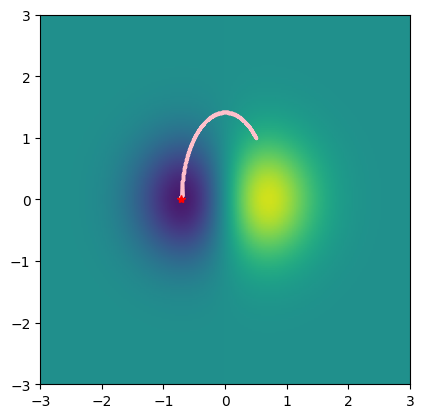
End X,Y = -0.707, 0.000 F=-0.429
החיפוש נעצר ב־(−0.707, 0), שם ערך הפונקציה הוא −0.429. אפשר לבדוק את זה גם בדרך שלמדנו בפרק Autograd: לגזור ולהשוות לאפס. הנגזרת לפי y מתאפסת כש־y=0, והנגזרת לפי x מתאפסת כש־1−2x²=0, כלומר x=±1/√2≈±0.707; הערך השלילי הוא המינימום. הפעם הפונקציה פשוטה מספיק לפתרון ידני, ו־Gradient Descent הגיע לאותה תשובה.
שימו לב להבדל קטן בסדר השורות בלולאה: כאן ההדפסה נמצאת אחרי optimizer.step(). בפלט שבתוך לולאה זו, x ו־y מוצגים אחרי העדכון, ואילו ערך הפונקציה והנגזרות חושבו לפניו.
נציג את מסלול החיפוש:
plt.imshow(z,extent=[x[0],x[-1],y[0],y[-1]],vmin=-0.5,vmax=0.5,origin='lower')
plt.plot(x_lst, y_lst, '*', color='pink', markersize=2)
plt.plot(X.item(), Y.item(),'*', color='red')
plt.show()
נציג גם את המשטח במרחב:
# create a surface plot with the jet color scheme
figure = plt.figure()
axis = plt.subplot(projection='3d')
grid_x, grid_y = np.meshgrid(x, y)
axis.plot_surface(grid_x, grid_y, z, cmap='jet')
# show the plot
plt.show()
תרגילים נוספים
שתי הפונקציות הבאות לקוחות מאוסף פונקציות מבחן מקובלות לאלגוריתמי אופטימיזציה: יש בהן כמה עמקים בגבהים שונים, ולכן הן מתאימות לבדוק אם החיפוש מגיע לעמק העמוק ביותר או נתקע בעמק רדוד. המשיכו בחיפוש מינימום לשתי הפונקציות הבאות. שימו לב לתחומי הצירים ולתחומי הצבעים vmin ו־vmax בגרפים; בכל פונקציה יש לבחור אותם כך שהעמקים ייראו בבירור.
תרגיל 2
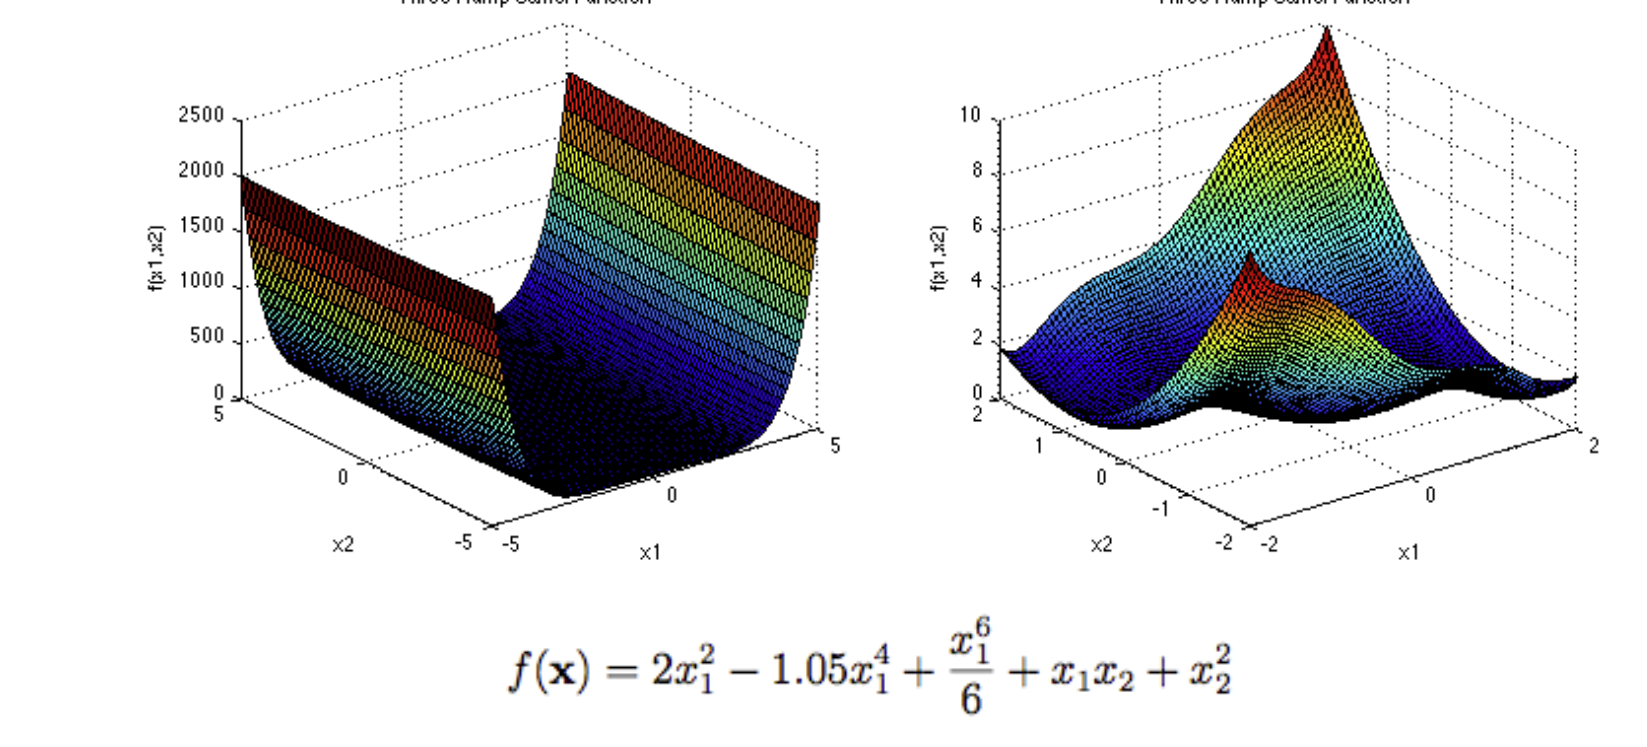
$$ f(x_1,x_2)=2x_1^2-1.05x_1^4+\frac{x_1^6}{6}+x_1x_2+x_2^2 $$
נגדיר את הפונקציה ונציג אותה:
def F(x1,x2):
    return 2*x1**2 - 1.05*x1**4 + x1**6 / 6 + x1*x2 + x2**2

# create the landscape
x1_v = np.linspace(-3,3,201)
x2_v = np.linspace(-3,3,201)
x1_mesh,x2_mesh = np.meshgrid(x1_v,x2_v)

z = F(x1_mesh,x2_mesh)

# let's have a look!
plt.imshow(z,extent=[x1_v[0],x1_v[-1],x2_v[0],x2_v[-1]],vmin=-0.5,vmax=2,origin='lower')
plt.show()
נריץ את החיפוש מנקודת ההתחלה (1, 0), בקצב 0.01, במשך 2,000 איטרציות:
x1_lst, x2_lst = [], []
# Initialize parameters
x1 = torch.tensor(1, dtype=torch.float32 ,requires_grad=True)
x2 = torch.tensor(0, dtype=torch.float32,requires_grad=True)
learning_rate = 0.01

# init optimizer
optimizer = torch.optim.SGD([x1,x2], lr=learning_rate)

for epoch in range(2000):
    # Forward
    f = F(x1,x2)

    x1_lst.append(x1.item())
    x2_lst.append(x2.item())

    # Calculate gradients
    f.backward()

    # Update parameters
    optimizer.step()

    if epoch % 100 == 0:
        print(f"epoch= {epoch} \t X,Y = {x1.item():.3f}, {x2.item():.3f} \t F={f.item():.3f} \t X_grad, Y_grad= {x1.grad:.3f} , {x2.grad:.3f}")

    # zero Grads
    optimizer.zero_grad()

print(f"End X,Y = {x1.item():.3f}, {x2.item():.3f} F={f:.3f}")
השורה האחרונה של הפלט:
פלט
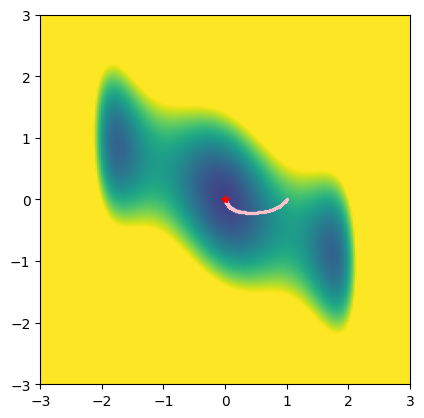
End X,Y = 0.000, -0.000 F=0.000
החיפוש הגיע לראשית הצירים, שבה ערך הפונקציה הוא 0. נציג את המסלול:
plt.imshow(z,extent=[x1_v[0],x1_v[-1],x2_v[0],x2_v[-1]],vmin=-0.5,vmax=2,origin='lower')
plt.plot(x1_lst, x2_lst, '*', color='pink', markersize=2)
plt.plot(x1.item(), x2.item(),'*', color='red')
plt.show()
תרגיל 3
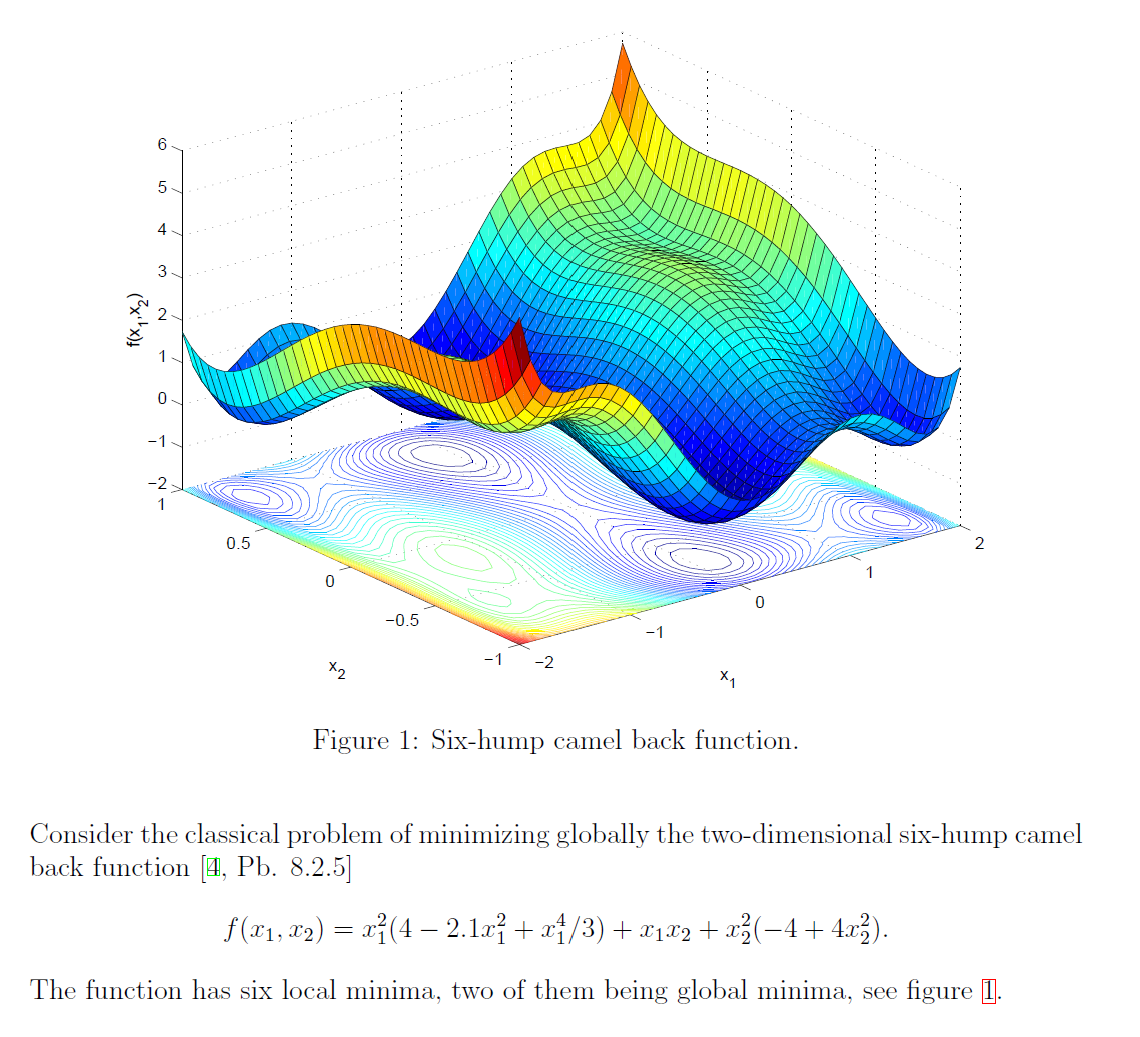
לפונקציה שש נקודות מינימום מקומי, ששתיים מהן הן גם מינימום גלובלי. מינימום גלובלי הוא הנקודה הנמוכה ביותר במשטח כולו, לעומת מינימום מקומי, שהוא רק הנמוך ביותר בסביבתו. זו הזדמנות לבדוק אם Gradient Descent מוצא את אחת משתי הנקודות הנמוכות באמת או נעצר באחד מארבעת העמקים הרדודים.
$$ f(x_1,x_2)=x_1^2\left(4-2.1x_1^2+\frac{x_1^4}{3}\right)+x_1x_2+x_2^2(-4+4x_2^2) $$
נגדיר את הפונקציה ונציג אותה:
def F(x1,x2):
    return x1**2*(4-2.1*x1**2 + x1**4/3) + x1*x2 + x2**2 * (-4 + 4 * x2**2)

# create the landscape
x1_v = np.linspace(-2,2,201)
x2_v = np.linspace(-1.2,1.2,201)
x1_mesh,x2_mesh = np.meshgrid(x1_v,x2_v)

z = F(x1_mesh,x2_mesh)

# let's have a look!
plt.imshow(z,extent=[x1_v[0],x1_v[-1],x2_v[0],x2_v[-1]],vmin=-1,vmax=1,origin='lower')
plt.show()
נריץ את החיפוש מנקודת ההתחלה (1, 0), בקצב 0.01, במשך 2,000 איטרציות:
x1_lst, x2_lst = [], []
# Initialize parameters
x1 = torch.tensor(1, dtype=torch.float32 ,requires_grad=True)
x2 = torch.tensor(0, dtype=torch.float32,requires_grad=True)
learning_rate = 0.01

# init optimizer
optimizer = torch.optim.SGD([x1,x2], lr=learning_rate)

for epoch in range(2000):
    # Forward
    f = F(x1,x2)

    x1_lst.append(x1.item())
    x2_lst.append(x2.item())

    # Calculate gradients
    f.backward()

    # Update parameters
    optimizer.step()

    if epoch % 100 == 0:
        print(f"epoch= {epoch} \t X,Y = {x1.item():.3f}, {x2.item():.3f} \t F={f.item():.3f} \t X_grad, Y_grad= {x1.grad:.3f} , {x2.grad:.3f}")

    # zero Grads
    optimizer.zero_grad()

print(f"End X,Y = {x1.item():.3f}, {x2.item():.3f} F={f:.3f}")
השורה האחרונה של הפלט:
פלט
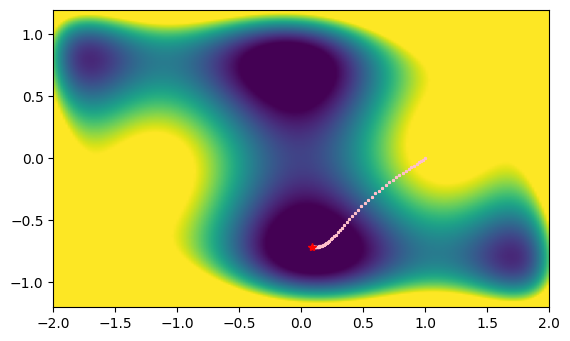
End X,Y = 0.090, -0.713 F=-1.032
החיפוש נעצר בנקודה (0.090, −0.713) בגובה −1.032. השוו את הנקודה הזו לתרשים קווי הגובה שלמעלה ובדקו אם הגענו לאחת משתי נקודות המינימום הגלובלי. נסו גם נקודות התחלה אחרות וראו לאילו מששת העמקים מגיעים. נציג את המסלול:
plt.imshow(z,extent=[x1_v[0],x1_v[-1],x2_v[0],x2_v[-1]],vmin=-0.5,vmax=2,origin='lower')
plt.plot(x1_lst, x2_lst, '*', color='pink', markersize=2)
plt.plot(x1.item(), x2.item(),'*', color='red')
plt.show()
סיימנו את החלק שבו למדנו את האלגוריתם על פונקציות "מלאכותיות". יש לנו עתה שיטה שמוצאת מינימום של פונקציה בכל מספר של משתנים, בעזרת נגזרות ש־Autograd מחשב. בפרק הבא נחליף לראשונה את הפונקציה המלאכותית בפונקציית הפסד אמיתית, שמודדת עד כמה מודל טועה על נתונים, ונשתמש באותה לולאה בדיוק כדי למצוא את המשקלים הטובים ביותר.