ג.10 רגרסיה לינארית במספר משתנים
עד עכשיו כל המודלים שלנו קיבלו מספר אחד וחזו מספר אחד: מחיר דירה לפי שטחה בלבד. אבל מי שקנה אי פעם דירה יודע שהמחיר תלוי בהרבה יותר מגורם אחד — בקומה, במספר החדרים, בגיל הבניין, במרחק מהים. שתי דירות באותו שטח יכולות להיות שונות מאוד במחירן. גם בתחומים אחרים כך: ציון במבחן תלוי בשעות הלימוד וגם בשעות השינה; צריכת הדלק של מכונית תלויה במהירות, במשקל ובשיפוע הכביש. כדי לחזות היטב צריך מודל שיודע לשקלל כמה נתוני קלט יחד.
הרעיון של רגרסיה במספר משתנים — Multivariable Regression הוא הרחבה טבעית של מה שכבר למדנו. במקום ישר y = wx + b, שבו משקל אחד מכפיל קלט אחד, לכל נתון קלט יהיה משקל משלו, והתחזית היא סכום כל הקלטים כשכל אחד מוכפל במשקלו, ועוד ההטיה. המשקל של כל תכונה מבטא עד כמה היא "חשובה" לתחזית: משקל גדול פירושו שהתכונה משפיעה הרבה על התוצאה, ומשקל קרוב לאפס פירושו שכמעט אינה משפיעה. תהליך האימון אינו משתנה כלל — יש פשוט יותר פרמטרים למצוא, ו־Gradient Descent מטפל בכולם בבת אחת.
בפרק זה נראה שכמעט כל מה שכתבנו בפרקים הקודמים נשאר כפי שהוא: אותה שכבה nn.Linear, רק עם שני קלטים במקום אחד; אותה לולאת אימון; ואותו נרמול מהפרק הקודם, אלא שכעת יש לנרמל כל עמודת קלט בנפרד, כי לשטח ולקומה סולמות שונים לגמרי. זהו גם הצעד הראשון לקראת רשתות נוירונים, שבהן כל נוירון מבצע בדיוק את החישוב הזה: סכום משוקלל של קלטים.
נמשיך בדוגמת מחירי הדירות, והפעם נתחשב גם בשטח הדירה וגם בקומה. נחפש פונקציה בשני משתנים:
price(area, floor) = W₁ × area + W₂ × floor + W₃
המשקלים W₁ ו־W₂ שייכים לשטח ולקומה, ו־W₃ הוא ההטיה (bias). גאומטרית, אם בפרקים הקודמים חיפשנו קו ישר במישור, כאן אנו מחפשים מישור במרחב תלת־ממדי: שני צירים לקלטים (שטח וקומה) וציר אחד לתוצאה (מחיר). לכל דירה נקודה במרחב הזה, ואנו מחפשים את המישור שעובר קרוב ככל האפשר לכל הנקודות.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 6.1. רגרסיה לינארית במספר משתנים (עותק מקומי) · מחברת התרגול (עותק מקומי)
מספר משתנים ונגזרות חלקיות
אלגוריתם האימון נשאר כפי שהכרנו. ההפסד הוא עתה פונקציה של שלושה פרמטרים, וכדי לדעת לאיזה כיוון להזיז כל אחד מהם משתמשים בנגזרת חלקית — Partial Derivative: הנגזרת של ההפסד לפי פרמטר אחד, כשכל שאר הפרמטרים מוחזקים קבועים. זהו בדיוק הרעיון שראינו ב־Gradient Descent בשני משתנים, ו־Autograd מחשב את כל הנגזרות החלקיות בקריאה אחת ל־backward(). מחשבים נגזרת חלקית של ההפסד ביחס לכל פרמטר, ומעדכנים אותו בהתאם: כאן יש שני משקלים והטיה, כלומר שלושה פרמטרים נלמדים.
הכנת הנתונים
נשתמש באותן תשע דירות מהפרק הקודם, אך הפעם לא נתעלם מהקומה. נכין את שטח הדירה ואת הקומה כשני נתוני קלט, לצד המחיר שאותו נרצה לחזות.
נייבא את הספריות:
import torch
import numpy as np
import matplotlib.pyplot as plt
import torch.nn as nn
נגדיר מערך לשטח, מערך לקומה ומערך למחיר במיליוני שקלים, ונציג את המחירים מול השטח. שורת ההערה בקוד מגלה כיצד נוצרו המחירים: נוסחה לינארית של השטח והקומה, ולכן מודל לינארי בשני משתנים אמור להתאים להם היטב:
X_np = np.array([92,105,101,109,112,122,131,130,141])
F_np = np.array([3,2,9,3,7,3,6,1,5])
P_np = np.array([2.462,2.661,3.177,2.972,3.321,3.226,3.648,3.447,3.848])
# P_np = np.around((X_np * 25.5 + F_np * 55.5)/1000, decimals=3)
plt.scatter(X_np, P_np)
print(P_np)
פלט
[2.462 2.661 3.177 2.972 3.321 3.226 3.648 3.447 3.848]
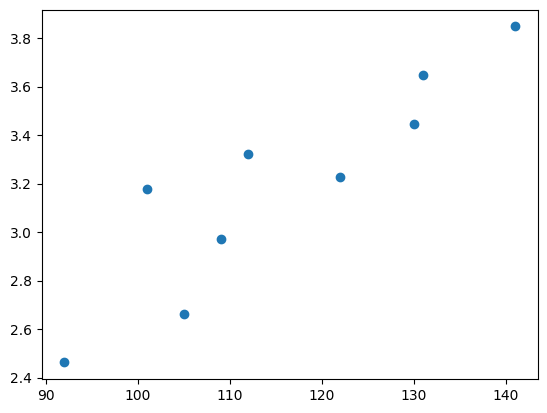
שימו לב שהנקודות אינן על קו ישר אחד: למשל, הדירה בת 101 המ"ר יקרה מהדירה בת 109 המ"ר, כי היא בקומה 9 ולא בקומה 3. הקומה היא המידע החסר שמודל של שטח בלבד לא יכול להסביר.
הכנת הטנסורים
מודל עם כמה קלטים מצפה לקבל את כל הקלטים של דוגמה אחת יחד, כשורה אחת בטבלה. לכן נמיר את המערכים לטנסורים ונשרשר את השטח ואת הקומה בעמודות בעזרת torch.cat עם dim=1 (חיבור לרוחב, עמודה ליד עמודה). כל שורה ב־X מייצגת דירה: תחילה השטח ואחריו הקומה; ב־Y מופיע המחיר. זהו המבנה הסטנדרטי של נתונים בלמידת מכונה: שורה לכל דוגמה, עמודה לכל תכונה.
X1 = torch.from_numpy(X_np.astype(np.float32))  # area
X2 = torch.from_numpy(F_np.astype(np.float32))  # floor
Y = torch.from_numpy(P_np.astype(np.float32))   # price
Y = Y.reshape(-1,1)
X1 = X1.reshape(-1,1)
X2 = X2.reshape(-1,1)
X = torch.cat((X1,X2),dim=1)

print(X)
print(Y)
פלט
tensor([[ 92.,   3.],
        [105.,   2.],
        [101.,   9.],
        [109.,   3.],
        [112.,   7.],
        [122.,   3.],
        [131.,   6.],
        [130.,   1.],
        [141.,   5.]])
tensor([[2.4620],
        [2.6610],
        [3.1770],
        [2.9720],
        [3.3210],
        [3.2260],
        [3.6480],
        [3.4470],
        [3.8480]])
נרמול הנתונים
בפרק הקודם למדנו שנתונים בסדרי גודל שונים מקשים על האימון, וכאן הבעיה חריפה במיוחד: השטחים הם מספרים בין 92 ל־141, ואילו הקומות בין 1 ל־9. אם ננרמל את הטבלה כולה לפי ערך מינימום ומקסימום אחד, הקומות יידחסו לערכים זעירים והמודל כמעט לא "ירגיש" אותן. לכן בנרמול של כמה תכונות נבחין בין ערכים של הטנסור כולו לערכים של כל עמודה בנפרד. תחילה נמצא את הערך הקטן ביותר בכל הטנסור:
print(X.min())
פלט
tensor(1.)
התוצאה, 1, היא הקומה הנמוכה ביותר — ערך שאינו אומר דבר על השטחים. לנרמול נצטרך מינימום ומקסימום לכל עמודה בנפרד. הפעולות עם dim=0 פועלות "לאורך השורות", כלומר מחזירות תוצאה אחת לכל עמודה, ומחזירות גם את הערכים וגם את אינדקסי השורות שבהן נמצאו:
min, minIndex = X.min(dim=0)
max, maxIndex = X.max(dim=0)
print (min, minIndex)
print (max, maxIndex)
פלט
tensor([92.,  1.]) tensor([0, 7])
tensor([141.,   9.]) tensor([8, 2])
קיבלנו לכל עמודה את המינימום שלה (92 לשטח, 1 לקומה) ואת המקסימום שלה (141 ו־9), ולצדם את מספרי השורות שבהן הם נמצאים. כעת נגדיר נרמול Min–Max ואת הפעולה ההפוכה, המחזירה את הנתונים לסולם המקורי. מכיוון ש־min ו־max הם טנסורים עם ערך לכל עמודה, החיסור והחילוק מתבצעים אוטומטית עמודה־עמודה. נגדיר גם נרמול Z, שמשתמש בממוצע ובסטיית התקן של כל עמודה; בדוגמה נפעיל את Min–Max.
def Normalize_minMax(X):
    return (X - min) / (max - min)

def UnNormalize_minMax(X):
    return X * (max-min) + min

def Normalize_z(X):
    return (X - X.mean(dim=0)) / X.std(dim=0)
ננרמל את X, נדפיס אותו ונבדוק שהפעולה ההפוכה אכן מחזירה את הערכים המקוריים — בדיקה פשוטה שמוודאת שלא איבדנו מידע בדרך:
X = Normalize_minMax(X)
print(min, max)
print (X)
print (UnNormalize_minMax(X))
פלט
tensor([92.,  1.]) tensor([141.,   9.])
tensor([[0.0000, 0.2500],
        [0.2653, 0.1250],
        [0.1837, 1.0000],
        [0.3469, 0.2500],
        [0.4082, 0.7500],
        [0.6122, 0.2500],
        [0.7959, 0.6250],
        [0.7755, 0.0000],
        [1.0000, 0.5000]])
tensor([[ 92.,   3.],
        [105.,   2.],
        [101.,   9.],
        [109.,   3.],
        [112.,   7.],
        [122.,   3.],
        [131.,   6.],
        [130.,   1.],
        [141.,   5.]])
בטבלה המנורמלת שתי העמודות נעות עתה בין 0 ל־1: הדירה הקטנה ביותר (92 מ"ר) קיבלה 0 בעמודת השטח והגדולה ביותר (141) קיבלה 1, ובאותו אופן הקומה 1 הפכה ל־0 והקומה 9 ל־1. הטבלה השלישית זהה לנתונים המקוריים, כנדרש.
הגדרת המודל, ההפסד והאופטימייזר
כאן נמצא השינוי היחיד במודל לעומת הפרק הקודם: מספר הקלטים. נגדיר nn.Linear(2, 1, bias=True): שני קלטים, פלט אחד והטיה. השכבה תיצור בעצמה שני משקלים — אחד לשטח ואחד לקומה — והטיה אחת, בדיוק שלושת הפרמטרים W₁, W₂, W₃ מהנוסחה שבפתיחה. נשתמש ב־MSE וב־SGD, בקצב למידה 0.1 וב־1,000 צעדי אימון. השורה המוערת מזכירה שאפשר להחליף את SGD ב־Adam, כפי שראינו בפרק הקודם.
learning_rate = 0.1
epochs = 1000
losses = []

# design model
Model = nn.Linear(2, 1, bias=True)  #in_features = 2; out_features=1

#construct loss and optimizer
Loss = nn.MSELoss()

# init optimizer
optim = torch.optim.SGD(Model.parameters(), lr=learning_rate)
# optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
לולאת האימון
לולאת האימון זהה לזו של הפרקים הקודמים; העובדה שיש שני קלטים אינה משנה בה אף שורה. בכל צעד נחשב תחזיות, הפסד ונגזרות, נעדכן את הפרמטרים ונאפס את הנגזרות לקראת הצעד הבא. אחת ל־20 אפוקים נדפיס את ההפסד, ונשמור את כל ערכיו ברשימה לצורך הגרף.
for epoch in range(epochs):
    # forward
    Y_predict = Model(X)

    # backward
    loss = Loss(Y_predict, Y)
    loss.backward()

    # update wights
    optim.step()

    if epoch % 20 == 0:
        print(f"epoch= {epoch} loss={loss.item():.9f} ")
        # print (Y_predict)

    losses.append(loss.item())

    # zero grads
    optim.zero_grad()
שורות ראשונות ואחרונה מתוך פלט האימון השמור; האתחול האקראי עשוי לשנות את הפלט בהרצה חדשה.
פלט
epoch= 0 loss=14.559171677
epoch= 20 loss=0.018344976
epoch= 40 loss=0.011297960
...
epoch= 980 loss=0.003825781
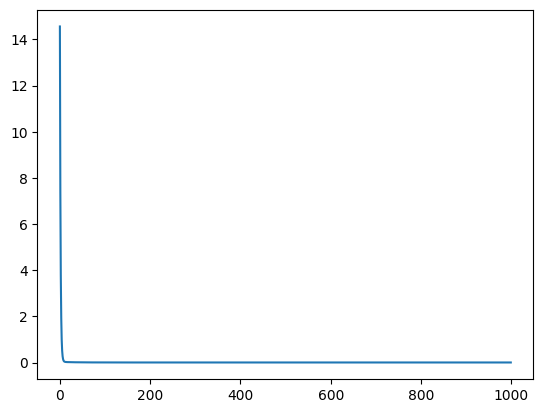
ההפסד יורד מכ־14.6 לכ־0.018 כבר אחרי 20 אפוקים — ירידה חדה שמעידה על כך שהנרמול עשה את שלו — ואחר כך ממשיך לרדת לאט עד כ־0.0038. מכיוון שהמחירים הם במיליוני שקלים, הפסד של 0.0038 פירושו שגיאה ריבועית ממוצעת קטנה מאוד.
נציג את ההפסד לאורך האימון:
plt.plot(losses)
הצגת התוצאה
כשיש שני קלטים איננו יכולים לצייר את המודל כקו ישר על גרף דו־ממדי, ולכן נבחר דרך אחרת להציג את ההתאמה: נצייר לכל דירה את מחירה האמיתי ואת המחיר שהמודל חוזה, ונבדוק עד כמה הם קרובים. נציג את המחירים בכחול ואת התחזיות בכוכביות אדומות. החיזוי משתמש גם בקומה, אף שהציר האופקי בגרף מציג רק את השטח. השורות המוערות בקוד מראות כיצד לחזות מחיר לדירות חדשות: יש לנרמל אותן באותה פונקציה ובאותם מינימום ומקסימום לפני שמעבירים אותן למודל, כפי שלמדנו בפרק הקודם.
print(f"END: loss={loss.item():.4f}")
plt.scatter(X_np, P_np, color='b')
plt.xlabel("x")
plt.ylabel("Y")

with torch.no_grad():
    predicted = Model(X).detach().numpy()
    plt.scatter (X_np, predicted, marker='*', s=20, color='r')


#   apartment = torch.tensor([[110, 4], [112,9]], dtype=torch.float32)
#   apartment_size = apartment[:,0]
#   apartment_price = Model(Normalize_minMax(apartment))
#   print(Normalize_minMax(apartment))
#   print (apartment, '\n',apartment_price)
#   plt.scatter(apartment_size,apartment_price, color='g' )
plt.show()
# P_np = np.around((X_np * 25.5 + F_np * 55.5)/1000, decimals=3)
דוגמת פלט שמור:
פלט
END: loss=0.0038
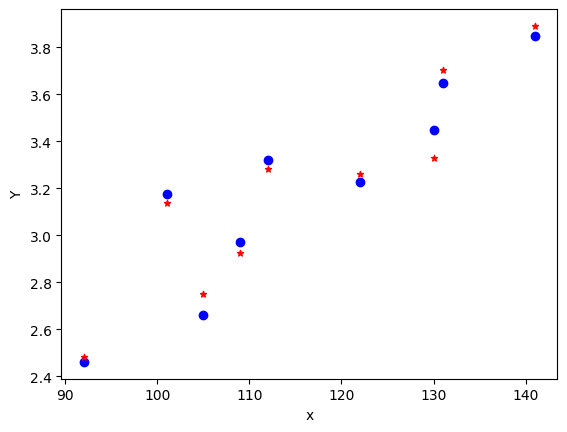
ההפסד הסופי הנמוך, 0.0038, אומר שהכוכביות האדומות צמודות לנקודות הכחולות — גם במקומות שבהם הנקודות "קופצות" בגלל הקומה, מה שמודל של שטח בלבד לא היה יכול לתפוס.
הצגת המשקלים
הפרמטרים שנלמדו קובעים כיצד השטח והקומה משתתפים בתחזית. נציג את שני המשקלים ואת ההטיה. הפעם weight יכיל שני מספרים, אחד לכל קלט:
for name, param in Model.named_parameters():
    print(name, param)
דוגמת פלט שמור:
פלט
weight Parameter containing:
tensor([[1.2669, 0.5587]], requires_grad=True)
bias Parameter containing:
tensor([2.3454], requires_grad=True)
נקרא את התוצאה. המשקל הראשון, כ־1.27, שייך לשטח, והשני, כ־0.56, לקומה; ההטיה היא כ־2.35. יש לזכור שהמשקלים מתייחסים לקלט המנורמל: מעבר מהדירה הקטנה ביותר לגדולה ביותר (מ־0 ל־1 בעמודת השטח) מוסיף למחיר כ־1.27 מיליון שקל, ומעבר מקומה 1 לקומה 9 מוסיף כ־0.56 מיליון. ההטיה, כ־2.35 מיליון, היא המחיר החזוי לדירה "בסיסית" של 92 מ"ר בקומה 1. כך המשקלים לא רק מאפשרים חיזוי אלא גם מספרים לנו כיצד כל תכונה משפיעה על המחיר.