ד.5 — תכנון דינמי: Value Iteration
המצגת: תכנון דינמי — המשך · השיעור באתר הקורס · קוד: Agent.py · Game.py · מאגר GridWorld בגיטהב
בפרק הקודם החזקנו שתי טבלאות: טבלת הערכים V, ובה מספר לכל מצב, וטבלת המדיניות π, ובה חץ לכל מצב. Policy Iteration עבד בשני שלבים לסירוגין: חישוב מלא של טבלת הערכים של המדיניות הנוכחית, ואחריו שיפור המדיניות לפי הטבלה החדשה. עכשיו נשאל שאלה מעניינת: האם אפשר לדעת מטבלת הערכים לבדה מהי המדיניות? כלומר, האם בכלל צריך להחזיק טבלת מדיניות?
התשובה היא שאין צורך. כשהמודל ידוע, טבלת הערכים משמשת לנו כמדיניות: בכל מצב בודקים לאן מובילה כל פעולה, מסתכלים בטבלת הערכים, ובוחרים את הפעולה הטובה ביותר. זה בדיוק החישוב שעשינו בשלב השיפור, רק שבמקום לרשום את התוצאה בטבלה נפרדת, עושים את החישוב הקצר הזה בכל פעם שצריך לבחור פעולה.
ומכאן צעד אחד לאלגוריתם חדש, Value Iteration, שעובד ללא טבלת מדיניות כלל, והוא גם יעיל יותר: במקום לחשב במדויק את הערכים של מדיניות שממילא עומדים להחליף, הוא משלב את בחירת הפעולה הטובה ביותר בתוך כל עדכון של הטבלה, ומגיע לאותה טבלת ערכים מיטבית בפחות סריקות. בפרק הזה נלמד את האלגוריתם, נדגים אותו על לוח 4×4, ובסופו נממש אותו בעולם הגריד. בפרק הבא ניישם אותו על בעיה גדולה באמת: פאזל המספרים, ובו מאות אלפי מצבים.
בחירת פעולה מטבלת הערכים
נתחיל מן השאלה שפתחנו בה. נניח שיש בידינו טבלת ערכים כלשהי, לאו דווקא סופית, והסוכן נמצא במצב s. איך בוחרים פעולה בלי טבלת מדיניות? בדיוק כמו בסריקת השיפור בפרק הקודם:
- רושמים את הפעולות האפשריות במצב s.
- לכל פעולה שואלים את המודל לאיזה מצב s′ היא מובילה ומה התגמול r על המעבר.
- קוראים מטבלת הערכים את V(s′) ומחשבים לפי נוסחת בלמן r + 0.9·V(s′).
- בוחרים את הפעולה שנתנה את המספר הגדול ביותר.
נדגים על טבלת ערכים באמצע החישוב, כשהמידע על היעד התפשט רק בחלק מהלוח. הלוח הוא לוח 4×4 מהפרק הקודם: התא האדום (1,2) עם תגמול −1, היעד הירוק (3,3) עם תגמול 1, הספירה מתחילה ב־0 מלמעלה ומשמאל, ופעולה אל מחוץ ללוח משאירה את הסוכן במקומו:
| 0 | 0 | 0.73 | 0.81 |
| 0 | 0.73 | 0 | 0.9 |
| 0.73 | 0.81 | 0.9 | 1 |
| 0.81 | 0.9 | 1 | 0 |
הסוכן נמצא בתא (0,3), הפינה הימנית העליונה. בודקים את ארבע הפעולות:
| פעולה | לאן מובילה | r | V(s′) | r + 0.9·V(s′) |
|---|---|---|---|---|
| למעלה | מחוץ ללוח, נשאר ב־(0,3) | 0 | 0.81 | 0.73 |
| ימינה | מחוץ ללוח, נשאר ב־(0,3) | 0 | 0.81 | 0.73 |
| שמאלה | (0,2) | 0 | 0.73 | 0.66 |
| למטה | (1,3) | 0 | 0.9 | 0.81 |
המספר הגדול ביותר הוא 0.81, של ״למטה״, ולכן זו הפעולה שהסוכן יבצע. לא היה צורך בשום טבלת מדיניות: טבלת הערכים והמודל הספיקו.
עוד דוגמה, בתא (2,3) שמעל היעד: ״למטה״ נכנסת ליעד ונותנת 1 + 0.9·0 = 1; ״למעלה״ מובילה ל־(1,3) ונותנת 0.81; ״שמאלה״ מובילה ל־(2,2) ונותנת 0.81; ״ימינה״ משאירה במקום ונותנת 0.9. ״למטה״ מנצחת. שימו לב: ערכו של תא היעד בטבלה הוא 0, כי ממנו המשחק אינו ממשיך, ובכל זאת הכניסה אליו היא הפעולה הטובה ביותר. לכן מחשבים תמיד r + 0.9·V(s′), ולא בוחרים סתם את השכן בעל הערך הגבוה ביותר: התגמול על המעבר עצמו הוא חלק מהחשבון.
Value Iteration — האלגוריתם במילים
אם אפשר לבחור פעולה מתוך V בכל רגע, אפשר לשלב את הבחירה בתוך חישוב הטבלה עצמו. ניזכר איך עבדה הערכת המדיניות בפרק הקודם: בכל תא חישבנו r + 0.9·V(s′) לפעולה אחת בלבד, זו שהמדיניות קבעה, וחזרנו על הסריקות עד שהטבלה התייצבה. רק אחרי כל הסריקות האלה שיפרנו את המדיניות, ואז התחלנו מחזור הערכה חדש. חלק גדול מהעבודה הזאת מתבזבז: חישבנו במדויק את ערכיה של מדיניות שממילא עומדים להחליף.
Value Iteration מייעל את זה בשני שינויים:
- מוותרים על טבלת המדיניות ועל שלב השיפור. ברגע שיש טבלת ערכים מעודכנת יש לנו אוטומטית גם מדיניות, כפי שראינו זה עתה.
- בוחרים את הפעולה הטובה ביותר תוך כדי עדכון הטבלה. בכל תא, במקום לחשב את הערך של הפעולה שהמדיניות קבעה, בודקים את כל הפעולות ורושמים בתא את הציון הגבוה ביותר, כאילו במצב הזה נבחרה תמיד הפעולה הטובה ביותר.
איננו מחכים לסיום כל הסריקות של הערכת המדיניות; אחרי כל סריקה, ולמעשה אחרי כל תא, ״המדיניות״ כבר התעדכנה. במקום מחזורים של הערכה מלאה ושיפור, מבצעים בכל תא צעד הערכה אחד וצעד שיפור אחד יחד.
מה זה אומר בפועל? סורקים את הטבלה כמו קודם: שורה אחר שורה, מלמעלה למטה, ובכל שורה משמאל לימין. בכל תא שאינו תא סיום:
- רושמים את הפעולות האפשריות בתא.
- לכל פעולה: שואלים את המודל לאן היא מובילה ומה התגמול, קוראים מטבלת הערכים את ערך המצב שמגיעים אליו, ומחשבים r + 0.9·V(s′).
- משווים את המספרים שהתקבלו ולוקחים את הגדול ביותר.
- כותבים אותו בתא במקום הערך הישן.
ההבדל היחיד מהערכת המדיניות הוא בצעדים 2 ו־3: בודקים את כל הפעולות ולוקחים את המקסימום, במקום פעולה אחת שהמדיניות קבעה. אין טבלת מדיניות ואין שלב שיפור נפרד. הערך החדש נכתב מיד בטבלה, ולכן תא שנסרק מאוחר יותר באותה סריקה כבר רואה אותו. חוזרים על סריקות עד שהשינוי הגדול ביותר בסריקה קטן מן הדיוק שקבענו, בדיוק כמו קודם.
הדגמה — Value Iteration בלוח 4×4
נריץ את האלגוריתם על אותו לוח: התא האדום (1,2) עם תגמול −1, היעד הירוק (3,3) עם תגמול 1, γ=0.9, וטבלת ערכים שכולה אפסים. תאי הסיום מדלגים עליהם וערכם נשאר 0. זו נקודת המוצא:
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 |
סריקה ראשונה, יד ביד.
- התא (0,0): ארבע הפעולות מובילות לתאים שערכם 0 או משאירות במקום, וכולן נותנות 0. המקסימום 0; שום דבר לא השתנה. כך גם (0,1).
- התא (0,2): ״למטה״ מובילה לתא האדום: −1 + 0.9·0 = −1. שלוש הפעולות האחרות נותנות 0. המקסימום הוא 0, ולכן התא נשאר 0. זה הבדל ראשון מהפרק הקודם: שם המדיניות ״למטה״ כפתה על התא הזה את הערך −1; כאן בוחרים את הטוב ביותר, והירידה לתא האדום פשוט לא נבחרת.
- התא (0,3): ״למטה״ מובילה ל־(1,3), שערכו עדיין 0. התוצאה 0.
- השורה השנייה: (1,0) ו־(1,1) נותנים 0 (ב־(1,1) ״ימינה״ מובילה לתא האדום ונותנת −1, ואינה נבחרת). את (1,2) מדלגים. ב־(1,3) ״למטה״ מובילה ל־(2,3), שערכו עדיין 0 כי טרם הגענו אליו בסריקה הזאת. התוצאה 0.
- השורה השלישית: (2,0), (2,1) ו־(2,2) נותנים 0. ב־(2,3) ״למטה״ נכנסת ליעד: 1 + 0.9·0 = 1. כותבים 1. זה השינוי הראשון בטבלה.
- השורה הרביעית: (3,0) ו־(3,1) נותנים 0. ב־(3,2) ״ימינה״ נכנסת ליעד ונותנת 1. כותבים 1.
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 1 |
| 0 | 0 | 1 | 0 |
השינוי הגדול ביותר בסריקה הזאת הוא 1, ולכן ממשיכים.
סריקה שנייה, יד ביד.
- השורה הראשונה: כל התאים נותנים 0. גם (0,3): ״למטה״ מובילה ל־(1,3), שערכו עדיין 0 כי הוא נסרק אחרי (0,3).
- התא (1,3): ״למטה״ מובילה ל־(2,3), שערכו 1: 0 + 0.9·1 = 0.9. כותבים 0.9.
- התא (2,1): ״ימינה״ מובילה ל־(2,2) ו״למטה״ ל־(3,1), ושניהם עדיין 0. נשאר 0.
- התא (2,2): ״ימינה״ מובילה ל־(2,3) ו״למטה״ ל־(3,2), ושניהם שווים 1: שתי הפעולות נותנות 0.9. כותבים 0.9.
- התא (3,1): ״ימינה״ מובילה ל־(3,2), שערכו 1: 0.9. כותבים 0.9.
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0.9 |
| 0 | 0 | 0.9 | 1 |
| 0 | 0.9 | 1 | 0 |
סריקות 3 עד 6. בכל סריקה המידע על היעד מתקדם צעד נוסף אחורה, ובכל צעד הערך מוכפל ב־0.9: 0.81, אחר כך 0.73, 0.66 ולבסוף 0.59. שימו לב לתא (0,2) בסריקה הרביעית: ״ימינה״ מובילה ל־(0,3), שערכו כבר 0.81, ולכן התא שמעל התא האדום מקבל 0.73 בלי לרדת לעולם אל −1.
| 0 | 0 | 0 | 0.81 |
| 0 | 0 | 0 | 0.9 |
| 0 | 0.81 | 0.9 | 1 |
| 0.81 | 0.9 | 1 | 0 |
| 0 | 0 | 0.73 | 0.81 |
| 0 | 0.73 | 0 | 0.9 |
| 0.73 | 0.81 | 0.9 | 1 |
| 0.81 | 0.9 | 1 | 0 |
| 0 | 0.66 | 0.73 | 0.81 |
| 0.66 | 0.73 | 0 | 0.9 |
| 0.73 | 0.81 | 0.9 | 1 |
| 0.81 | 0.9 | 1 | 0 |
| 0.59 | 0.66 | 0.73 | 0.81 |
| 0.66 | 0.73 | 0 | 0.9 |
| 0.73 | 0.81 | 0.9 | 1 |
| 0.81 | 0.9 | 1 | 0 |
בסריקה השביעית אף תא אינו משתנה: השינוי הגדול ביותר הוא 0, קטן מכל דיוק שנבחר, והלולאה נעצרת. השינוי הגדול ביותר בכל סריקה היה 1, 0.9, 0.81, 0.73, 0.66, 0.59 ואז 0, בדיוק כמו שהסביר המשפט על ההתכנסות בפרק הקודם.
התוצאה. משמאל טבלת הערכים הסופית, בעיגול לשלוש ספרות. זו בדיוק הטבלה שאליה הגיע Policy Iteration בפרק הקודם, אבל שם נדרשו לכך 10 סריקות הערכה ועוד 3 סריקות שיפור, וכאן 7 סריקות בלבד. מימין המדיניות שנגזרת ממנה: החצים אינם שמורים בשום טבלה; כל חץ מתקבל מבדיקת ארבע הפעולות בתא, כפי שעשינו בסעיף הראשון. בתאים שבהם שתי פעולות שקולות, למשל (0,0), שבו ״ימינה״ ו״למטה״ נותנות שתיהן 0.59, אפשר לבחור כל אחת מהן; כאן מוצגת בחירה אחת:
| 0.590 | 0.656 | 0.729 | 0.810 |
| 0.656 | 0.729 | 0 | 0.900 |
| 0.729 | 0.810 | 0.900 | 1.000 |
| 0.810 | 0.900 | 1.000 | 0 |
| ↓ | → | → | ↓ |
| ↓ | ↓ | סיום | ↓ |
| ↓ | ↓ | ↓ | ↓ |
| → | → | → | סיום |
Bootstrapping — לומדים מהערכות קיימות
כדאי לעצור רגע ולשים לב למה שעשינו, כי הרעיון יחזור בפרקים הבאים בלבוש אחר. הערך של מצב מתעדכן מתוך ערך משוער של מצב אחר. בתחילת החישוב גם ההערכה הזאת אינה מדויקת, הרי התחלנו מטבלה של אפסים, ואפשר היה להתחיל אפילו ממספרים אקראיים, ובכל זאת היא מאפשרת להתקדם. אחרי מספיק סריקות הערכים מתכנסים לערכים הנכונים. שימוש באומדנים קיימים כדי לעדכן אומדנים אחרים נקרא Bootstrapping, מילולית: ״למשוך את עצמך למעלה בשרוכי המגפיים״.
בדוגמת הלוח אין לנו מראש טבלה נכונה. התגמול הידוע ליד היעד מספק נקודת התחלה, והעדכונים החוזרים מפיצים את המידע. אין צורך לחכות שכל ערכי ההמשך יהיו סופיים לפני שמשתמשים בהם.
כלל העדכון והפסאודו־קוד
עכשיו, אחרי שראינו את האלגוריתם פועל, אפשר לכתוב אותו בקצרה. בכל תא נכתב הציון הגבוה ביותר מבין הפעולות:
השוו למשוואת בלמן מהפרק הקודם: שם הפעולה a הייתה נתונה מן המדיניות, וכאן במקומה מופיע max על כל הפעולות האפשריות. זהו ההבדל היחיד, והוא זה שמייתר את טבלת המדיניות. max מחזירה מספר, והוא שנשמר בטבלת הערכים. בזמן המשחק משתמשים ב־argmax, שמחזירה את הפעולה שהביאה למספר הזה. ההבדל בין שתיהן חשוב: אחת מחשבת את הערך, והאחרת בוחרת מה לעשות.
הנה האלגוריתם השלם בפסאודו־קוד לסביבה דטרמיניסטית. מאתחלים את V בערכים אקראיים, פרט לתאי הסיום שמקבלים 0; קובעים דיוק קטן; ובכל סריקה עוברים על המצבים, בודקים בכל מצב את כל הפעולות החוקיות, שומרים את הערך הטוב ביותר ורושמים את השינוי הגדול ביותר. מסיימים כאשר תיקון הטבלה קטן מן הסף. בסיום מבצעים סריקת שיפור אחת, שמחלצת מטבלת הערכים טבלת מדיניות, כדי שהסוכן במשחק יוכל לשלוף פעולה ישירות מן הטבלה:
# Value iteration for Deterministic environment

# Initialization
for all s in S:
    V(s) = random(float) except V(terminal) = 0

def Value_Iteration(V):
    accuracy = 0.0001 (small number)
    acc = 1

    while acc > accuracy:
        acc = 0
        for s in all states:
            if s is terminal: continue
            best_value = min value
            for action in legal_actions(s):
                s', r = environment(s, action)
                new_value = r + gamma * V(s')
                best_value = max(best_value, new_value)
            old_value = V(s)
            V(s) = best_value
            acc = max(acc, abs(old_value - best_value))

    return Policy_improvement(V)
acc מודד את השינוי המרבי במהלך סריקה מלאה. אין לעצור רק מפני שתא מסוים לא השתנה: ייתכן שמידע עוד לא הגיע אליו. השורה האחרונה היא אפשרות ולא חובה: כשהסוכן בוחר פעולה מתוך V בכל מהלך, כפי שנעשה בפרק הבא, אין צורך בטבלת מדיניות כלל.
בספרם של Sutton ו־Barto האלגוריתם כתוב בניסוח כללי יותר, שבו המקסימום נלקח על סכום של כל המצבים הבאים האפשריים לפי ההסתברויות שלהם; זו הגרסה שמתאימה למשוואת בלמן המלאה שהוזכרה כרשות בפרק הקודם, ולא נשתמש בה.
תרגיל — Value Iteration בעולם הגריד
בתרגיל של הפרק הקודם השלמנו במאגר GridWorld_2 את שלוש השיטות של Policy Iteration, והשארנו בשלד של AI_Agent שיטה אחת ריקה:
    def Value_Iteration():
        pass
עכשיו תורה. שימו לב ששורת ההגדרה בשלד חסרה את self; בפתרון נכתוב אותה כמו שאר השיטות, def Value_iteration(self):.
המשימה. עצרו כאן ונסו לבד לפי הפסאודו־קוד, לפני שתמשיכו לפתרון:
- ממשו את
Value_iterationלפי הפסאודו־קוד: סריקות חוזרות על הטבלה, בכל תא בודקים את ארבע הפעולות ושומרים את הערך הגדול ביותר, עד שהתיקון קטן מ־accuracy. הסוכן משחק לפי טבלת המדיניות, ולכן בסיום קראו ל־Policy_improvכדי למלא אותה. - ב־
Game.pyהחליפו את שורתPolicy_Iterationבקריאה ל־Value_iteration, השאירו את שתי ההדפסות והריצו. השוו אתValue*ואתPolicy*לתוצאות של Policy Iteration. - הוסיפו מונה סריקות והדפיסו אותו: כמה סריקות נדרשו כאן, לעומת הסריקות של Policy Iteration?
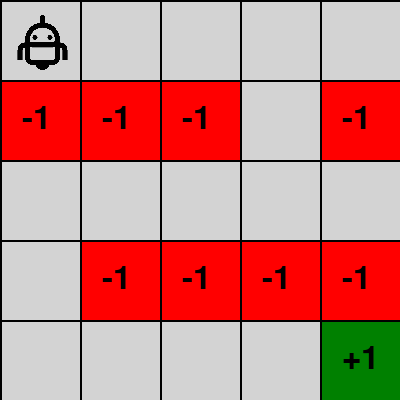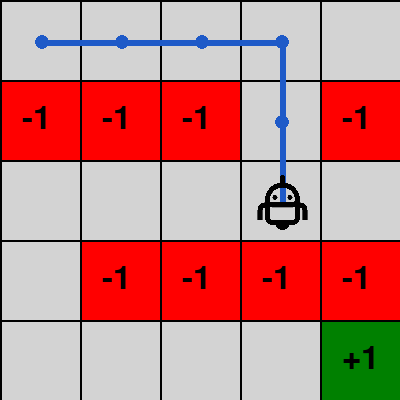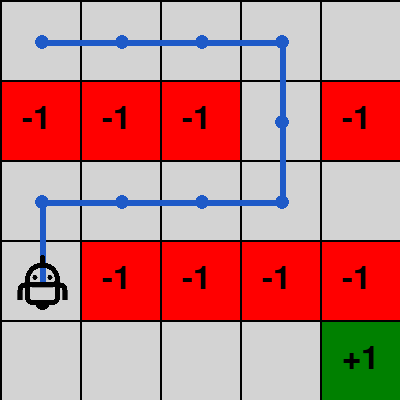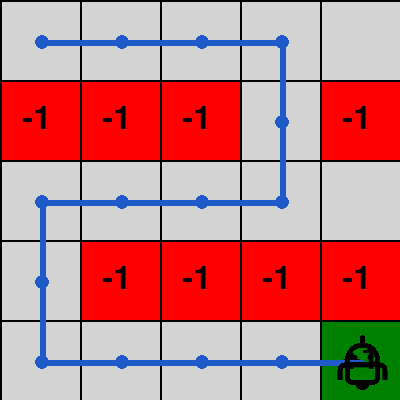
- נסו גם את המבוך 5×5.
פתרון — Value Iteration
הפתרון נמצא במאגר GridWorld בגיטהב, בקובץ Agent.py:
    def Value_iteration (self):
        accuracy = 0.0001
        acc = 1
        while acc> accuracy:
            acc = 0
            for row in range(ROWS):
                for col in range(COLS):
                    state = row, col
                    if self.env.board[state] != 0:
                        continue
                    best_value = -1000
                    for action in Action:   # only legal actions
                        new_state, reward = self.env(state, action)
                        new_value = reward + self.gamma * self.Value[new_state]
                        if new_value > best_value:
                            best_value = new_value
                    old_value = self.Value[state]
                    self.Value[state] = best_value
                    acc = max(acc, abs(old_value - best_value))

        self.Policy_improv()
השוו ל־policy_eval מהפרק הקודם: המעטפת זהה, שתי הלולאות על התאים, הדילוג על תאי הסיום ומדידת acc. ההבדל בתוך התא: במקום לקרוא פעולה אחת מטבלת המדיניות, לולאה על כל הפעולות מחשבת לכל אחת reward + self.gamma * self.Value[new_state] ושומרת ב־best_value את הגדול ביותר, וזה הערך שנכתב בתא. טבלת המדיניות אינה משתתפת בחישוב כלל. השורה האחרונה, self.Policy_improv(), ממלאת אותה פעם אחת בסיום מתוך טבלת הערכים, כדי ש־get_action תמשיך לעבוד כפי שהיא. כל ארבע הפעולות נבדקות בכל תא, כי פעולה לכיוון קצה הלוח משאירה את הסוכן במקומו, כמו בפרק הקודם.
בדיקה. ב־Game.py השורות אחרי יצירת הסוכן נראות עכשיו כך:
agent = AI_Agent(env)
agent.Value_iteration()
print ('Value*: \n', agent.Value)
print ('Policy*: \n', agent.Policy)
ההרצה בלוח 4×4 מדפיסה בטרמינל:
פלט
Value*:
 [[0.59049 0.6561  0.729   0.81   ]
 [0.6561  0.729   0.      0.9    ]
 [0.729   0.81    0.9     1.     ]
 [0.81    0.9     1.      0.     ]]
Policy*:
 [[1 1 1 3]
 [1 3 3 3]
 [1 1 1 3]
 [1 1 1 3]]
שתי הטבלאות זהות בדיוק לפלט של Policy_Iteration בפרק הקודם: אותה טבלת ערכים ואותה מדיניות (1 ימינה, 3 למטה), ולכן הרובוט הולך במסלול זהה עד היעד. ההבדל היחיד מן החצים שבהדגמה הוא בתאים שבהם שתי פעולות שקולות: הקוד בוחר את הראשונה לפי סדר ה־Enum, ולכן בפינה השמאלית העליונה הוא הולך ״ימינה״ ולא ״למטה״; שני המסלולים באותו אורך. מונה סריקות מראה 7 סריקות, שש עם שינוי ואחת שמאשרת שאין עוד שינוי, בדיוק כמו בהדגמה. במבוך 5×5 של המאגר מתקבלת אותה טבלת ערכים שקיבל Policy Iteration בפרק הקודם, הפעם ב־12 סריקות, והרובוט מגיע ליעד באותם 14 צעדים.
לסיום: שני האלגוריתמים בציור אחד
בספרות מקובל לצייר את שני האלגוריתמים כך: קו אחד מייצג את כל הטבלאות שמתאימות בדיוק למדיניות כלשהי, וקו שני את כל המדיניות שהן הבחירה הטובה ביותר לפי טבלה כלשהי. הפתרון המיטבי הוא נקודת המפגש של שני הקווים.
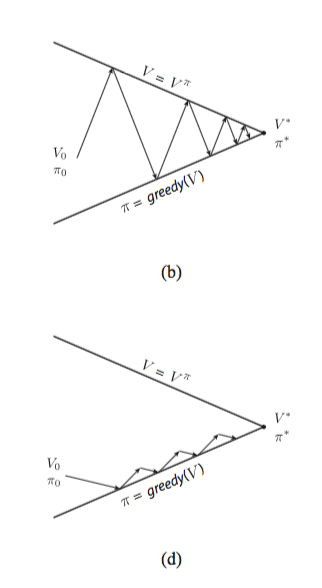
בפרק הבא ניקח את אותו אלגוריתם בדיוק, בלי לשנות בו רעיון, ונפעיל אותו על פאזל המספרים, שבו במקום 16 מצבים יש 362,880.