ג.8 רגרסיה עם הטיה ו־nn.Linear
בפרק הקודם למדנו להתאים לנתונים ישר מהצורה y = wx, וסיימנו בקבוצת נקודות שנוצרה מהנוסחה y = 2x + 5. ישר כזה אינו עובר בראשית הצירים, ולכן שום בחירה של w לבדה לא תתאר אותו: המודל שלנו "כבול" לנקודה (0, 0). זה מצב נפוץ מאוד בעולם האמיתי. מחיר של נסיעה במונית מתחיל מתעריף פתיחה גם לפני הקילומטר הראשון; חשבון חשמל כולל תשלום קבוע שאינו תלוי בצריכה; ובמדידת טמפרטורה יש קשר ישר בין צלזיוס לפרנהייט, אך 0 מעלות צלזיוס אינן 0 פרנהייט. בכל המקרים האלה הישר חוצה את ציר y בגובה שאינו אפס.
הפתרון הוא להוסיף למודל פרמטר שני, ההטיה — Bias, שמסומן b: המודל הופך ל־y = wx + b. המשקל w עדיין קובע את השיפוע, וההטיה b קובעת את הגובה שבו הישר חוצה את ציר y — כלומר את התחזית כשהקלט הוא אפס. שני הפרמטרים נלמדים יחד באותו תהליך בדיוק: לכל זוג (w, b) יש הפסד, ו־Gradient Descent מוצא את הזוג שממזער אותו, בדיוק כפי שמצאנו מינימום של פונקציה בשני משתנים בפרק ג.6.
בפרק זה נעשה את הדבר פעמיים. תחילה נבנה את המודל בעצמנו, עם שני טנסורים W ו־B, כדי לראות שאין כאן שום קסם. אחר כך נכיר את torch.nn, ספריית המודלים של PyTorch, ונראה שהיא מספקת את אותו מודל בשורה אחת — יחד עם פונקציית הפסד מוכנה. זהו הכלי שבו נבנה בהמשך גם רשתות נוירונים שלמות, ולכן חשוב לראות שהוא מסתיר בדיוק את מה שכתבנו ידנית.
נמשיך אפוא בהתאמת קו ישר, והפעם נוסיף הטיה המאפשרת לו לחתוך את ציר y גם מחוץ לראשית. נתאים את הקו ל־100 נקודות. נבנה תחילה את המודל באמצעות פרמטרים שנגדיר בעצמנו, ולאחר מכן נשתמש ב־torch.nn להגדרת אותו סוג של מודל.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 5.2. רגרסיה לינארית (עותק מקומי) · מחברת רגרסיה עם nn.Linear (עותק מקומי)
נייבא את הספריות. שתיים מהן חדשות: torch.nn היא ספריית המודלים של PyTorch, ו־sklearn.datasets היא חלק מספריית scikit-learn, שתשמש אותנו ליצירת נתוני דוגמה:
import torch
import numpy as np
import matplotlib.pyplot as plt
import torch.nn as nn
from sklearn import datasets
סדר העבודה נשאר כפי שהיה בפרק הקודם: הכנת נתונים, הגדרת מודל, הגדרת הפסד ואופטימייזר, ולולאת אימון הכוללת חיזוי, חישוב נגזרות ועדכון פרמטרים.
הכנת הנתונים
במקום להקליד נקודות ידנית, ניעזר בפונקציה מוכנה שמייצרת נתונים המתאימים לרגרסיה: היא בוחרת ישר, מפזרת סביבו נקודות ומוסיפה רעש אקראי, בדומה למה שעשינו בפרק הקודם עם torch.rand. ניצור 100 זוגות (x, y) באמצעות make_regression. לכל דוגמה יש תכונת קלט אחת; noise=20 מוסיף רעש, ו־bias=50 מוסיף איבר קבוע לנתוני y — כלומר הישר שממנו נוצרו הנתונים אינו עובר בראשית, וזו בדיוק הסיבה שאנו זקוקים להטיה. random_state=1 קובע את המספרים האקראיים כך שהנתונים יהיו זהים בכל הרצה.
x_np, y_np = datasets.make_regression(n_samples=100, n_features=1, noise=20, random_state=1, bias=50)
print (x_np.shape , y_np.shape)
plt.scatter(x_np, y_np, color='red')
plt.xlabel("x")
plt.ylabel("Y")
plt.show()
פלט
(100, 1) (100,)
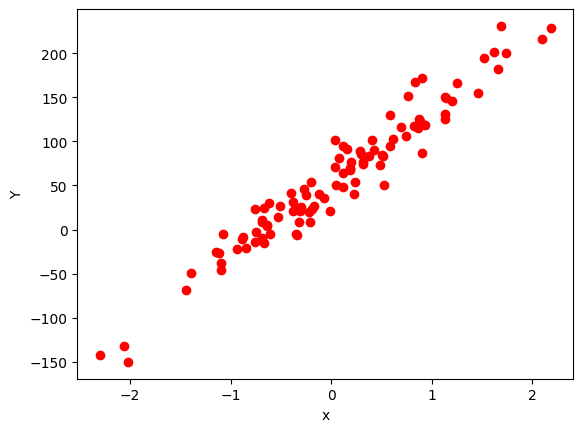
הפלט (100, 1) (100,) מספר לנו על צורת הנתונים: x הוא מערך של 100 שורות ועמודה אחת, ואילו y הוא מערך חד־ממדי של 100 ערכים. ההבדל הזה יחייב אותנו לטפל בצורה של y בסעיף הבא. מי שרוצה לראות את הערכים עצמם יכול להדפיס את שני המערכים:
print(x_np)
print(y_np)
המרה לטנסורים
הפונקציה make_regression מחזירה מערכי NumPy, ואילו האימון ב־PyTorch עובד על טנסורים. נמיר את הנתונים לטנסורים מסוג float32, הסוג שבו PyTorch עובד כברירת מחדל. מערך x כבר בנוי מ־100 שורות ועמודה אחת; מערך y הוא חד־ממדי, ולכן נעצב אותו גם כן ל־100 שורות ועמודה אחת. הפקודה reshape(-1,1) פירושה "עמודה אחת, ומספר השורות ייקבע לפי כמות הערכים".
# Prepare tensors

X = torch.from_numpy(x_np.astype(np.float32))
Y = torch.from_numpy(y_np.astype(np.float32))
# Y = Y.view(Y.shape[0],1)
Y = Y.reshape(-1,1)


print (X.shape, X.dtype)
print(Y.shape, Y.dtype)
# print (Y)
פלט
torch.Size([100, 1]) torch.float32
torch.Size([100, 1]) torch.float32
כך לכל שורת קלט מתאימה שורת תשובה אחת, ושני הטנסורים בעלי אותה צורה. ההקפדה על הצורות חשובה: כשנחסר בין התחזית ל־Y בפונקציית ההפסד, שני הטנסורים חייבים להיות באותה צורה, אחרת PyTorch עלול לחסר "כל אחד מכל אחד" ולתת תוצאה שגויה בלי הודעת שגיאה.
הגדרת הפרמטרים, המודל, ההפסד והאופטימייזר
כעת נבנה את המודל בעצמנו, בדיוק כמו בפרק הקודם, אלא שיש בו פרמטר נוסף. המודל הוא y = wx + b: המשקל w קובע את השיפוע, וההטיה b קובעת את החיתוך עם ציר y. לכן נגדיר שני פרמטרים, W ו־B, ונעביר את שניהם לאופטימייזר. שניהם מאותחלים לאפס, כלומר הישר ההתחלתי הוא ציר x עצמו, והאופטימייזר יעדכן את שניהם בכל צעד לפי הנגזרת של כל אחד.
נוסיף גם רשימה בשם losses לשמירת ערכי ההפסד, כדי שנוכל לצייר בסוף האימון גרף המראה כיצד ההפסד ירד מאיטרציה לאיטרציה:
W = torch.tensor([0.0], requires_grad=True)
B = torch.tensor([0.0], requires_grad=True)

learning_rate = 0.01
epochs = 1000
losses = []

# design model
def Model(X):
    return W * X + B

#construct loss and optimizer
def Loss (Y_predict, Y):
    return ((Y_predict-Y)**2).mean()   # (W * X + B - Y)^2

# optimizer
optimizer = torch.optim.SGD([W, B], lr=learning_rate) # W = W - grad * LR / B -= grad * LR
לולאת האימון
לולאת האימון זהה במבנה לזו שכתבנו בפרק הקודם. באימון נעדכן יחד את המשקל ואת ההטיה כדי להקטין את ההפסד: קריאה אחת ל־backward() מחשבת את הנגזרת לפי שני הפרמטרים, וקריאה אחת ל־optimizer.step() מעדכנת את שניהם. הלולאה range(epochs+1) מבצעת 1,001 איטרציות, ממספר 0 עד 1,000. בכל איטרציה נשמור את ההפסד ברשימה ונאפס את הנגזרות לאחר העדכון.
for epoch in range(epochs+1):
    # forward
    Y_predict = Model(X)

    # backward
    loss = Loss(Y_predict, Y)
    loss.backward()

    # Update parameters
    optimizer.step()  # W = W - grad * LR

    if epoch % 10 == 0:
        print(f"epoch= {epoch} loss={loss.item():.3f} ")

    losses.append(loss.item())

    # zero grads
    optimizer.zero_grad()
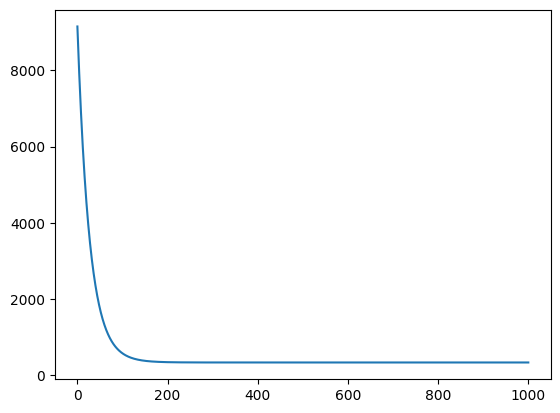
גרף ההפסד הוא הכלי הבסיסי ביותר לבדיקה שהאימון מתנהל כשורה: אנו מצפים לעקומה שיורדת במהירות בתחילה ואחר כך מתיישרת, כלומר ההפסד מתייצב ואין עוד מה לשפר. נציג את ההפסד לאורך האימון:
# print(losses)
plt.plot (losses)
הצגת התוצאה
נציג את ההפסד האחרון ואת הקו שהתקבל. כדי לצייר את הישר נחשב את תחזית המודל עבור כל ערכי X, בתוך torch.no_grad() כי אין צורך בנגזרות, ונמיר את התוצאה למערך NumPy באמצעות .detach().numpy():
print(f"END: loss={loss.item():.4f}")
plt.scatter(x_np, y_np, color='red')
plt.xlabel("x")
plt.ylabel("Y")

with torch.no_grad():
    predicted = Model(X).detach().numpy()
    plt.plot (x_np, predicted, color = "green")
    plt.show()
פלט
END: loss=332.5676
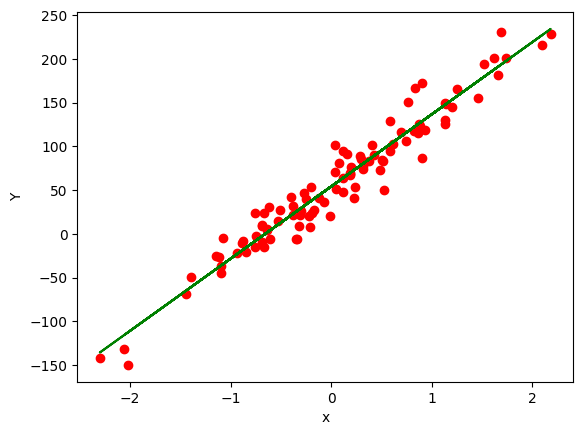
ההפסד הסופי, כ־332, נראה גדול לעומת הפרק הקודם, אך יש לזכור שהוא ממוצע של ריבועי שגיאות: הנתונים נוצרו עם רעש בסדר גודל של 20, וריבוע של 20 הוא 400. ההפסד הזה משקף אפוא את הרעש שבנתונים ולא כשל של המודל; הישר עצמו עובר יפה במרכז ענן הנקודות.
שימוש ב־torch.nn
עד עכשיו כתבנו את המודל ואת פונקציית ההפסד בעצמנו. עבור ישר עם שני פרמטרים זה קל, אך רשת נוירונים יכולה להכיל אלפי פרמטרים, ואיש אינו רוצה להגדיר כל אחד מהם ידנית. לשם כך קיימת הספרייה torch.nn, שמספקת אבני בניין מוכנות למודלים; כל אבן בניין כזו נקראת שכבה — Layer. PyTorch מספקת מודל לינארי מוכן. nn.Linear(1, 1, bias=True) מגדירה קלט אחד ופלט אחד, עם משקל והטיה, ומבצעת את החישוב wx+b — בדיוק הפונקציה Model שכתבנו למעלה. המספרים בסוגריים הם מספר ערכי הקלט ומספר ערכי הפלט; בפרקים הבאים נראה שכבות עם קלטים ופלטים רבים.
גם פונקציית ההפסד מוכנה: nn.MSELoss() מחשבת את ממוצע ריבועי השגיאות, בדיוק כמו הפונקציה Loss שלנו. השכבה יוצרת ומאתחלת את הפרמטרים בעצמה, בערכים אקראיים קטנים, ולכן איננו יכולים לכתוב [W, B] כבעבר; במקום זאת מעבירים לאופטימייזר את Model.parameters(), שמחזירה את כל הפרמטרים שהשכבה מחזיקה. שימו לב שהפעם נשתמש בקצב למידה גדול יותר, 0.1, ובפחות אפוקים — 100 במקום 1,000:
learning_rate = 0.1
epochs = 100
losses = []

# design model
Model = nn.Linear(1, 1, bias=True) # model = W * X + B

#construct loss and optimizer
Loss = nn.MSELoss() # Mean squared error

# init optimizer
optimizer = torch.optim.SGD(Model.parameters(), lr=learning_rate)
אימון המודל המוכן
לולאת האימון אינה משתנה כלל — זהו היופי של הגישה: החלפנו את המודל ואת פונקציית ההפסד ברכיבים מוכנים, אך הקריאות Model(X), Loss(...), backward(), step() ו־zero_grad() נשארות בדיוק כפי שהיו. נריץ את אותה לולאת אימון, הפעם בקצב 0.1 וב־101 איטרציות:
for epoch in range(epochs+1):
    # forward
    Y_predict = Model(X)

    # backward
    loss = Loss(Y_predict, Y)
    loss.backward()

    # Update parameters
    optimizer.step()

    if epoch % 10 == 0:
        print(f"epoch= {epoch} loss={loss.item():.3f} ")

    losses.append(loss.item())

    # zero grads
    optimizer.zero_grad()
הפלט השמור הבא מדגים את הירידה בהפסד; ערכי ההתחלה עשויים להשתנות מהרצה להרצה, משום שפרמטרי השכבה מאותחלים באקראי בכל פעם שיוצרים אותה.
פלט
epoch= 0 loss=9087.091
epoch= 10 loss=508.141
epoch= 20 loss=337.327
epoch= 30 loss=332.720
epoch= 40 loss=332.573
epoch= 50 loss=332.568
epoch= 60 loss=332.568
epoch= 70 loss=332.568
epoch= 80 loss=332.568
epoch= 90 loss=332.568
epoch= 100 loss=332.568
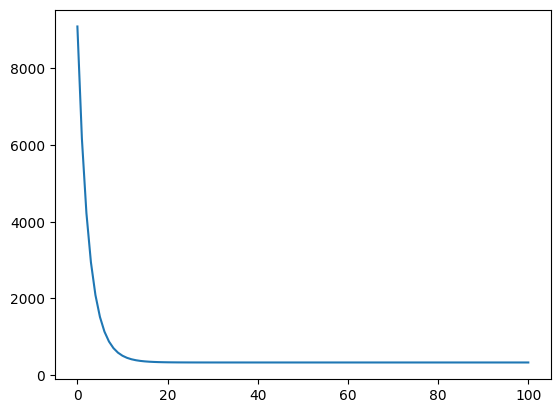
ההפסד צונח מכ־9,087 לכ־508 כבר אחרי עשרה אפוקים, ומהאפוק ה־50 הוא מתייצב על 332.568 ואינו משתנה עוד. זהו אותו הפסד סופי שקיבלנו במודל הידני — שני המודלים מצאו את אותו ישר. בזכות קצב הלמידה הגדול פי 10 נדרשו כאן רק כמה עשרות אפוקים במקום מאות. נציג את גרף ההפסד:
# print(losses)
plt.plot (losses)
הצגת התוצאה והפרמטרים
נציג את ההפסד האחרון ואת הישר שהתקבל:
print(f"END: loss={loss.item():.4f}")
plt.scatter(x_np, y_np, color='red')
plt.xlabel("x")
plt.ylabel("Y")

with torch.no_grad():
    predicted = Model(X).detach().numpy()
    plt.plot (x_np, predicted)
    plt.show()
פלט
END: loss=332.5675
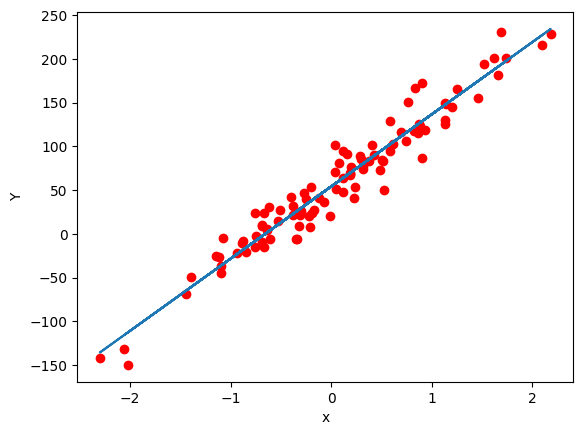
במודל הידני יכולנו פשוט להדפיס את W ואת B. בשכבה של torch.nn הפרמטרים חיים בתוך האובייקט, ואפשר לגשת אליהם באמצעות named_parameters(), שמחזירה לכל פרמטר את שמו ואת ערכו. נקרא את שמות הפרמטרים ואת ערכיהם:
# print(W)
for name, param in Model.named_parameters():
    print(name, param)
פלט
weight Parameter containing:
tensor([[82.4845]], requires_grad=True)
bias Parameter containing:
tensor([54.0540], requires_grad=True)
השכבה קוראת למשקל weight ולהטיה bias. הישר שנלמד הוא אפוא בקירוב y = 82.5x + 54. ההטיה שנלמדה, 54, קרובה ל־50 — הערך שנתנו ל־bias בעת יצירת הנתונים — והפער נובע מהרעש. המשקל מופיע כמטריצה של 1×1 ולא כמספר בודד, כי nn.Linear בנויה מראש למספר כלשהו של קלטים ופלטים.
חיזוי
הגענו למטרה שלשמה עשינו את כל זה: לאחר האימון אפשר להשתמש במודל כדי לחזות תוצאות עבור קלטים חדשים, כאלה שלא היו בין 100 הנקודות. נעביר למודל שלוש דוגמאות חדשות: 0, 1 ו־1.5, ונציג את התחזיות. הקלט חייב להיות טנסור באותה צורה שעליה אומן המודל — עמודה אחת — ולכן כל דוגמה כתובה בסוגריים משלה:
test = torch.tensor(([0],[1], [1.5]), dtype=torch.float32);
with torch.no_grad():
    print(Model(test))
פלט
tensor([[ 54.0540],
        [136.5385],
        [177.7808]])
התחזיות מתיישבות עם הפרמטרים שקראנו: עבור קלט 0 המודל מחזיר בדיוק את ההטיה, 54.054; עבור קלט 1 הוא מחזיר משקל ועוד הטיה, כ־136.5; ועבור 1.5 — כ־177.8. זוהי ההכללה שדיברנו עליה בפרק הקודם: המודל לא ראה מעולם את הקלט 1.5, ובכל זאת נתן לו הערכה המבוססת על הקשר שלמד.