ד.4 — תכנון דינמי: Policy Iteration
המצגת: תכנון דינמי · השיעור באתר הקורס · קוד: Agent.py · Environement.py · Game.py · מאגר GridWorld בגיטהב
בפרק הקודם הגדרנו את המושגים: מצב, פעולה, תגמול, מדיניות וערך של מצב. עכשיו אפשר לשאול את השאלה המעשית הראשונה: אם אנחנו יודעים את חוקי המשחק במלואם — לאיזה מצב מוביל כל מהלך ומה התגמול עליו — איך מחשבים את המהלך הטוב ביותר בכל מצב? זה המצב ב־Grid World, בפאזל המספרים ובכל משחק שהמודל שלו ידוע לנו. בפרק זה ובפרק הבא הסוכן עדיין אינו "לומד" מניסיון; הוא מחשב, כמו שמחשבים מסלול קצר במפה שכל כבישיה ידועים.
בפרק הקודם הצבנו את המטרה: למצוא אלגוריתם שמחשב את המדיניות המיטבית, שנסמן π* (במצגות: P*). בלוח קטן שהחוקים שלו ידועים אפשר לחשב אילו מהלכים כדאי לבצע, עוד לפני שמשחקים בפועל. לכל מצב נשמור ערך בטבלה. נתחיל ממדיניות פשוטה, נחשב לאן היא מובילה, ונשפר אותה על סמך התוצאות. השיטה הזו נקראת תכנון דינמי — Dynamic Programming: מפרקים חישוב של מסלול ארוך לחישובים קטנים הקשורים זה בזה, והתוצאות של החישובים הקטנים נשמרות בטבלה (או במבנה נתונים אחר) שמחזיקה את כל המצבים האפשריים בסביבה.
הפתרון הזה מתאים רק לסביבה שבה מרחב המצבים קטן יחסית וניתן לשמירה בזיכרון המחשב: בלוח 4×4 יש 16 מצבים, ואפילו איקס עיגול נכנס בטבלה. בשחמט או במשחק מחשב מספר המצבים גדול מכדי לשמור טבלה, ושם נצטרך לשדרג את האלגוריתם של בלמן; זה מה שנעשה בהמשך החלק, כשנחליף את הטבלה ברשת נוירונים.
את השיטה פיתח בשנות החמישים המתמטיקאי האמריקני ריצ׳ארד בלמן, והמשוואה שעליה היא נשענת קרויה על שמו. נלמד אותה תחילה, ואחריה נבנה בעזרתה את האלגוריתם הראשון שלנו, Policy Iteration.
משוואת בלמן: צעד אחד וההמשך שלו
בפרק הקודם חישבנו את ערך המצב V כסכום כל התגמולים לאורך המסלול עד סוף המשחק, כשכל תגמול רחוק מוכפל ב־γ פעם נוספת. חישוב כזה יקר: בכל מצב צריך לעקוב אחר מסלול שלם, ובלוח גדול המסלולים ארוכים. בלמן הראה שאפשר לחשב את הערך מצעד אחד קדימה בלבד. הפיתוח הוא אלגברה פשוטה בארבעה צעדים, ונעבור עליהם בזה אחר זה. למושגי הערך וההיוון ראו פרק המודל.
צעד 1 — כותבים את הערך כסכום. נניח שהסוכן נמצא במצב s0 ופועל לפי מדיניות נתונה π. הסביבה דטרמיניסטית: בכל מצב המדיניות קובעת פעולה אחת, והמודל קובע מצב הבא אחד ותגמול אחד. לכן המסלול קבוע מראש: s0 → s1 → s2 → … → sT, ובדרך מתקבלים התגמולים r1, r2, …, rT. ערך המצב s0 לפי המדיניות π הוא התשואה של המסלול הזה:
צעד 2 — מוציאים γ מחוץ לסוגריים. נסתכל על כל האיברים מלבד הראשון: γr2, γ²r3, γ³r4 וכן הלאה. בכל אחד מהם מופיע γ לפחות פעם אחת. נכתוב כל איבר כך שיהיה בו γ אחד "מבחוץ" וכל השאר "מבפנים": γ²r3 הוא γ·γr3, ו־γ³r4 הוא γ·γ²r4. עכשיו ה־γ שמבחוץ משותף לכל האיברים האלה, ואפשר להוציא אותו מחוץ לסוגריים, בדיוק כמו ש־6+9 = 3·(2+3):
במספרים, עם γ=0.9 ותגמולים 1, 2, 3: הסכום 1 + 0.9·2 + 0.81·3 שווה ל־1 + 0.9·(2 + 0.9·3). בשני המקרים התוצאה 5.23.
צעד 3 — מזהים את הסוגריים. נסתכל על מה שנשאר בתוך הסוגריים: r2 + γr3 + γ²r4 + …. זה בדיוק אותו סוג של סכום כמו בצעד 1, רק שהוא מתחיל צעד אחד מאוחר יותר, מהמצב s1. כלומר, הסוגריים הם ערך המצב s1:
כאן נכנסת תכונת מרקוב מהפרק הקודם: הערך של s1 תלוי רק ב־s1 עצמו ובמדיניות, ולא בדרך שבה הגענו אליו. לכן מותר לנו לקרוא לסכום שבסוגריים "הערך של s1", בלי לזכור שבאנו מ־s0.
צעד 4 — מציבים. מחליפים את הסוגריים ב־Vπ(s1) ומקבלים:
הפיתוח לא תלוי בכך שהתחלנו דווקא מ־s0; הוא נכון לכל מצב s, למצב הבא שלו s′ ולתגמול r שמתקבל במעבר ביניהם. בכתיב הכללי:
זו משוואת בלמן — Bellman Equation למדיניות נתונה בסביבה דטרמיניסטית. היא תלווה אותנו בכל הספר: כל אלגוריתם שנלמד מכאן והלאה, עד DQN, בנוי עליה. במילים: הערך של מצב הוא התגמול שמקבלים בצעד הקרוב, ועוד הערך של המצב שמגיעים אליו, מוכפל ב־γ. המשוואה מאפשרת לעדכן תא בטבלה באמצעות תא אחר, במקום לסכום מחדש מסלול שלם בכל פעם. שימו לב שהמשוואה מגדירה את V באמצעות V עצמה — הערך של מצב תלוי בערך של המצב הבא. זה לא מעגל סתום: כפי שנראה מיד, אפשר להתחיל מטבלה של אפסים ולהחיל את המשוואה שוב ושוב עד שהערכים מתייצבים. אם המצב הבא סופי, ערכו 0, ולכן נשאר רק התגמול המיידי.
בדיקה במספרים. ניקח γ=0.9 כמו בפרק הקודם, ומסלול של שלושה צעדים שבו שני הצעדים הראשונים נותנים 0 והצעד השלישי מגיע ליעד ונותן 1. לפי הסכום המלא מצעד 1:
ולפי משוואת בלמן, מהסוף להתחלה: המצב s2 נמצא צעד אחד לפני היעד, ולכן V(s2) = 1 + 0.9·0 = 1. אחריו V(s1) = 0 + 0.9·1 = 0.9, ולבסוף V(s0) = 0 + 0.9·0.9 = 0.81. שתי הדרכים נותנות אותו מספר, אבל בדרך של בלמן כל חישוב הוא חיבור אחד וכפל אחד. כך המידע על היעד יכול להתפשט בטבלה — מהיעד אחורה, תא אחר תא, כמו גלים במים.
אותו פיתוח עבור Q. ערך מצב–פעולה Qπ(s,a) הוא התשואה כשמתחילים ב־s, מבצעים את הפעולה a, ומכאן והלאה ממשיכים לפי המדיניות. הסכום זהה לסכום שבצעד 1, ולכן ארבעת הצעדים חוזרים על עצמם מילה במילה. ההבדל היחיד: הסוגריים שמתקבלים בצעד 2 הם התשואה מ־s′ כשממשיכים לפי המדיניות, כלומר Q של s′ עם הפעולה שהמדיניות בוחרת בו, a′=π(s′):
π(a|s) היא ההסתברות שהמדיניות תבחר את הפעולה a במצב s, ו־p(s′,r|s,a) היא ההסתברות שהסביבה תעבור למצב s′ ותיתן תגמול r. הביטוי בסוגריים המרובעים הוא בדיוק הצד הימני של המשוואה הפשוטה שלנו. בסביבה דטרמיניסטית יש בכל סכום רק אפשרות אחת, בהסתברות 1, ושני הסכומים נעלמים — ונשארת המשוואה שפיתחנו. הסביבות בספר הזה דטרמיניסטיות, ולכן לא נשתמש בצורה המלאה; היא מובאת כאן רק כדי שתזהו אותה כשתפגשו אותה בספרים ובמאמרים.
חישוב פונקציית הערך למדיניות נתונה — Policy Evaluation
נדגים עכשיו איך מקבלים מדיניות כלשהי ומוצאים את טבלת הערכים התואמת לה באמצעות משוואת בלמן. זו עדיין לא המדיניות המיטבית ולא פונקציית הערך המיטבית: מטרת האלגוריתם הראשון היא רק למצוא את טבלת הערכים המתאימה למדיניות שבחרנו, ולכל מדיניות אפשר למצוא בדרך הזו את טבלת הערכים שלה. זהו האלגוריתם של בלמן המכונה Policy Evaluation. שימו לב למילה: ״הערכה״ (evaluation) כאן פירושה לחשב ערך, ולא לשפוט כמה המדיניות טובה.
כדי להפעיל את משוואת בלמן צריך מדיניות כלשהי — המשוואה מחשבת ערכים עבור מדיניות נתונה. לכן נתחיל בבניית מדיניות התחלתית. נשתמש ב־לוח 4×4 שהוגדר בפרק הקודם. נשמור שתי טבלאות: V מכילה מספר לכל מצב, ו־π מכילה פעולה לכל מצב שאינו סופי. נאתחל את הערכים באפס. המדיניות הראשונית יכולה להיות פשוטה מאוד; בשלב הזה היא אינה חייבת להיות טובה.
בפרק הזה נתחיל ממדיניות ״למטה״: הסוכן הולך תמיד למטה, אלא אם הוא צמוד ליעד, ואז הולך לכיוונו; כלומר בתא שמשמאל ליעד נפנה ימינה. בשורה התחתונה ״למטה״ פירושו ניסיון לצאת מהלוח, והסוכן נשאר במקומו בלי תגמול. זו מדיניות התחלתית חלשה, שאותה נשפר. לצד המדיניות נחזיק את טבלת הערכים V(s): באתחול כל הערכים 0, ולשני תאי הסיום הערך יישאר 0 לאורך כל הדרך, כי מהם המשחק אינו ממשיך. התגמולים כמו בפרק הקודם: 0 בכל צעד רגיל, 1 בכניסה למשבצת הירוקה, −1 בכניסה למשבצת האדומה, ו־γ=0.9.
| ↓ | ↓ | ↓ | ↓ |
| ↓ | ↓ | סיום | ↓ |
| ↓ | ↓ | ↓ | ↓ |
| ↓ | ↓ | → | סיום |
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 |
יש לנו מדיניות, ועכשיו נמצא את טבלת הערכים V שלה. במהלך החישוב לא משנים את הפעולות שנבחרו. עוברים שוב ושוב על המצבים ומעדכנים את V לפי משוואת בלמן ולפי אותה מדיניות. בכל סריקה מודדים את השינוי הגדול ביותר בערכים. כשהשינוי קטן מן הדיוק שבחרנו, מפסיקים — הטבלה התייצבה ואינה משתנה עוד.
האלגוריתם של בלמן מציע לבצע חישוב חוזר ונשנה של המשוואה Vπ(s) = r + γVπ(s′) על כל תאי הטבלה, עד אשר לא יהיו יותר שינויים בטבלה (או שהשינויים יהיו קטנים מאוד). מה זה אומר בפועל? סורקים את הטבלה: עוברים על התאים שורה אחר שורה, מלמעלה למטה, ובכל שורה משמאל לימין. בכל תא שאינו תא סיום מבצעים חישוב אחד:
- מסתכלים בטבלת המדיניות ורואים איזו פעולה נבחרה בתא הזה.
- שואלים את המודל לאן הפעולה מובילה ומה התגמול r על המעבר.
- מסתכלים בטבלת הערכים וקוראים את הערך הנוכחי של התא שאליו הגענו, V(s′).
- מחשבים לפי נוסחת בלמן r + 0.9·V(s′) וכותבים את התוצאה בתא הנוכחי במקום הערך הישן.
הערך החדש נכתב מיד בטבלה, ולכן תא שנסרק מאוחר יותר באותה סריקה כבר רואה אותו. תאי הסיום מדלגים עליהם, וערכם נשאר 0. כשמסיימים את כל התאים, זו סריקה אחת; אז מתחילים סריקה חדשה מן התא הראשון.
סריקה ראשונה, יד ביד. נסמן כל תא לפי (שורה, עמודה), כשהספירה מתחילה ב־0 מלמעלה ומשמאל, בדיוק כמו בקוד: התא האדום הוא (1,2) והיעד הירוק הוא (3,3). מתחילים מטבלה שכולה אפסים ומן המדיניות ״למטה״ שבנינו.
- התא (0,0): המדיניות אומרת ״למטה״, והמודל מוביל ל־(1,0) עם תגמול 0. הערך של (1,0) בטבלה הוא 0, ולכן מחשבים 0 + 0.9·0 = 0. כותבים 0; שום דבר לא השתנה. גם התא (0,1) מסתיים כך.
- התא (0,2): ״למטה״ מוביל לתא האדום (1,2). התגמול על הכניסה אליו הוא −1, וערכו של תא סיום הוא 0. מחשבים −1 + 0.9·0 = −1, וכותבים −1 בתא (0,2). זה השינוי הראשון בטבלה.
- התא (0,3): ״למטה״ מוביל ל־(1,3). תגמול 0, והערך של (1,3) הוא בינתיים 0. התוצאה 0.
- השורה השנייה: (1,0) ו־(1,1) נותנים 0, את (1,2) מדלגים כי הוא תא סיום, ו־(1,3) יורד אל (2,3). התגמול 0, והערך של (2,3) הוא עדיין 0, כי טרם הגענו אליו בסריקה הזאת. התוצאה 0.
- השורה השלישית: שלושת התאים הראשונים נותנים 0. התא (2,3) יורד אל היעד הירוק: תגמול 1, וערכו של תא סיום 0. מחשבים 1 + 0.9·0 = 1 וכותבים 1 בתא (2,3).
- השורה התחתונה: ב־(3,0) וב־(3,1) ״למטה״ פירושו ניסיון לצאת מהלוח, הסוכן נשאר במקומו עם תגמול 0, ולכן 0 + 0.9·0 = 0. התא (3,2) פונה ימינה אל היעד: 1 + 0.9·0 = 1. את (3,3) מדלגים.
בסיום הסריקה הראשונה השתנו שלושה תאים בלבד, והם מסומנים באדום:
| 0 | 0 | −1 | 0 |
| 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 1 |
| 0 | 0 | 1 | 0 |
שימו לב שרק תאים שהפעולה שלהם נכנסת ישירות לתא סיום קיבלו ערך: כל השאר הובילו לתאים שערכם עדיין היה 0 ברגע החישוב.
סריקה שנייה, יד ביד. חוזרים על אותו חישוב מן התא הראשון, אבל עכשיו יש בטבלה שלושה מספרים שאינם אפס, והם משפיעים על התאים שמובילים אליהם.
- התא (0,0) והתא (0,1): ״למטה״ מוביל ל־(1,0) ול־(1,1), ששניהם עדיין 0. התוצאה 0 + 0.9·0 = 0, ללא שינוי.
- התא (0,2): ״למטה״ מוביל שוב לתא האדום: −1 + 0.9·0 = −1. אותו מספר שכבר כתוב בתא, ולכן אין שינוי.
- התא (0,3): ״למטה״ מוביל ל־(1,3). ברגע הזה הערך של (1,3) הוא עדיין 0, כי נגיע אליו רק בשורה הבאה של הסריקה. התוצאה 0. התא הזה יקבל ערך רק בסריקה הבאה.
- התא (1,3): ״למטה״ מוביל ל־(2,3), שערכו כבר 1 מן הסריקה הקודמת. מחשבים 0 + 0.9·1 = 0.9 וכותבים 0.9. זה השינוי הראשון בסריקה הזאת.
- התא (2,2): ״למטה״ מוביל ל־(3,2), שערכו 1. מחשבים 0 + 0.9·1 = 0.9 וכותבים 0.9.
- התא (2,3) והתא (3,2): שניהם נכנסים ליעד ונותנים שוב 1 + 0.9·0 = 1, ללא שינוי. כל שאר התאים מובילים לתאים שערכם 0 ונשארים 0.
בסיום הסריקה השנייה השתנו שני תאים, והם מסומנים באדום:
| 0 | 0 | −1 | 0 |
| 0 | 0 | 0 | 0.9 |
| 0 | 0 | 0.9 | 1 |
| 0 | 0 | 1 | 0 |
שימו לב ל־(0,3): הוא נסרק לפני (1,3), ולכן ראה שם עדיין 0. כך פועל עדכון במקום: בכל סריקה המידע מתקדם צעד אחד לאחור, מן היעד אל התאים שמובילים אליו.
הסריקות הבאות. בסריקה השלישית התא (0,3) יורד אל (1,3), שערכו עכשיו 0.9, ומקבל 0 + 0.9·0.9 = 0.81; זה השינוי היחיד. בסריקה הרביעית מחשבים שוב את כל התאים, וכל אחד מהם נותן בדיוק את המספר שכבר כתוב בו: השינוי הגדול ביותר הוא 0, קטן מן הדיוק שקבענו, ולכן עוצרים. כך זה תמיד: כדי לדעת שהטבלה התייצבה צריך לבצע סריקה אחת נוספת שלא משנה דבר.
| 0 | 0 | −1 | 0.81 |
| 0 | 0 | 0 | 0.9 |
| 0 | 0 | 0.9 | 1 |
| 0 | 0 | 1 | 0 |
| 0 | 0 | −1 | 0.81 |
| 0 | 0 | 0 | 0.9 |
| 0 | 0 | 0.9 | 1 |
| 0 | 0 | 1 | 0 |
הערכים מתקדמים מן היעד אחורה, סריקה אחר סריקה: קודם התאים הצמודים לתאי הסיום, אחר כך התאים שמובילים אליהם, וכן הלאה. תא שהמדיניות אינה מובילה ממנו לשום תגמול נשאר 0.
שימו לב לשתי העמודות השמאליות: כל התאים בהן נשארו 0, אף שהיעד נמצא באותו לוח. הסיבה היא המדיניות. מכל תא בעמודות האלה הסוכן הולך ״למטה״ עד השורה התחתונה, ושם ״למטה״ משאיר אותו במקום לנצח. הוא אינו מגיע לעולם לא ליעד ולא לתא האדום, ולכן סכום התגמולים שלו הוא 0. למשל, התא (3,1) נמצא שני צעדים בלבד מהיעד, אבל במדיניות הזאת הסוכן לא הולך לשם, ולכן ערכו 0. זו נקודה חשובה: V מודדת כמה תגמול צובר הסוכן כשהוא הולך לפי המדיניות הנתונה, ולא כמה קרוב היעד.
לסיכום, הנה האלגוריתם Policy Evaluation בפסאודו־קוד. מאתחלים את V בערכים אקראיים, פרט לתאי הסיום שמקבלים 0; קובעים דיוק קטן, accuracy=0.0001; ובכל סריקה שומרים את הערך הישן, מבקשים מן המדיניות פעולה, מבקשים מן הסביבה את המצב הבא והתגמול, מחשבים ערך חדש לפי משוואת בלמן ורושמים את השינוי הגדול ביותר. מסיימים את הסריקות כאשר תיקון הטבלה קטן מן הסף שנקבע:
# Iterative Policy Evaluation for Deterministic environment

# Initialization
for all s in S:
    V(s) = random(float) except V(terminal) = 0

def Policy_Evaluation(P, V):
    accuracy = 0.0001 (small number)
    acc = maxNumber
    while acc > accuracy:
        acc = 0
        for s in all states:
            if s is terminal: continue
            old_value = V(s)
            action = P(s)
            s', r = environment(s, action)
            new_value = r + gamma * V(s')
            V(s) = new_value
            acc = max(acc, abs(old_value - new_value))
שיפור המדיניות — Policy Improvement
עכשיו יש לנו טבלת ערכים שמתארת את המדיניות הנוכחית, והיא מגלה לנו היכן המדיניות חלשה: למשל, התא שמעל תא ההפסד יורד היישר אל −1, בעוד שכנו מימין שווה 0.81. השלב השני, שיפור המדיניות — Policy Improvement, מנצל את המידע הזה. כעת נשאל בכל מצב אם פעולה אחרת תיתן תוצאה טובה יותר. לכל פעולה חוקית מחשבים את התגמול המיידי ואת ערך ההמשך. בוחרים פעולה עם הציון הגדול ביותר ומשנים את המדיניות בהתאם. זו בחירה חמדנית — Greedy: בכל מצב לוקחים את הפעולה שנראית הכי טובה לפי הטבלה הנוכחית. בשלב הזה משתמשים בטבלת הערכים שחושבה עבור המדיניות הקודמת, ו־Policy Improvement מצריך מעבר אחד בלבד על הטבלה.
סריקה אחת, יד ביד. גם כאן סורקים את הטבלה שורה אחר שורה, אבל יש הבדל גדול מן השלב הקודם: הפעם עוברים על הטבלה פעם אחת בלבד, ולא חוזרים עליה עד התייצבות. טבלת הערכים אינה משתנה בסריקה הזאת; משתנים רק החצים בטבלת המדיניות. בכל תא שאינו תא סיום עושים את הדבר הבא:
- רושמים את ארבע הפעולות האפשריות בתא: למעלה, ימינה, שמאלה ולמטה. פעולה אל מחוץ ללוח משאירה את הסוכן במקומו, ולכן גם היא אפשרית.
- לכל אחת מארבע הפעולות בנפרד: שואלים את המודל לאן היא מובילה ומה התגמול, ומחשבים לפי נוסחת בלמן r + 0.9·V(s′), כשאת V(s′) קוראים מטבלת הערכים שחישבנו זה עתה.
- משווים את ארבעת המספרים ובוחרים את הפעולה שנתנה את המספר הגדול ביותר.
- כותבים את הפעולה הזאת בטבלת המדיניות. אם היא שונה מן הפעולה שהייתה שם, המדיניות השתנתה. כשכמה פעולות נותנות אותו מספר, ואחת מהן היא הפעולה הנוכחית, משאירים אותה.
נעשה זאת במלואו על התא (0,2), התא שמעל התא האדום, שערכו כרגע −1 והחץ שלו ״למטה״:
| פעולה | לאן מובילה | r | V(s′) | r + 0.9·V(s′) |
|---|---|---|---|---|
| למעלה | מחוץ ללוח, נשאר ב־(0,2) | 0 | −1 | −0.9 |
| ימינה | (0,3) | 0 | 0.81 | 0.73 |
| שמאלה | (0,1) | 0 | 0 | 0 |
| למטה | התא האדום (1,2) | −1 | 0 | −1 |
המספר הגדול ביותר הוא 0.73, של ״ימינה״, ולכן החץ בתא (0,2) מתחלף מ״למטה״ ל״ימינה״. הנה אותו חישוב, בקצרה, בשאר התאים:
- התא (0,0): ״ימינה״ מוביל ל־(0,1) ו״למטה״ ל־(1,0), ושניהם שווים 0; ״למעלה״ ו״שמאלה״ משאירים במקום, וגם זה 0. כל הפעולות שקולות, החץ ״למטה״ נשאר. כך גם בכל התאים של שתי העמודות השמאליות שכל שכניהם 0: (0,1), (1,0), (1,1), (2,0) ו־(3,0).
- התא (0,2): ראינו למעלה: ״ימינה״ נותנת 0.73, יותר מכל פעולה אחרת, והחץ מתחלף ל״ימינה״. זה השינוי הראשון.
- התא (0,3): ״למטה״ מוביל ל־(1,3), שערכו 0.9: 0.9·0.9 = 0.81. ״שמאלה״ מוביל ל־(0,2), שערכו −1: −0.9. ״למטה״ מנצח, החץ נשאר.
- התא (1,3): ״למעלה״ נותן 0.9·0.81 = 0.73, ״למטה״ מוביל ל־(2,3) שערכו 1 ונותן 0.9, ו״שמאלה״ מוביל לתא האדום ונותן −1. ״למטה״ נשאר.
- התא (2,1): ״ימינה״ מוביל ל־(2,2), שערכו 0.9: 0.81. כל שאר הפעולות מובילות לתאים שערכם 0. החץ מתחלף ל״ימינה״. זה השינוי השני.
- התא (2,2): ״ימינה״ מוביל ל־(2,3) ו״למטה״ ל־(3,2), ושניהם שווים 1, כלומר 0.9 לשתי הפעולות; ״למעלה״ מוביל לתא האדום (−1) ו״שמאלה״ ל־0. ״ימינה״ ו״למטה״ שקולות, ולכן ״למטה״ הנוכחי נשאר.
- התא (2,3): ״למטה״ נכנס ליעד ונותן 1, יותר מכל פעולה אחרת. נשאר.
- התא (3,1): ״ימינה״ מוביל ל־(3,2), שערכו 1: 0.9. ״למעלה״ מוביל ל־(2,1) שערכו 0, ו״שמאלה״ ו״למטה״ נותנים 0. החץ מתחלף ל״ימינה״. זה השינוי השלישי.
- התא (3,2): ״ימינה״ נכנס ליעד ונותן 1; ״למעלה״ נותן 0.9·0.9 = 0.81. ״ימינה״ נשאר.
בסיום הסריקה היחידה הזאת השתנו שלושה חצים, והם מסומנים באדום; יתר החצים נשארים כפי שהיו. טבלת הערכים משמאל היא הטבלה שלפיה חישבנו, והיא לא השתנתה:
| 0 | 0 | −1 | 0.81 |
| 0 | 0 | 0 | 0.9 |
| 0 | 0 | 0.9 | 1 |
| 0 | 0 | 1 | 0 |
| ↓ | ↓ | → | ↓ |
| ↓ | ↓ | סיום | ↓ |
| ↓ | → | ↓ | ↓ |
| ↓ | → | → | סיום |
שימו לב שאחרי הסריקה טבלת המדיניות כבר אינה תואמת לטבלת הערכים: הערכים חושבו למדיניות הישנה. זו בדיוק הסיבה שבסעיף הבא נחזור ונחשב את הערכים מחדש. לסיכום, הנה האלגוריתם Policy Improvement בפסאודו־קוד. לכל מצב שאינו מצב סיום (על מצבי הסיום מדלגים, כמו בהערכת המדיניות: אין בהם פעולה) אוספים את הפעולות החוקיות, מתחילים מ־v_max=−inf, בודקים כל פעולה מול הסביבה ושומרים את הפעולה הטובה ביותר. אם היא שונה מן הפעולה הנוכחית במדיניות, מעדכנים את המדיניות ומסמנים שהיא אינה יציבה. מחזירים True אם לא היו שינויים, כלומר המדיניות יציבה:
# policy improvement for Deterministic environment
# return true if policy stable

def Policy_improvement(P, V):
    stable = true
    for all s in States:
        if s is terminal: continue
        actions = legal_actions(s)
        v_max = -inf
        for all action in actions:
            s', r = environment(s, action)
            if v_max < r + gamma * V(s'):
                v_max = r + gamma * V(s')
                best_action = action
        if P(s) != best_action:
            P(s) = best_action
            stable = false
    return stable
ואפשר גם בנוסחה. את אותו אלגוריתם בדיוק נהוג לכתוב בספרים בשורה מתמטית אחת. אין בה שום דבר חדש, רק סימון מקוצר של מה שעשינו זה עתה:
קוראים אותה כך: המדיניות החדשה, πnew, בוחרת במצב s את הפעולה a שעבורה הביטוי שבסוגריים הוא הגדול ביותר. R(s,a,s′) הוא התגמול על המעבר מ־s אל s′ בפעולה a, ו־γVπ(s′) הוא ערך ההמשך לפי טבלת הערכים של המדיניות הקודמת. הסימון argmax (״הארגומנט של המקסימום״) פירושו: לא הערך המקסימלי עצמו, אלא הפעולה שמביאה אליו. זה בדיוק מה שעושה הלולאה הפנימית בפסאודו־קוד: v_max הוא המקסימום, ו־best_action הוא ה־argmax.
מציאת מדיניות מיטבית — Policy Iteration
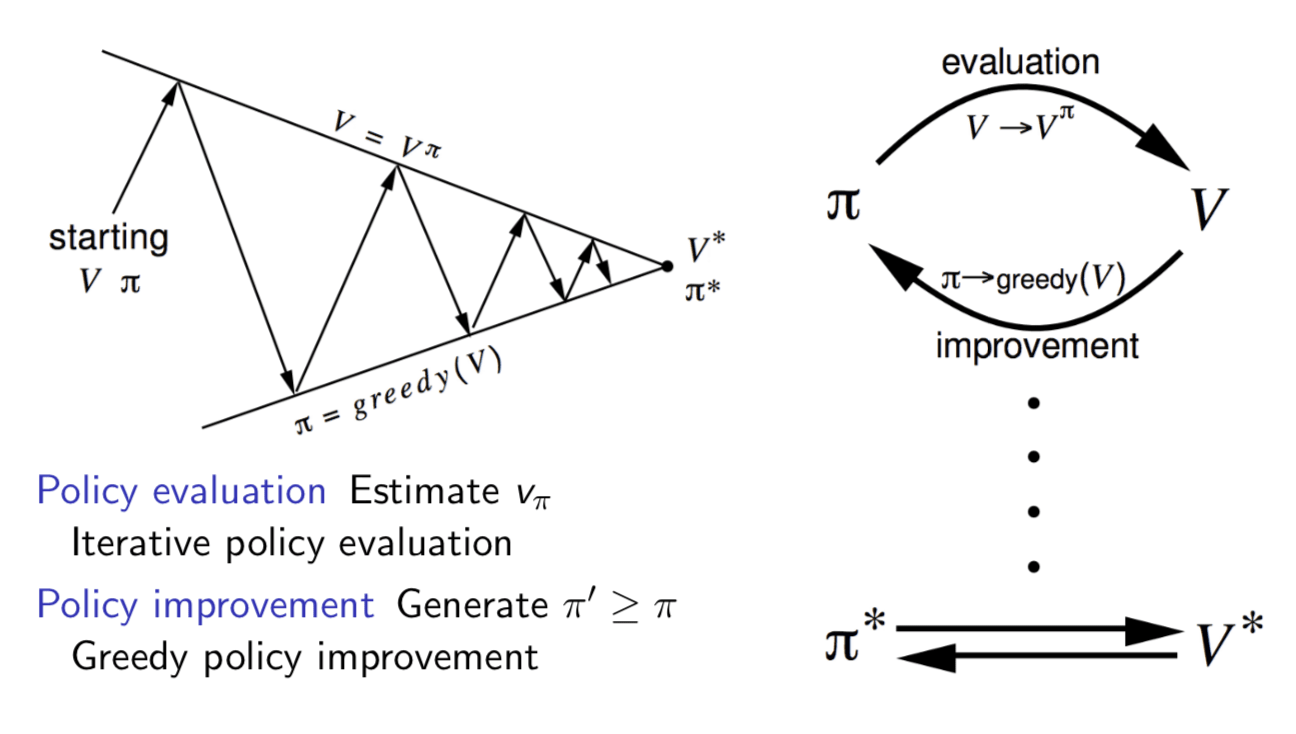
עכשיו יש בידינו את שני הכלים, ומהם בלמן בנה את האלגוריתם Policy Iteration למציאת המדיניות המיטבית. הרעיון פשוט: מבצעים לסירוגין הערכת מדיניות (Policy Evaluation), שמחשבת את טבלת הערכים של המדיניות הנוכחית, ושיפור מדיניות (Policy Improvement), שמעדכן את המדיניות לפי טבלת הערכים החדשה. חוזרים על שני השלבים שוב ושוב, עד שהשיפור אינו משנה אף חץ, כלומר המדיניות יציבה.
האלגוריתם לסביבה דטרמיניסטית כתוב בפסאודו־קוד בשני שלבים: אתחול, ואז לולאה:
# Policy iteration for Deterministic environment
def Policy_iteration():
    # 1. Initialization
    for all s in S:
        V(s) = random(float) except V(terminal) = 0
        P(s) = random(actions)
    policy_stable = False
    # 2. loop
    while not policy_stable:
        Policy_Evaluation(P, V)
        policy_stable = Policy_Improvement(P, V)
בספרם של Sutton ו־Barto האלגוריתם כתוב בניסוח כללי יותר, שבו ההערכה והשיפור מסכמים על כל המצבים הבאים האפשריים לפי ההסתברויות שלהם; זו הגרסה שמתאימה למשוואת בלמן המלאה שהוזכרה כרשות, ולא נשתמש בה.
נראה עכשיו את האלגוריתם פועל על הלוח שלנו, סבב אחר סבב, מן הנקודה שבה עצרנו. זו נקודת המוצא: טבלת הערכים שהתקבלה בהערכה הראשונה, והמדיניות שהתקבלה בשיפור הראשון:
| 0 | 0 | −1 | 0.81 |
| 0 | 0 | 0 | 0.9 |
| 0 | 0 | 0.9 | 1 |
| 0 | 0 | 1 | 0 |
| ↓ | ↓ | → | ↓ |
| ↓ | ↓ | סיום | ↓ |
| ↓ | → | ↓ | ↓ |
| ↓ | → | → | סיום |
סבב 2, שלב א — הערכת המדיניות החדשה. שיפור אחד אינו מספיק. אחרי שינוי החצים, טבלת הערכים עדיין מתארת את המדיניות הישנה: הערכים חושבו לפי הפעולות הקודמות. לכן מפעילים שוב הערכת מדיניות, הפעם עבור המדיניות החדשה.
שימו לב: לא מאפסים את הטבלה. ממשיכים מן הטבלה הקודמת, כי רוב הערכים בה כבר נכונים גם למדיניות החדשה, ורק התאים שהחץ שלהם השתנה, ואלה שמובילים אליהם, צריכים תיקון. כך נדרשות פחות סריקות. סורקים כרגיל, שורה אחר שורה, ובכל תא מחשבים לפי נוסחת בלמן r + 0.9·V(s′) עם הפעולה החדשה:
- סריקה 1: התא (0,2) פונה עכשיו ימינה אל (0,3), שערכו 0.81: 0 + 0.9·0.81 = 0.73 במקום −1. התא (2,1) פונה ימינה אל (2,2), שערכו 0.9: 0.81 במקום 0. התא (3,1) פונה ימינה אל (3,2), שערכו 1: 0.9 במקום 0. כל שאר התאים נותנים בדיוק את המספר שכבר כתוב בהם.
- סריקה 2: התא (1,1) יורד אל (2,1), שערכו עכשיו 0.81: 0.9·0.81 = 0.73. זה השינוי היחיד.
- סריקה 3: התא (0,1) יורד אל (1,1), שערכו עכשיו 0.73: 0.9·0.73 = 0.66. זה השינוי היחיד.
- סריקה 4: אין שינוי, עוצרים.
| 0 | 0 | 0.73 | 0.81 |
| 0 | 0 | 0 | 0.9 |
| 0 | 0.81 | 0.9 | 1 |
| 0 | 0.9 | 1 | 0 |
| 0 | 0 | 0.73 | 0.81 |
| 0 | 0.73 | 0 | 0.9 |
| 0 | 0.81 | 0.9 | 1 |
| 0 | 0.9 | 1 | 0 |
| 0 | 0.66 | 0.73 | 0.81 |
| 0 | 0.73 | 0 | 0.9 |
| 0 | 0.81 | 0.9 | 1 |
| 0 | 0.9 | 1 | 0 |
| 0 | 0.66 | 0.73 | 0.81 |
| 0 | 0.73 | 0 | 0.9 |
| 0 | 0.81 | 0.9 | 1 |
| 0 | 0.9 | 1 | 0 |
הערכים מעוגלים לשתי ספרות: 0.729 נכתב 0.73, ו־0.656 נכתב 0.66. שימו לב שהתא שמעל התא האדום, שקודם ירד היישר אל −1, שווה עכשיו 0.73: השיפור עזר. אבל העמודה הראשונה עדיין כולה 0: המדיניות בה עדיין ״למטה״, והסוכן נתקע בשורה התחתונה בלי להגיע ליעד.
סבב 2, שלב ב — שיפור המדיניות. סריקה אחת על הטבלה החדשה. בכל אחד מארבעת תאי העמודה הראשונה ״ימינה״ מוביל לתא בעל ערך חיובי, ואילו כל שאר הפעולות מובילות לתאים שערכם 0 או משאירות במקום: ב־(0,0) ״ימינה״ נותנת 0.9·0.66 = 0.59, ב־(1,0) 0.9·0.73 = 0.66, ב־(2,0) 0.9·0.81 = 0.73, וב־(3,0) 0.9·0.9 = 0.81. לכן כל ארבעת החצים מתחלפים לימינה (מסומנים באדום). ביתר התאים הפעולה הנוכחית נשארת הטובה ביותר או שקולה לטובה ביותר; למשל ב־(0,1) ״ימינה״ ו״למטה״ נותנות שתיהן 0.9·0.73 = 0.66, ולכן ״למטה״ נשאר:
| 0 | 0.66 | 0.73 | 0.81 |
| 0 | 0.73 | 0 | 0.9 |
| 0 | 0.81 | 0.9 | 1 |
| 0 | 0.9 | 1 | 0 |
| → | ↓ | → | ↓ |
| → | ↓ | סיום | ↓ |
| → | → | ↓ | ↓ |
| → | → | → | סיום |
סבב 3, שלב א — הערכה. שוב ממשיכים מן הטבלה הקודמת, עם המדיניות החדשה. הפעם רק ארבעת תאי העמודה הראשונה שינו חץ, ולכן רק הם משתנים:
- סריקה 1: (0,0) פונה ימינה אל (0,1): 0.9·0.66 = 0.59. (1,0) פונה ימינה אל (1,1): 0.9·0.73 = 0.66. (2,0) פונה ימינה אל (2,1): 0.9·0.81 = 0.73. (3,0) פונה ימינה אל (3,1): 0.9·0.9 = 0.81. כל שאר התאים ללא שינוי.
- סריקה 2: אין שינוי, עוצרים.
| 0.59 | 0.66 | 0.73 | 0.81 |
| 0.66 | 0.73 | 0 | 0.9 |
| 0.73 | 0.81 | 0.9 | 1 |
| 0.81 | 0.9 | 1 | 0 |
| 0.59 | 0.66 | 0.73 | 0.81 |
| 0.66 | 0.73 | 0 | 0.9 |
| 0.73 | 0.81 | 0.9 | 1 |
| 0.81 | 0.9 | 1 | 0 |
סבב 3, שלב ב — שיפור. סורקים שוב את כל התאים ובודקים את ארבע הפעולות בכל אחד. הפעם אף חץ אינו משתנה: בכל תא הפעולה הנוכחית כבר מובילה לשכן בעל הערך הגבוה ביותר (או שקולה לו; למשל ב־(0,0) גם ״ימינה״ וגם ״למטה״ נותנות 0.9·0.66 = 0.59, ו״ימינה״ הנוכחית נשארת). השיפור מחזיר ״יציב״, וכאן האלגוריתם נעצר. אחרי שלושה סבבים בלבד מצאנו את המדיניות המיטבית ואת טבלת הערכים שלה:
| 0.59 | 0.66 | 0.73 | 0.81 |
| 0.66 | 0.73 | 0 | 0.9 |
| 0.73 | 0.81 | 0.9 | 1 |
| 0.81 | 0.9 | 1 | 0 |
| → | ↓ | → | ↓ |
| → | ↓ | סיום | ↓ |
| → | → | ↓ | ↓ |
| → | → | → | סיום |
זהו התפקיד של ההחלפה בין השלבים: שינוי המדיניות מאפשר לערכים חדשים להתפשט, והערכים האלה מאפשרים למצוא שינוי נוסף במדיניות. הטבלה הסופית זהה לטבלה שראינו בפרק הקודם עבור המדיניות שמובילה ליעד בדרך קצרה — הגענו אליה מבלי שמישהו כתב אותה בידיים, רק מתוך חוקי המשחק. במדיניות המיטבית יש גם תאים שבהם שתי פעולות שקולות: מהפינה השמאלית העליונה גם ״ימינה״ וגם ״למטה״ מובילות לתא שערכו 0.66, ולכן שתיהן נותנות 0.59; הפונקציה שלנו שומרת במקרה כזה את הפעולה הקודמת.
תרגיל — עולם הגריד
סיימנו את החלק התיאורטי, ועכשיו מממשים בקוד. במאגר GridWorld_2 בגיטהב נתון משחק Grid World שלם לפי מודל סוכן–סביבה, וחסר בו דבר אחד בלבד: האלגוריתמים שלמדנו בפרק הזה. התרגיל הוא להשלים אותם.
הממשק. הסביבה Environement מחזיקה את הלוח כטבלת numpy בשם board: 0 בתא רגיל, −1 בתא האדום ו־1 בתא הירוק. המצב (State) הוא מיקום הרובוט, זוג (row, col). הקריאה env(state, action) (או env.move) מחזירה שני ערכים, מצב חדש ותגמול; פעולה לכיוון קצה הלוח משאירה את הסוכן במקומו. env.get_actions(state) מחזירה את הפעולות החוקיות, ו־env.end_of_game(state) בודקת אם הגענו לתא סיום. הפעולות הן Enum בשם Action עם הערכים UP=0, RIGHT=1, LEFT=2, DOWN=3. הקובץ Game.py מריץ את לולאת המשחק: בכל צעד הוא שואל את הסוכן לפעולה, מזיז את הרובוט, מצייר את הלוח, ובהגיעו לתא סיום מחזיר אותו להתחלה. בקובץ Agent.py יש שני סוכנים: Random_Agent, שבוחר פעולה אקראית ומוכן לעבודה, ו־AI_Agent, שאותו עלינו להשלים.
השלד להשלמה. המחלקה AI_Agent כבר מכילה את שתי הטבלאות ואת החיבור למשחק: Policy היא טבלת numpy בגודל הלוח שבכל תא שלה מספר הפעולה (באתחול 3, כלומר ״למטה״ בכל תא), ו־Value היא טבלת הערכים, שבאתחול כולה אפסים. get_action מתרגמת את המספר שבטבלת המדיניות לפעולה, וכך הסוכן משחק לפי המדיניות. שלוש השיטות של האלגוריתם ריקות:
class AI_Agent:
    def __init__(self, env) -> None:
        self.env : Env = env
        self.Reward = 0
        self.Policy = np.full((ROWS, COLS), 3)  # Random policy always down
        self.Value = np.zeros((ROWS, COLS))     # Random Value all zero
        self.gamma = 0.9

    def get_action(self, state):
        return Action(self.Policy[state])

    def add_reward(self, reward):
        self.Reward += reward

    def policy_eval (self):
        accuracy = 0.0001


    def Policy_improv (self):
        pass

    def Policy_Iteration (self):
        pass


    def Value_Iteration():
        pass

    def __call__(self, state):
        return self.get_action(state)
הקובץ Game.py. זה הקובץ שמריצים. הוא יוצר סביבה, גרפיקה וסוכן, ואז מפעיל את לולאת המשחק:
import pygame
from Graphics import *
from Environement import Environement
from Agent import *

pygame.init()
clock = pygame.time.Clock()
env = Environement((0,0))
graphics = Graphics(env)
# agent = Random_Agent(env)
agent = AI_Agent(env)
print(agent.Policy_Iteration())
print ('Value*: \n', agent.Value)
print ('Policy*: \n', agent.Policy)

def main ():
    run = True
    while (run):
        events = pygame.event.get()
        for event in events:
            if event.type == pygame.QUIT:
               run = False

        action = agent(env.state)
        pygame.time.wait(100)
        env.state, reward = env.move(env.state, action)
        agent.add_reward(reward)
        graphics(env.state)
        print (f'{agent.Reward} ', end='\r')
        if env.end_of_game(env.state):
            pygame.time.wait(500)
            env.reset()
            graphics(env.state)
        clock.tick(FPS)

    pygame.time.wait(200)

if __name__ == '__main__':
    main()
שלוש השורות שאחרי יצירת הסוכן הן החלק המעניין: agent.Policy_Iteration() מחשב את המדיניות המיטבית עוד לפני שהמשחק מתחיל, ושתי ההדפסות מציגות בטרמינל את טבלת הערכים ואת טבלת המדיניות שהתקבלו. אחר כך main מריצה את המשחק: בכל סיבוב היא שואלת את הסוכן לפעולה (agent(env.state) קורא ל־get_action), מזיזה את הרובוט, צוברת את התגמול, מציירת את הלוח ומדפיסה את סך התגמול באותה שורה בטרמינל. כשהרובוט מגיע לתא סיום, המשחק ממתין חצי שנייה, מחזיר את הרובוט להתחלה וממשיך.
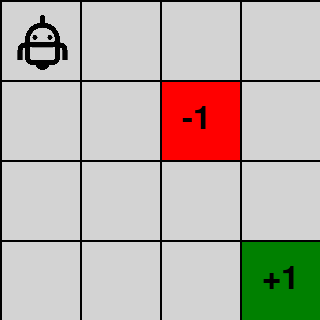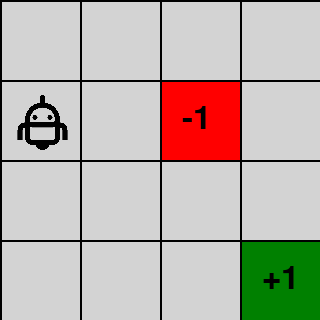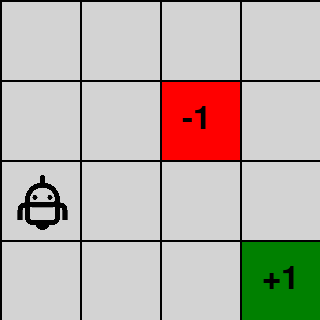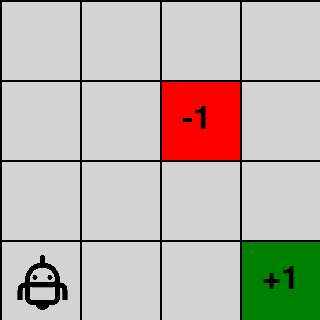
הרצה לפני ההשלמה. כדאי להריץ את המשחק עוד לפני שכותבים שורת קוד: הפכו את שלוש השורות של Policy_Iteration וההדפסות להערות (או מחקו אותן לרגע) והריצו. הסוכן פועל לפי המדיניות ההתחלתית, ״למטה״ בכל תא: הרובוט יורד עד השורה התחתונה, ושם ״למטה״ משאיר אותו במקום לנצח. הוא לא מגיע לעולם ליעד, ובטרמינל סך התגמול נשאר 0:
המשימה. עכשיו תורכם. עצרו כאן ונסו לפתור לבד לפי הפסאודו־קוד שבפרק, לפני שתמשיכו לפתרון:
- ממשו את
policy_evalלפי הפסאודו־קוד של Policy Evaluation: סריקות חוזרות על הטבלה לפי נוסחת בלמן, עד שהתיקון קטן מ־accuracy. - ממשו את
Policy_improvלפי הפסאודו־קוד של Policy Improvement: סריקה אחת, בכל תא בודקים את ארבע הפעולות ובוחרים את הטובה ביותר. החזירוTrueאם אף חץ לא השתנה. - ממשו את
Policy_Iteration, שמפעיל את שתי השיטות לסירוגין עד שהמדיניות יציבה. - הריצו את
Game.pyבלוח 4×4 וצפו ברובוט מגיע ליעד. אתValue_Iterationנשאיר לפרק הבא. - אחר כך נסו לוח 5×5 עם קירות, ואפילו לוח 10×10 עם מבוך שתבנו בעצמכם: משנים את
ROWS, COLSב־Graphics.pyומסמנים את תאי הקיר והיעד ב־boardשב־Environement.py. קוד הסוכן אינו משתנה.
פתרון — Policy Evaluation
הפתרון המלא נמצא במאגר GridWorld בגיטהב (הקישורים בראש הפרק). נבנה אותו בשלושה שלבים, ואחרי כל שלב נריץ ונבדוק בטרמינל שהתוצאה נכונה. לשם כך Game.py כולל שורות הדפסה מוכנות בהערה; בכל שלב מפעילים את השורות המתאימות ומשאירים את השאר בהערה.
השיטה הראשונה, בדיוק לפי הפסאודו־קוד:
    def policy_eval (self):
        accuracy = 0.0001
        acc = 1
        while acc > accuracy:
            acc = 0
            for row in range(ROWS):
                for col in range(COLS):
                    state = row,col
                    if self.env.board[state] != 0:
                        continue
                    old_value = self.Value[state]
                    action = Action(self.Policy[state])
                    new_state, reward = self.env(state, action)
                    new_value = reward + self.gamma * self.Value[new_state]
                    self.Value[state] = new_value
                    acc = max(acc, abs(old_value - new_value))
שתי הלולאות עוברות על כל תאי הלוח. תא שערכו ב־board שונה מאפס הוא תא סיום, ומדלגים עליו כדי שערכו יישאר 0. השורה המרכזית היא new_value = reward + self.gamma * self.Value[new_state] — זו משוואת בלמן בדיוק כפי שכתבנו אותה. acc שומר את השינוי הגדול ביותר בסריקה, וכשהוא קטן מ־accuracy הטבלה התייצבה והלולאה נעצרת. העדכון נעשה בטבלה עצמה, ולכן תא שנבדק בהמשך הסריקה כבר משתמש בערך שהתעדכן באותה סריקה.
בדיקה. ב־Game.py הפעילו את השורות agent.policy_eval() ו־print ('Value: \n', agent.Value), והריצו. הרצה אחת של השיטה על המדיניות ההתחלתית, ״למטה״ בכל תא, צריכה להדפיס:
פלט
Value:
 [[ 0.    0.   -1.    0.81]
 [ 0.    0.    0.    0.9 ]
 [ 0.    0.    0.    1.  ]
 [ 0.    0.    0.    0.  ]]
זו טבלת הערכים של מדיניות ״למטה״: −1 בתא שמעל התא האדום, ובעמודה הימנית 0.81, 0.9 ו־1. שימו לב להבדל אחד מן ההדגמה שבפרק: התא שמשמאל ליעד שווה כאן 0 ולא 1, כי המדיניות ההתחלתית של הקוד היא ״למטה״ גם בו (בהדגמה נתנו לו חץ ימינה). אם קיבלתם טבלה אחרת, בדקו את הדילוג על תאי הסיום ואת שורת נוסחת בלמן.
פתרון — Policy Improvement
השיטה השנייה:
    def Policy_improv (self):
        stable = True
        for row in range(ROWS):
            for col in range(COLS):
                state = row,col
                if self.env.board[state] != 0:
                    continue
                v_max = -1000
                best_action = None
                for action in Action:
                    new_state, reward = self.env.move(state, action)
                    if v_max < reward + self.gamma * self.Value[new_state]:
                        v_max = reward + self.gamma * self.Value[new_state]
                        best_action = action
                if self.Policy[state] != best_action.value:
                    self.Policy[state] = best_action.value
                    stable = False
        return stable
בכל תא בודקים את ארבע הפעולות (פעולה אל מחוץ ללוח פשוט משאירה את הסוכן במקומו, ולכן אין צורך לסנן אותה), ושומרים את הפעולה שנותנת את הערך הגדול ביותר של תגמול ועוד γ כפול ערך המצב הבא. בטבלת המדיניות נשמר מספר הפעולה, best_action.value. אם באחד התאים הפעולה השתנתה, stable נעשה False.
בדיקה. הוסיפו אחרי ההערכה את השורות print(agent.Policy_improv()) ו־print ('Policy: \n', agent.Policy). ההדפסה:
פלט
False
Policy:
 [[0 0 1 3]
 [0 0 3 3]
 [0 0 1 3]
 [0 0 1 3]]
False פירושו שהמדיניות השתנתה, כלומר עדיין אינה יציבה. בטבלה 1 הוא ימינה, 3 למטה ו־0 למעלה. שלושה תאים בעמודה השלישית קיבלו ימינה: מעל התא האדום, ליד היעד ובאמצע. בשתי העמודות השמאליות מופיע 0, ״למעלה״: שם כל ארבע הפעולות נותנות 0, והקוד בוחר את הראשונה לפי סדר ה־Enum, בעוד שבהדגמה השארנו את ״למטה״. שתי הבחירות שקולות, וזה לא ישפיע על התוצאה הסופית.
פתרון — Policy Iteration
ולבסוף, השיטה שמחברת את שתי הקודמות:
    def Policy_Iteration (self):
        policy_stable = False

        while not policy_stable:
            self.policy_eval()
            policy_stable = self.Policy_improv()
        return policy_stable
הלולאה ממשיכה כל עוד השיפור שינה משהו, ונעצרת כשהמדיניות יציבה.
בדיקה. החליפו את שורות הבדיקה של השלבים הקודמים בשלוש השורות של Policy_Iteration וההדפסות, כמו בקובץ Game.py שהוצג למעלה, והריצו. עוד לפני שחלון המשחק נפתח, בטרמינל מודפס:
פלט
True
Value*:
 [[0.59049 0.6561  0.729   0.81   ]
 [0.6561  0.729   0.      0.9    ]
 [0.729   0.81    0.9     1.     ]
 [0.81    0.9     1.      0.     ]]
Policy*:
 [[1 1 1 3]
 [1 3 3 3]
 [1 1 1 3]
 [1 1 1 3]]
טבלת הערכים זהה לטבלה הסופית שקיבלנו בהדגמה (0.59049 הוא 0.95 לפני עיגול). בטבלת המדיניות 1 פירושו ימינה ו־3 למטה, וזו בדיוק המדיניות המיטבית שראינו בחצים. שני הבדלים קטנים בין הקוד להדגמה: הקוד מתחיל ממדיניות ״למטה״ בכל התאים, בלי החץ ימינה ליד היעד, וכשכמה פעולות שקולות הוא בוחר את הראשונה לפי סדר ה־Enum. לכן טבלאות הביניים בהרצה עשויות להיות שונות מעט מאלה שבהדגמה, אבל התוצאה הסופית זהה.
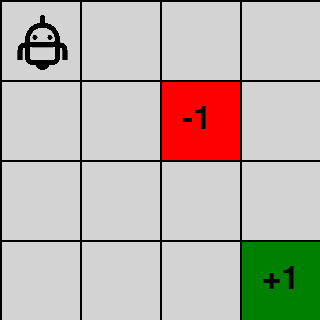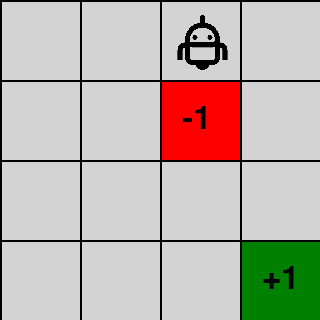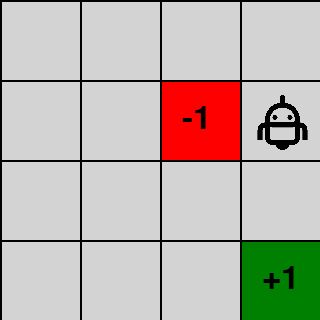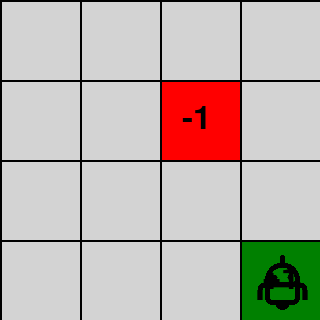
True הוא הערך שמחזירה Policy_Iteration (המדיניות יציבה). אחר כך נפתח חלון המשחק, והרובוט הולך לפי המדיניות שחושבה מהפינה השמאלית העליונה עד היעד הירוק. בטרמינל סך התגמול עולה ל־1 ברגע הכניסה ליעד; המשחק מתחיל מחדש, והמונה ממשיך לעלות בכל סיבוב: 2, 3, וכן הלאה:
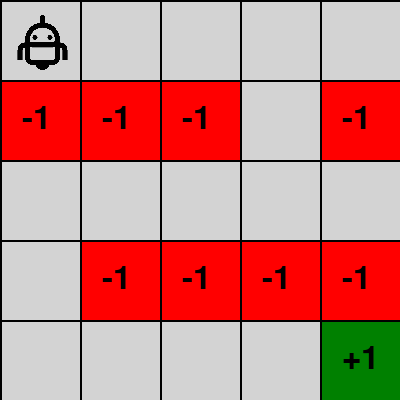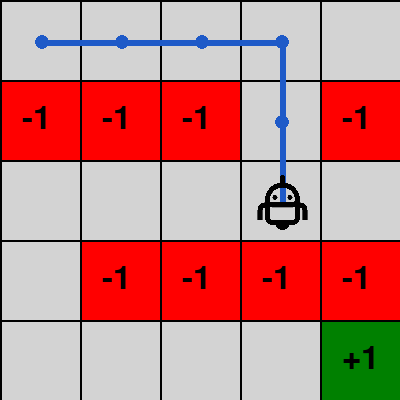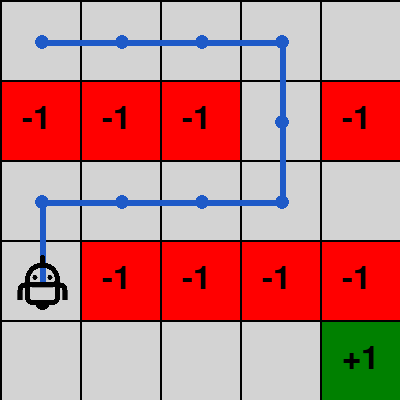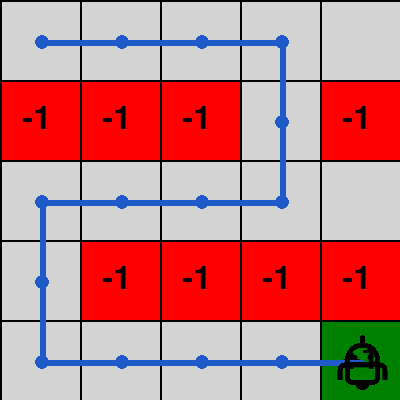
ובשביל הכיף: מבוך 5×5. אותו קוד סוכן בדיוק, בלי לשנות בו שורה, פותר גם מבוך גדול יותר. במאגר GridWorld הלוח כבר מוגדר כך: ב־Graphics.py נקבע ROWS, COLS = 5, 5, וב־Environement.py מסומנים שמונה תאי קיר והיעד בטבלת board:
        self.board = np.zeros((ROWS, COLS))
        self.board[1,0] = -1
        self.board[1,1] = -1
        self.board[1,2] = -1
        self.board[1,4] = -1
        self.board[3,1] = -1
        self.board[3,2] = -1
        self.board[3,3] = -1
        self.board[3,4] = -1
        self.board[4,4] = 1
הסוכן קורא את גודל הלוח ואת תאי הסיום מן הסביבה, ולכן Policy_Iteration מוצא את המדיניות המיטבית גם כאן, והרובוט מגיע ליעד ב־14 צעדים, המסלול הקצר ביותר האפשרי: ימינה לאורך השורה העליונה, למטה דרך הפתח, שמאלה לאורך השורה האמצעית, למטה בעמודה השמאלית וימינה עד היעד: