ג.14 מגבלות הקו הישר ורגרסיה באמצעות רשת
ברגרסיה הלינארית חיפשנו קו ישר שמתאר את הקשר בין הקלט לתוצאה, כדי שנוכל להעריך את התוצאה גם עבור קלטים שלא ראינו. אבל קו ישר מתאים רק כשהקשר עצמו ישר. חשבו על טמפרטורה לאורך השנה: היא עולה בקיץ ויורדת בחורף, ועליה יכולה להתווסף מגמה איטית של התחממות. קו ישר יכול ללכוד את המגמה הכללית, אך לא את העליות והירידות שחוזרות ונשנות. גם אם נאמן אותו זמן רב ככל שנרצה, הוא יישאר קו ישר.
בפרק הקודם ראינו שרשת נוירונים מחברת יחידות רבות בשכבות, ושפונקציות האקטיבציה הלא לינאריות מאפשרות לה לתאר קשרים מעוקלים. בפרק זה נראה זאת במו עינינו. ניצור נתונים בעלי קשר גלי ורעש, ונבחן את מגבלות הרגרסיה הלינארית: תחילה נתאים להם קו ישר, ואחר כך נשתמש ברשת עם שכבות חבויות — אותם נתונים, אותה פונקציית הפסד ואותה לולאת אימון, רק המודל משתנה — ונשווה את התוצאות.
בדרך נכיר גם דרך מסודרת להזין נתונים לאימון באצוות: מחלקת Dataset שאורזת קלט ותשובה יחד, ו־DataLoader שמחלק אותם לאצוות, כפי שעשינו עם MNIST.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: מצגת רשת נוירונים ANN (עותק מקומי) · מחברת מגבלות הרגרסיה (עותק מקומי)
ייבוא הספריות
נכין את הכלים ליצירת הנתונים, להצגתם ולאימון שני סוגי המודלים שנשווה.
import torch
import numpy as np
import matplotlib.pyplot as plt
import torch.nn as nn
from sklearn.model_selection import train_test_split
from torch.utils.data import DataLoader, Dataset
יצירת הנתונים
הפעם לא נטען מאגר קיים אלא ניצור נתונים בעצמנו, כדי שנדע בדיוק מהו הקשר שהמודל אמור לגלות. ניצור 10,000 ערכי x בין 1 ל־20, מסודרים במרווחים שווים באמצעות linspace. ערכי y יכללו מגמה עולה (0.02*x), גל סינוס שיוצר את העליות והירידות, איבר לוגריתמי שמעקם את המגמה, ורעש אקראי (randn) שמדמה מדידות לא מדויקות — כמו בנתונים אמיתיים. הצורה (10000, 1) היא עמודה אחת של 10,000 דוגמאות, כפי שמודל ב־PyTorch מצפה לקבל.
N_data = 10000

data_x = np.linspace(1.0, 20.0, N_data)[:, np.newaxis]
data_y = 0.02*data_x + 0.3*np.sin(data_x) + 1e-1  * np.log( data_x ) **2 + 0.2*np.random.randn(N_data,1)
# data_x = data_x / 10
data_x.shape, data_y.shape
פלט
((10000, 1), (10000, 1))
נציג את הנתונים:
plt.scatter( data_x, data_y, s=0.5, color='black')
plt.xlabel('year')
plt.ylabel('temperature')
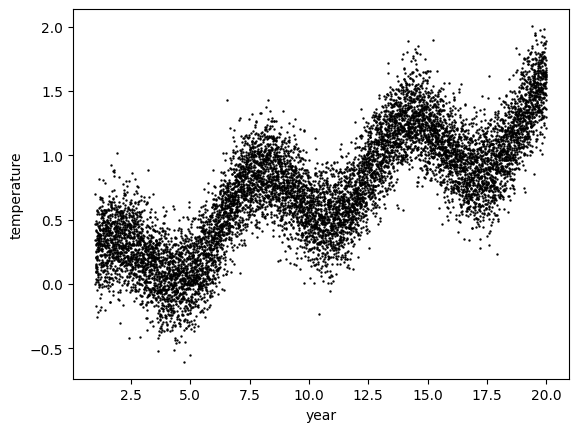
אלה נתונים מדומים; שמות הצירים מתארים המחשה של טמפרטורה לאורך זמן. כבר במבט ראשון ברור שאף קו ישר לא יעבור דרך הגלים האלה.
אימון, ולידציה ובדיקה
לפני שנתחיל באימון, נזכיר כיצד נהוג לחלק נתונים. נתוני האימון משמשים לעדכון המודל. נתוני ולידציה — Validation הם קבוצה נוספת שהמודל אינו לומד ממנה, ומשמשים לבחינת אימון יתר — Overfitting במהלך האימון: מצב שבו המודל משנן את דוגמאות האימון ומצליח בהן, אך נכשל בדוגמאות חדשות. נתוני בדיקה נשמרים להערכת הביצועים לאחריו. בדוגמה שלפנינו המטרה היא רק להשוות בין קו ישר לרשת על אותם נתונים, ולכן לא מתבצעת חלוקה בפועל, וכל הנתונים משמשים לאימון.
Dataset ו־DataLoader
בפרק הקודם קיבלנו את MNIST מוכן כ־Dataset של Torchvision, ו־DataLoader חילק אותו לאצוות. כאן הנתונים הם שלנו, ולכן נבנה Dataset בעצמנו. כדי להזין לאימון אצוות של דוגמאות, נארגן כל קלט יחד עם התשובה שלו. נגדיר מחלקה היורשת מ־Dataset והשומרת את הקלט ואת התשובות כטנסורים. DataLoader דורש ממנה שתי שיטות בלבד: __len__ מחזירה את מספר הדוגמאות, ו־__getitem__ מחזירה זוג קלט ותשובה לפי אינדקס. כל השאר — הערבוב והחלוקה לאצוות — נעשה בשבילנו.
class TempDataset(Dataset):

    def __init__(self, x, y):
        self.x = torch.tensor(x, dtype=torch.float32)
        self.y = torch.tensor(y, dtype=torch.float32)

    def __len__(self):
        return len(self.x)

    def __getitem__(self, index):
        return self.x[index], self.y[index]
ניצור את אוסף הנתונים ממערכי x ו־y שבנינו:
ds = TempDataset(data_x, data_y)
נחלק לאצוות של 50 דוגמאות ונערבב את הסדר. הערבוב חשוב כאן במיוחד: ערכי x נוצרו בסדר עולה, ובלי ערבוב כל אצווה הייתה מכילה רק קטע קטן וסמוך של הגרף:
dl = DataLoader(ds, batch_size=50, shuffle=True)
הגדרת המודל הלינארי
נתחיל בניסוי הראשון: הקו הישר. נגדיר מודל nn.Linear בעל קלט אחד ופלט אחד, עם הטיה — כלומר שני פרמטרים בלבד, שיפוע והטיה, בדיוק כמו ברגרסיה הלינארית שהכרנו. נשתמש ב־MSE, פונקציית ההפסד לחיזוי מספר, וב־Adam בקצב 0.0001, במשך 100 מעברים (אפוקים) על הנתונים. הרשימה losses תשמור את ההפסד של כל אצווה כדי שנוכל לצייר אותו בהמשך.
learning_rate = 1e-4 # 0.1
epochs = 100
losses = []

# design model
Model = nn.Linear(1, 1, bias=True)

#construct loss and optimizer
Loss = nn.MSELoss()

# init optimizer
# optim = torch.optim.SGD(Model.parameters(), lr=learning_rate)
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון המודל הלינארי
לולאת האימון היא הלולאה הכפולה שהכרנו: הלולאה החיצונית עוברת על האפוקים, והפנימית מקבלת מ־dl אצווה אחר אצווה, כשכל אצווה היא זוג של טנסור קלטים וטנסור תשובות. בכל אצווה נחשב תחזיות והפסד, נחשב נגזרות ונעדכן את הפרמטרים.
for epoch in range(epochs):
    for x_batch, y_batch in dl:
        # forward
        Y_predict = Model(x_batch)

        # backward
        loss = Loss(Y_predict, y_batch)
        loss.backward()

        # update wights
        optim.step()

        if epoch < 10 :
            print(f"epoch= {epoch} loss={loss.item():.4f} ")


        if epoch % 10 == 0:
            print(f"epoch= {epoch} loss={loss.item():.4f} ")
            # print (Y_predict)

        losses.append(loss.item())

        # zero grads
        optim.zero_grad()
תחילת הפלט השמור וסופו:
פלט
epoch= 0 loss=17.2386
epoch= 0 loss=17.2386
epoch= 0 loss=18.2715
epoch= 0 loss=18.2715
...
epoch= 90 loss=0.0786
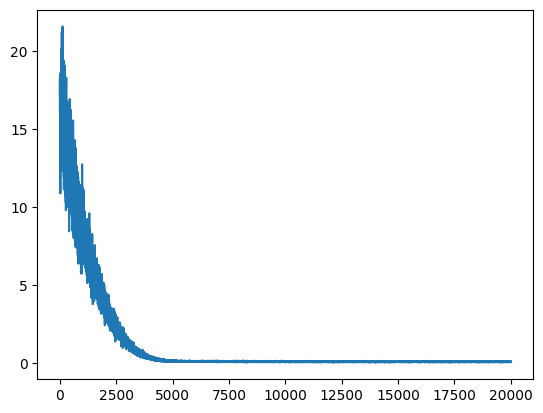
ההפסד יורד מכ־17–18 בתחילת האימון ל־0.0786 באפוק 90. הפלט הוא דוגמה שמורה ועשוי להשתנות בהרצה חדשה. שני תנאי ההדפסה מתקיימים ב־epoch=0, ולכן כל הפסד אצווה בו מודפס פעמיים.
הפסד האימון והקו שנלמד
כדי להעריך את המודל נבחן שני דברים: כיצד ירד ההפסד במהלך האימון, ואיזה קו התקבל בסופו. נציג את ההפסדים שנשמרו בכל אצווה:
plt.plot(losses)
נציג את הקו מול הנתונים. נעביר את כל ערכי x דרך המודל בתוך torch.no_grad(), כי כאן אנו רק מחשבים תחזיות ואין צורך בנגזרות:
plt.scatter( data_x, data_y, s=0.5, color='black')
plt.xlabel('year')
plt.ylabel('temperature')
with torch.no_grad():
    plt.plot(data_x, Model(torch.tensor(data_x, dtype=torch.float32)), color='r')
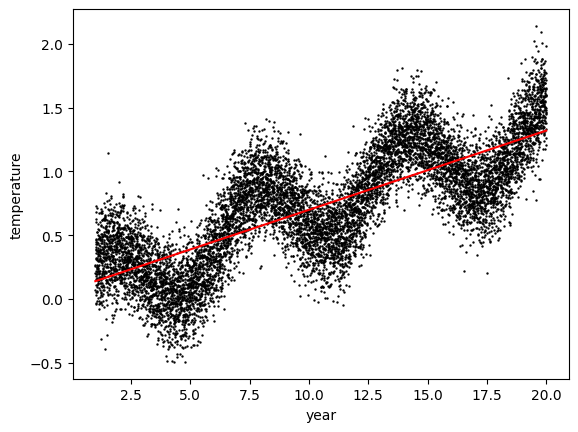
הקו מתאר מגמה כללית, אך אינו עוקב אחר הפסגות והעמקים. זו בדיוק המגבלה שדיברנו עליה: לא משנה כמה נאמן, למודל יש רק שני פרמטרים ואין לו דרך "להתעקם". ההפסד שנותר, כ־0.08, הוא המחיר של הפער בין הקו לגלים.
נציג את המשקל ואת ההטיה שהמודל למד — השיפוע ונקודת החיתוך של הקו:
for name, param in Model.named_parameters():
    print(name, param)
פלט
weight Parameter containing:
tensor([[0.0621]], requires_grad=True)
bias Parameter containing:
tensor([0.0780], requires_grad=True)
מעבר לרשת עם שכבות חבויות
כעת הניסוי השני. נחליף את הקו הישר ברשת בעלת שתי שכבות חבויות של 64 יחידות, עם ReLU, בדיוק לפי התבנית שהכרנו בפרק הקודם: nn.Linear(1, 64) מקבלת את הקלט היחיד ופורשת אותו ל־64 יחידות, שכבה נוספת מ־64 ל־64, ושכבת פלט מ־64 למספר אחד. במקום שני פרמטרים יש כעת אלפים, וה־ReLU בין השכבות הוא שמאפשר לרשת לתאר עקומה. הפלט נשאר מספר, ללא אקטיבציה בשכבה האחרונה — במשימת רגרסיה התשובה יכולה להיות כל מספר, ואיננו רוצים להגביל את הטווח — ופונקציית ההפסד נשארת MSE. נגדיר Adam בקצב 0.001 ו־200 מעברים על הנתונים.
learning_rate = 1e-3 # 0.1
epochs =200
losses = []

# design model
Model = nn.Sequential(
    nn.Linear(1, 64, bias=True),
    nn.ReLU(),
    nn.Linear(64, 64, bias=True),
    nn.ReLU(),
    # nn.Linear(64, 64, bias=True),
    # nn.ReLU(),
    nn.Linear(64, 1, bias=True)
)


#construct loss and optimizer
Loss = nn.MSELoss()

# init optimizer
# optim = torch.optim.SGD(Model.parameters(), lr=learning_rate)
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון הרשת
נפעיל את לולאת האימון על הרשת החדשה, כדי שתלמד את הקשר הלא־לינארי שבנתונים. שימו לב שהלולאה עצמה זהה לחלוטין לזו של המודל הלינארי — אותם נתונים, אותו הפסד, אותו סדר פעולות. זהו אחד היתרונות הגדולים של PyTorch: החלפת המודל אינה דורשת שינוי בתהליך האימון. ההבדל היחיד הוא שההדפסה עברה אל מחוץ ללולאה הפנימית, פעם אחת בסוף כל אפוק.
for epoch in range(epochs):
    for x_batch, y_batch in dl:
        # forward
        Y_predict = Model(x_batch)

        # backward
        loss = Loss(Y_predict, y_batch)
        loss.backward()

        # update wights
        optim.step()

        losses.append(loss.item())

        # zero grads
        optim.zero_grad()

    if epoch % 1 == 0:
        print(f"epoch= {epoch} loss={loss.item():.4f} ")
תחילת הפלט השמור וסופו:
פלט
epoch= 0 loss=0.0775
epoch= 1 loss=0.1374
epoch= 2 loss=0.0980
epoch= 3 loss=0.1153
...
epoch= 199 loss=0.0224
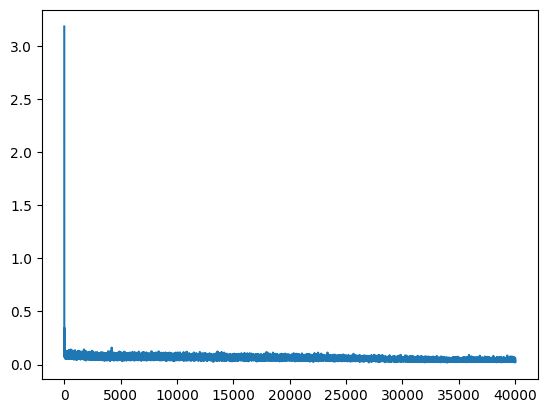
בכל מעבר מודפס כאן ההפסד של האצווה האחרונה; הרשימה losses שומרת את ההפסד של כל אצווה. כבר בסוף האפוק הראשון ההפסד הוא 0.0775 — קרוב לערך שאליו הגיע הקו הישר אחרי 90 אפוקים — ובסוף האימון הוא 0.0224. ההפסד אינו יורד באופן חלק (למשל 0.1374 באפוק 1 אחרי 0.0775 באפוק 0), משום שבכל פעם הוא נמדד על אצווה אחרת של 50 דוגמאות אקראיות.
הפסד האימון ותחזיות הרשת
נבחן כיצד השתנה ההפסד ואיזו עקומה הרשת למדה. כך נוכל להשוות את ההתאמה לזו של הקו הישר.
plt.plot(losses)
נציג את התחזיות מול הנתונים:
plt.scatter( data_x, data_y, s=0.5, color='black')
plt.xlabel('year')
plt.ylabel('temperature')
with torch.no_grad():
    plt.plot(data_x, Model(torch.tensor(data_x, dtype=torch.float32)), color='r')
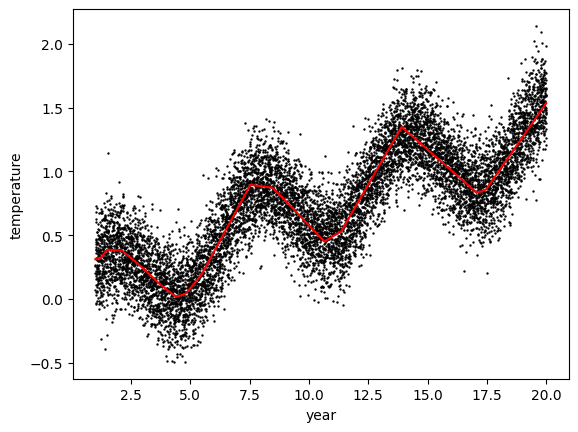
הרשת עוקבת אחר השינוי הגלי טוב יותר מהקו הישר. העקומה האדומה עולה ויורדת עם הנתונים, אך אינה עוקבת אחר כל נקודה בודדת — וזה רצוי: הרעש האקראי שהוספנו אינו חלק מהקשר האמיתי, ומודל טוב אמור להתעלם ממנו ולא לשנן אותו.
לבסוף נציג את הפרמטרים של כל שכבות הרשת. במקום משקל אחד והטיה אחת, נקבל כעת משקלים והטיות לכל אחת משלוש השכבות, וזו ההמחשה הטובה ביותר להבדל בין שני המודלים: את הפרמטרים של הקו הישר יכולנו לקרוא ולפרש בעצמנו, ואילו הפרמטרים של הרשת רבים מכדי לפרשם — אך יחד הם מתארים עקומה שקו ישר לא יכול לתאר:
for name, param in Model.named_parameters():
    print(name, param)