ג.7 רגרסיה לינארית — נקודה אחת
נדמיין חנות שרושמת, בכל יום, כמה מעלות היה חם בחוץ וכמה בקבוקי מים נמכרו. אחרי כמה שבועות יש בידינו טבלה של זוגות: טמפרטורה ומכירות. מבט בנתונים מגלה מגמה — ככל שחם יותר, מוכרים יותר — אך הנקודות אינן מסודרות על קו מושלם, כי בכל יום יש גם גורמים אקראיים. השאלה שמעניינת את בעל החנות אינה "כמה מכרנו ביום שכבר עבר", אלא "כמה נמכור מחר, כשהתחזית אומרת 34 מעלות" — טמפרטורה שאולי מעולם לא נמדדה בדיוק. כדי לענות עליה צריך לתאר את הקשר הכללי בין הקלט לתוצאה, ולא רק לזכור את הנקודות שנאספו.
זו בדיוק המטרה של רגרסיה לינארית — Linear Regression: למצוא קו ישר שמתאר היטב את הקשר בין הקלט x לבין התוצאה y. הקו מתאר את מגמת הנתונים, ואינו חייב לעבור בכל הנקודות. ברגע שיש בידינו הקו, אפשר להציב בו כל ערך של x — גם ערך שלא הופיע בנתונים — ולקבל הערכה של y. היכולת הזו, להסיק מהדוגמאות שראינו על מקרים שלא ראינו, נקראת הכללה — Generalization, והיא לב־לבה של למידת מכונה: המודל אינו לומד את הנתונים בעל־פה, אלא לומד את הכלל שמסתתר מאחוריהם.
בפרק זה נתחיל במקרה הפשוט ביותר: ישר העובר בראשית הצירים ונקודה אחת. בפרק הבא נתאים ישר כזה לכמה נקודות יחד, ואחריו נוסיף לישר פרמטר שני, ההטיה, שיאפשר לו שלא לעבור בראשית.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 5. רגרסיה לינארית · השיעור באתר הקורס · מחברת רגרסיה לינארית ב־Colab
נייבא את הספריות שישמשו אותנו לאורך הפרק: PyTorch לחישובים ולאימון, NumPy ליצירת טווחי ערכים, ו־Matplotlib לציור הנקודות והישרים:
import torch
import numpy as np
import matplotlib.pyplot as plt
רגרסיה בנקודה אחת
נתחיל מהמקרה הקטן ביותר האפשרי, שבו קל לבדוק כל שלב: נקודה אחת בלבד. קיבלנו את הנקודה (2, 4.5), ואנו מחפשים את נוסחת הקו הישר שעובר בראשית הצירים ומגיע לנקודה.
משיעורי המתמטיקה מוכר הישר y = mx: ישר העובר בראשית הצירים, ש־m הוא השיפוע שלו. בישר כזה יש נעלם אחד בלבד, השיפוע m, ומציאתו היא כל מה שנדרש כדי לדעת את הישר כולו. בלמידת מכונה נהוג לקרוא למספר שהמודל לומד משקל — weight, ולסמנו באות w. לכן מכאן ואילך נכתוב את הישר כ־y = w·x, ונחפש את w. זהו אותו m בשם אחר.
נסכם את המשימה במשפט אחד: אנחנו מחפשים פונקציה לינארית, ובפונקציה לינארית שעוברת בראשית הצירים יש רק דבר אחד לא ידוע — המשקל w. כל ערך של w נותן ישר אחר, ואנו רוצים את הישר שמגיע לנקודה. את התשובה אפשר כמובן לחשב בראש — 4.5 חלקי 2 — אבל נפתור אותה דווקא בדרך שהמחשב לומד, כדי לראות את כל שלבי התהליך במקרה שבו אפשר לבדוק את התוצאה.
הטעות — loss
נניח שהמחשב עדיין לא יודע דבר ומנחש ניחוש שרירותי: w = 1. הישר שמתקבל הוא y = 1·x. מה הוא מנבא עבור x = 2? את הערך y_predict = 1·2 = 2. אבל הערך הרצוי, זה שנתון בנקודה, הוא 4.5. הפער בין התחזית לתוצאה הרצויה הוא הטעות, ובלמידת מכונה קוראים לה הפסד — loss:
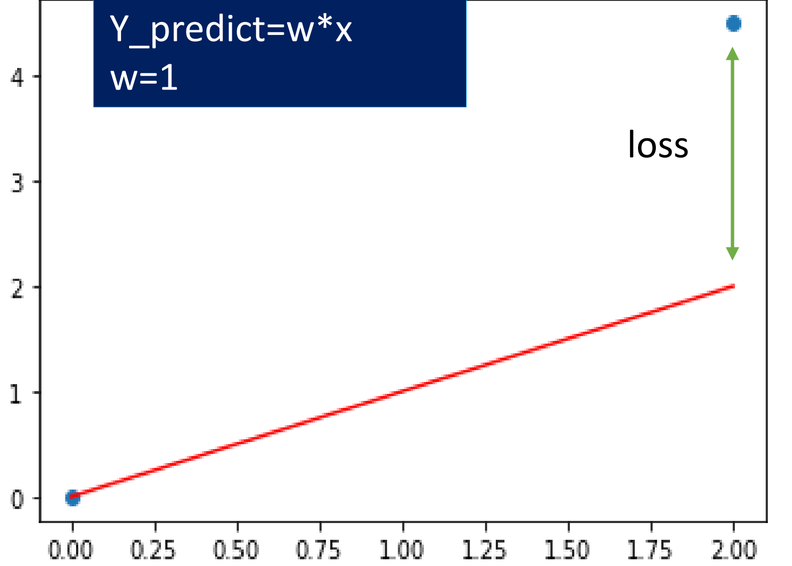
נתבונן בתמונה. הנקודה הכחולה הימנית היא הנקודה הנתונה (2, 4.5). הישר האדום הוא הניחוש שלנו, y = 1·x, והוא מגיע ב־x = 2 רק לגובה 2. החץ הירוק מחבר בין קצה הישר לבין הנקודה: אורכו הוא 4.5 − 2 = 2.5, וזוהי הטעות של הניחוש w = 1. אם נגדיל את w, הישר יהיה תלול יותר, קצהו יתקרב לנקודה והחץ יתקצר; ב־w = 2.25 הישר יגיע בדיוק לנקודה והחץ ייעלם. אם נגדיל את w יותר מדי, הישר יעבור מעל הנקודה ותיווצר טעות בכיוון ההפוך. לכן המטרה של האימון ניתנת לניסוח פשוט: למצוא את w שעבורו הטעות קטנה ככל האפשר.
בניית פונקציית הטעות
כדי שהמחשב יוכל לחפש את w הזה, לא מספיק לומר "הטעות קטנה". צריך לבנות פונקציה שמקבלת ערך של w ומחזירה מספר אחד שאומר עד כמה הישר עם המשקל הזה טועה. את הפונקציה הזו אנו בונים במיוחד לצורך החישוב שלנו, מתוך הנתונים שקיבלנו: הנקודה (2, 4.5) קבועה, והדבר היחיד שמשתנה הוא w. נגדיר:
שימו לב לשינוי נקודת המבט. עד עכשיו x היה המשתנה ו־y תלוי בו. בפונקציית הטעות x ו־y הם מספרים קבועים שנלקחו מהנקודה, והמשתנה היחיד הוא w: הקלט של הפונקציה הוא משקל, והפלט הוא גודל הטעות של הישר עם המשקל הזה. עבור w = 1 מתקבל loss = (2 − 4.5)² = 6.25, ועבור w = 2.25 מתקבל loss = 0. מדוע מעלים את ההפרש בריבוע ולא משאירים אותו כמות שהוא? נדון בכך בסעיף נפרד בהמשך; בינתיים די לדעת שהריבוע הופך כל טעות למספר חיובי.
הפונקציה הזו היא בדיוק מה שצריך לכלי שכבר בידינו: פונקציה של משתנה אחד, w, שאנו מחפשים את המינימום שלה. זו המשימה שפתרנו בפרק ג.5 באמצעות Gradient Descent, ועכשיו נפעיל אותו על פונקציית הטעות.
האלגוריתם
האלגוריתם במילים, צעד אחר צעד:
- מתחילים מ־w שרירותי, למשל w = 1.
- מחשבים את התחזית של הישר הנוכחי עבור הנקודה: y_predict = w·x.
- מחשבים את הטעות בריבוע: loss = (y_predict − y)².
- מחשבים את הנגזרת של ההפסד לפי w. הנגזרת אומרת לאיזה כיוון צריך להזיז את w כדי שהטעות תקטן, ובכמה בערך. את החישוב עושה Autograd מפרק ג.4.
- מעדכנים את המשקל בכיוון ההפוך לנגזרת, לפי כלל העדכון מפרק ג.5: w = w − learning_rate·grad, ומאפסים את הנגזרת לקראת הסיבוב הבא.
- חוזרים לשלב 2 עם ה־w החדש.
נעקוב אחר סיבוב אחד עם המספרים שלנו. עבור w = 1 התחזית היא 2 וההפסד 6.25. הנגזרת של ההפסד לפי w היא 4·(2w − 4.5), ועבור w = 1 מתקבל 4·(−2.5) = −10. הנגזרת שלילית, ולכן יש להגדיל את w: עם קצב למידה 0.01 נקבל w = 1 − 0.01·(−10) = 1.1. הישר נעשה תלול מעט יותר והתקרב לנקודה. בסיבוב הבא הטעות קטנה יותר, הנגזרת קטנה יותר, והצעד קטן יותר, וכך הלאה.
הלולאה. שלבים 2 עד 5 חוזרים על עצמם שוב ושוב, וכל סיבוב כזה נקרא אפוק — epoch. בכל אפוק יש שלושה חלקים קבועים: מעבר קדימה (Forward) — חישוב התחזית מהקלט; מעבר לאחור (Backward) — חישוב ההפסד והנגזרת; ועדכון המשקל ואיפוס הנגזרת. עוצרים אחרי מספר אפוקים שנקבע מראש, כשההפסד כבר אינו יורד, כפי שראינו בסעיף "מתי עוצרים?" בפרק ג.5.
כשמתרגמים את האלגוריתם לתוכנית, היא מתחלקת תמיד לאותם חלקים:
- הכנת הנתונים — Prepare data.
- בניית המודל — Design model: כאן
model = w * x. - בניית פונקציית ההפסד והאופטימייזר — Build loss and optimizer.
- לולאת האימון — Training loop: מעבר קדימה, מעבר לאחור, עדכון המשקל ואיפוס הנגזרת.
- הדפסת התוצאות — Print results.
מבנה זה ילווה אותנו בכל מודל שנבנה בהמשך הספר, גם כשהמודל יהיה רשת נוירונים עם אלפי משקלים; רק התוכן של כל חלק ישתנה.
למה טעות בריבוע?
לפני שנכתוב את הקוד נחזור לשאלה שדחינו. ההפרש הגולמי y_predict − y אינו מתאים לשמש כפונקציית טעות: כשהישר מתחת לנקודה ההפרש שלילי, וכשהוא מעליה ההפרש חיובי. אילו ניסינו להקטין את ההפרש הגולמי, היינו "משתפרים" בלי סוף על ידי הורדת הישר עוד ועוד, כי מספר שלילי גדול הוא קטן יותר. פונקציית טעות טובה חייבת להיות אי־שלילית, ולהתאפס רק כשהישר פוגע בנקודה. שתי דרכים טבעיות להשיג זאת: ערך מוחלט, |y_predict − y|, או ריבוע, (y_predict − y)².
הריבוע נותן פרבולה חלקה עם מינימום יחיד. ככל שמתקרבים לתחתית, השיפוע שלה הולך וקטן ושואף לאפס בהדרגה, ולכן צעדי Gradient Descent מתקצרים מאליהם ככל שמתקרבים לפתרון, כפי שראינו בפרק ג.5. יתרון נוסף: טעות גדולה "נענשת" הרבה יותר מטעות קטנה, כי הריבוע מגדיל אותה.
הערך המוחלט נותן צורת V. בנקודת המינימום שלה יש פינה חדה, ושם אין נגזרת בכלל. גם משני צידי הפינה השיפוע אינו יורד לאפס אלא נשאר קבוע, ורק מחליף סימן פעם אחת במעבר דרך המינימום. לכן Gradient Descent היה פוסע בצעדים באותו גודל גם ליד הפתרון, מדלג מעליו הלוך ושוב ולא מתייצב. הירידה ההדרגתית לאפס היא היתרון המכריע של הריבוע.
נצייר את פונקציית הטעות שלנו עבור שיפועים בין −4 ל־9. הציר האופקי הוא המשקל w, והציר האנכי הוא ההפסד:
x, y = 2, 4.5

w_np = np.linspace(-4, 9, 100)

loss_np = (w_np*x - y)**2
plt.plot(w_np, loss_np)
plt.title("loss = (w * x - y)^2;   x = 2; y = 4.5")
plt.ylabel("loss")
plt.xlabel("W")
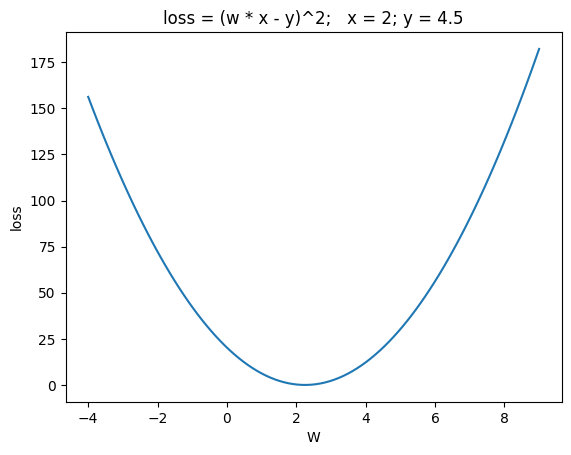
התקבלה פרבולה עם מינימום יחיד, בדיוק הצורה שעבורה Gradient Descent עובד היטב. הנקודה הנמוכה ביותר שלה היא השיפוע שמעביר את הישר דרך הנקודה, w = 2.25, ובהמשך נראה שהאימון אכן מגיע אליה.
מימוש בקוד
נכתוב עתה את התוכנית לפי חמשת החלקים שהגדרנו באלגוריתם.
הכנת הנתונים
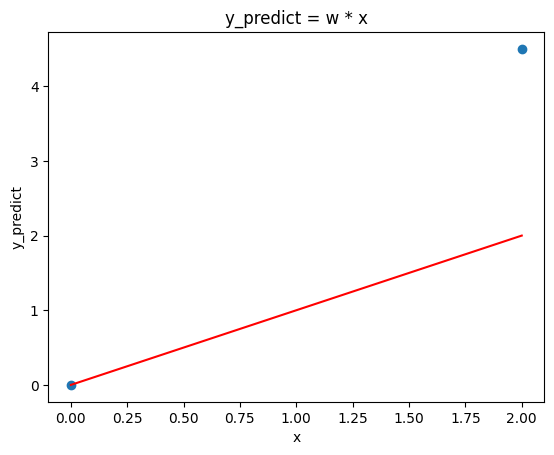
נגדיר את הנקודה ונצייר את הניחוש הראשון, w = 1, כדי לראות בקוד את התמונה שהסברנו לעיל: הישר האדום, הנקודה, והפער ביניהם שהוא הטעות:
x, y = 2, 4.5
w = 1

y_pre = w * x

plt.scatter([0,x],[0,y])
plt.plot([0,x], [0,y_pre], color = 'red')
plt.title("y_predict = w * x")
plt.ylabel("y_predict")
plt.xlabel("x")
בניית המודל
מודל — Model הוא הפונקציה שמקבלת קלט ומחזירה תחזית. כאן המודל הוא בדיוק הישר שאנחנו מחפשים: הפונקציה הלינארית y = w·x, שמקבלת x ומחזירה את ערך ה־y של הישר. הפונקציה model בקוד היא נוסחת הישר הזו, והמשקל W שבתוכה הוא השיפוע שהאימון ילמד. בהמשך הספר המודלים יהיו רשתות נוירונים, אך הרעיון יישאר זהה: פונקציה עם פרמטרים שהאימון מכוון. נגדיר את הנתונים כטנסורים כדי ש־Autograd יוכל לחשב נגזרות, ואת המשקל נסמן ב־requires_grad=True. הפעם נאתחל את המשקל ל־−1.5 ולא ל־1: ערך התחלתי רחוק בכוונה מהפתרון, כדי שנוכל לראות את האימון מתקדם לאורך יותר צעדים. קצב הלמידה הוא 0.01:
X = torch.tensor(2)
Y = torch.tensor(4.5)
W =  torch.tensor(-1.5, dtype=torch.float32, requires_grad=True)
learning_rate = 0.01

def model (X):
    return W * X
בניית פונקציית ההפסד והאופטימייזר
הפונקציה loss היא פונקציית הטעות שבנינו: ריבוע ההפרש בין התחזית לתוצאה הרצויה. האופטימייזר, שהכרנו בפרק ג.5, מבצע את צעד העדכון של Gradient Descent; הוא מקבל את רשימת הפרמטרים שעליו לעדכן, כאן רק W, ואת קצב הלמידה:
def loss (Y_predict, Y):
    return (Y_predict - Y)**2  #(W * X - Y)**2

optim = torch.optim.SGD([W], lr=learning_rate) # W = W - grad * learning_rate
לולאת האימון
הלולאה מבצעת 300 אפוקים. בכל אפוק: מעבר קדימה — חישוב התחזית; מעבר לאחור — חישוב ההפסד והנגזרת; עדכון המשקל ב־step() ואיפוס הנגזרת ב־zero_grad(). אחת לעשרה אפוקים מדפיסים את המצב כדי לעקוב אחר ההתקדמות:
epochs = 300
for epoch in range(epochs):
    # Forward
    Y_predict = model(X)

    # Backward - calculate new grads
    l = loss(Y_predict, Y)
    l.backward()

    if (epoch) % 10 == 0:
        print (f"epoch={epoch} W={W:.3f}, Y_predict={Y_predict:.3f}, loss={l:.6f} grad={W.grad}")

    # Update weight
    optim.step()  # w = w - grad * LR

    # zero grads
    optim.zero_grad()
פלט
epoch=0 W=-1.500, Y_predict=-3.000, loss=56.250000 grad=-30.0
epoch=10 W=0.621, Y_predict=1.242, loss=10.614001 grad=-13.031654357910156
epoch=20 W=1.542, Y_predict=3.085, loss=2.002790 grad=-5.660799026489258
epoch=30 W=1.943, Y_predict=3.885, loss=0.377913 grad=-2.458986282348633
epoch=40 W=2.116, Y_predict=4.233, loss=0.071310 grad=-1.068155288696289
epoch=50 W=2.192, Y_predict=4.384, loss=0.013456 grad=-0.4639930725097656
epoch=60 W=2.225, Y_predict=4.450, loss=0.002539 grad=-0.2015552520751953
epoch=70 W=2.239, Y_predict=4.478, loss=0.000479 grad=-0.08755111694335938
epoch=80 W=2.245, Y_predict=4.490, loss=0.000090 grad=-0.03803062438964844
epoch=90 W=2.248, Y_predict=4.496, loss=0.000017 grad=-0.016519546508789062
epoch=100 W=2.249, Y_predict=4.498, loss=0.000003 grad=-0.007175445556640625
epoch=110 W=2.250, Y_predict=4.499, loss=0.000001 grad=-0.0031185150146484375
epoch=120 W=2.250, Y_predict=4.500, loss=0.000000 grad=-0.001354217529296875
epoch=130 W=2.250, Y_predict=4.500, loss=0.000000 grad=-0.0005893707275390625
epoch=140 W=2.250, Y_predict=4.500, loss=0.000000 grad=-0.0002536773681640625
epoch=150 W=2.250, Y_predict=4.500, loss=0.000000 grad=-0.000110626220703125
epoch=160 W=2.250, Y_predict=4.500, loss=0.000000 grad=-4.76837158203125e-05
epoch=170 W=2.250, Y_predict=4.500, loss=0.000000 grad=-2.09808349609375e-05
epoch=180 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=190 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=200 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=210 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=220 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=230 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=240 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=250 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=260 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=270 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=280 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
epoch=290 W=2.250, Y_predict=4.500, loss=0.000000 grad=-1.1444091796875e-05
נקרא את הפלט. באפוק 0 המשקל הוא −1.5, התחזית −3 (רחוקה מאוד מ־4.5), ההפסד 56.25 והנגזרת −30: נגזרת שלילית גדולה פירושה שיש להגדיל את המשקל בצעדים גדולים. ואכן המשקל עולה במהירות: 0.62, 1.54, 1.94, 2.12, ומתקרב ל־2.25, בעוד ההפסד צונח מ־56 ל־0.07 בתוך ארבעים אפוקים. שימו לב לעמודת הנגזרת: היא הולכת וקטנה בהדרגה, −30, −13, −5.7, −2.5, −1.1, ולכן גם הצעדים מתקצרים מאליהם ככל שמתקרבים לפתרון. זהו בדיוק היתרון של הטעות בריבוע שהסברנו קודם. מאפוק 120 בערך המשקל הוא 2.250, ההפסד אפס בדיוק המודפס והנגזרת כמעט אפס: הגענו לתחתית הפרבולה, ו־180 האפוקים הנותרים כבר אינם משנים דבר.
מה פירוש e-05 בפלט? מאפוק 160 הנגזרת מודפסת בצורה כמו -1.1444091796875e-05. זהו כתיב מדעי: האות e פירושה "כפול 10 בחזקת", והמספר שאחריה הוא החזקה. לכן 1.1444e-05 הוא 1.1444 × 10⁻⁵, כלומר 0.000011444: מזיזים את הנקודה העשרונית חמישה מקומות שמאלה. פייתון עוברת לכתיב הזה מאליה כשהמספר קטן מאוד (או גדול מאוד), כדי לא להדפיס שורה ארוכה של אפסים. כל שורות הפלט האחרונות מספרות אפוא את אותו דבר: הנגזרת היא כמה מיליוניות, כמעט אפס.
הדפסת התוצאות
נחשב את התחזית עם המשקל שנלמד ונצייר את הישר שהתקבל:
Y_predict = model(X)
l = loss(Y_predict, Y)
print (f"W={W:.3f}, Y_predict={Y_predict:.3f}, loss={l:.6f}")

plt.scatter(x,y)
plt.plot([0,x], [0,Y_predict.item()], color = 'red')
plt.show()
פלט
W=2.250, Y_predict=4.500, loss=0.000000
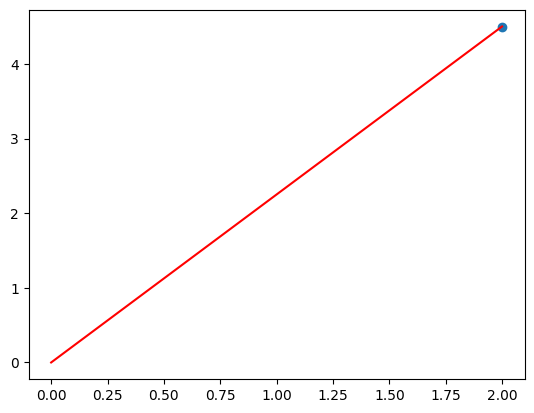
האלגוריתם מצא את w = 2.25, הישר עובר בדיוק בנקודה, וההפסד עבור משקל זה הוא 0, המינימום. הישר "למד" את הנקודה בלי שאמרנו לו את התשובה: מצאנו אותה דרך הקטנת הטעות בלבד.
נקודה אחת היא מקרה מלאכותי: תמיד אפשר להעביר ישר דרך הראשית ודרך נקודה אחת, וההפסד יורד לאפס. בפרק הבא נעבור למצב המעניין באמת, שתיארנו בפתיחה: כמה נקודות שאינן על ישר אחד, וישר יחיד שצריך לתאר את כולן.