ג.10 רגרסיה לינארית וחשיבות נרמול הנתונים
בפרקים הקודמים למדנו רגרסיה לינארית על נתונים "נוחים": מספרים קטנים, בסדר גודל של יחידות בודדות. בעולם האמיתי הנתונים נראים אחרת. שטח דירה נמדד בעשרות ומאות מטרים, מחירה במיליוני שקלים, ומספר הקומה בין 1 ל־10; ובבעיה אחרת נוכל לפגוש הכנסה שנתית באלפים לצד גיל בעשרות. המודל אינו יודע מהן "יחידות" — עבורו אלה סתם מספרים, ומספרים גדולים מייצרים נגזרות גדולות, צעדי עדכון גדולים, ובסופו של דבר אימון שמתפוצץ.
הפתרון נקרא נרמול — Normalization: לפני האימון ממירים את הערכים לסולם אחיד ונוח, בדרך כלל בסביבות 0–1, בלי לאבד את המידע שבהם. המטרה היא כפולה: להקל על החישוב, כך שקצב למידה סביר אחד יתאים לכל התכונות, ולמנוע התבדרות — Divergence, המצב שבו ההפסד גדל מצעד לצעד במקום לקטון עד שהמספרים יוצאים מכל שליטה. הרעיון פשוט — מתמטית זה רק חיסור וחילוק — אך בלעדיו רשתות רבות פשוט לא מתאמנות.
בפרק זה נראה את הבעיה לפני שנראה את הפתרון. נאמן מודל רגרסיה על נתוני דירות בלי נרמול, נראה כיצד האימון מתבדר, ננסה שתי דרכים חלופיות להתמודד עם הבעיה — קצב למידה זעיר ואופטימייזר אחר — ורק אז ננרמל את הנתונים ונראה שהאימון מתנהל בקלות. נסיים בנקודה חשובה: מודל שאומן על נתונים מנורמלים חייב לקבל גם בעת החיזוי נתונים שנורמלו באותו האופן.
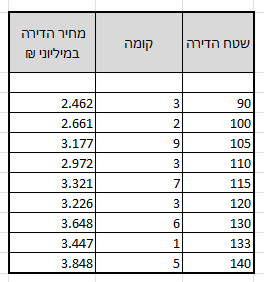
גודל הערכים שמזינים למודל עשוי להשפיע על התקדמות האימון. נבחן זאת בעזרת נתוני שטח, קומה ומחיר של תשע דירות. ננסה למצוא נוסחה לחיזוי מחיר הדירה לפי שטחה; בשלב זה נתעלם מהקומה. כמו בכל רגרסיה, המטרה היא לא רק לתאר את תשע הדירות שבידינו, אלא למצוא קשר כללי שיאפשר להעריך את מחירה של דירה שאינה ברשימה.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 5.3. רגרסיה לינארית ונרמול נתונים (עותק מקומי) · מחברת התרגיל (עותק מקומי) · מחברת הפתרון (עותק מקומי)
תזכורת לשלבי העבודה
מהלך העבודה זהה לזה שהכרנו בפרקי הרגרסיה הקודמים, והנרמול ישתלב בו כשלב נוסף בהכנת הנתונים. נכין את הנתונים, נגדיר מודל, פונקציית הפסד ואופטימייזר, ונאמן בלולאה: חיזוי, חישוב ההפסד והנגזרות, עדכון הפרמטרים ואיפוס הנגזרות. לבסוף נציג את התוצאה.
הכנת הנתונים
נארגן את שטחי הדירות כקלט ואת מחיריהן כתוצאה שאותה נרצה לחזות. שימו לב לסדרי הגודל: השטחים הם מספרים בין 90 ל־140, והמחירים בין 2.4 ל־3.9 — פער של פי כמה עשרות בין הקלט לפלט. נייבא את הספריות וניצור את מערכי הנתונים:
import torch
import numpy as np
import matplotlib.pyplot as plt
import torch.nn as nn
X_np = np.array([90,100,105,110,115,120,130,133,140])
F_np = np.array([3,2,9,3,7,3,6,1,5])
P_np = np.array([2.462,2.661,3.177,2.972,3.321,3.226,3.648,3.447,3.848])
# P_np = np.around((X_np * 25.5 + F_np * 55.5)/1000, decimals=3)
plt.scatter(X_np, P_np)
plt.title("Apartment price by area")
plt.ylabel("Price in millions")
plt.xlabel("Area in square metres")
השורה שבהערה מגלה כיצד נוצרו המחירים: נוסחה לינארית של השטח והקומה, ולכן יש קשר לינארי שאפשר לגלות. במערך F_np שמורות הקומות, שבהן נשתמש רק בפרק הבא.
נמיר את השטח ואת המחיר לטנסורים, ונסדר אותם לפי הכלל שלמדנו בפרק הקודם: כל שורה היא דוגמה. הפעם קל במיוחד לראות זאת, כי הנתונים הגיעו מטבלה: בטבלת הדירות שבראש הפרק כל שורה היא דירה, וכל עמודה היא נתון עליה: שטח, קומה ומחיר. בדיוק כך nn.Linear מצפה לקבל את הנתונים. הקלט X הוא עמודת השטח בלבד, 9 שורות (דירה בכל שורה) ועמודה אחת; התשובה Y היא עמודת המחיר, 9 שורות ועמודה אחת. הקריאה reshape(-1,1) הופכת כל מערך לעמודה כזו:
X = torch.from_numpy(X_np.astype(np.float32))
Y = torch.from_numpy(P_np.astype(np.float32))
X = X.reshape(-1,1)
Y = Y.reshape(-1,1)
print(X.shape, Y.shape)
פלט
torch.Size([9, 1]) torch.Size([9, 1])
תשע שורות, דירה בכל שורה, ועמודה אחת בכל טבלה: עמודת השטח ב־X ועמודת המחיר ב־Y. השורה החמישית ב־X (115) והשורה החמישית ב־Y (3.321) הן אותה דירה.
הגדרת המודל והאופטימייזר
כעת נגדיר את שלושת המרכיבים של האימון בדיוק כפי שעשינו בפרק הקודם. נשתמש בישר עם משקל והטיה, ב־MSE וב־SGD עם קצב למידה 0.1 — אותו קצב שעבד היטב בדוגמאות הקודמות. ה־1 הראשון ב־nn.Linear(1, 1) הוא מספר העמודות של X, נתון אחד על כל דירה, השטח:
learning_rate = 0.1
epochs = 100
losses = []
Model = nn.Linear(1, 1, bias=True)
Loss = nn.MSELoss()
optim = torch.optim.SGD(Model.parameters(), lr=learning_rate)
לולאת האימון
נריץ תחילה את האימון על הנתונים ללא נרמול, כדי לראות כיצד הוא מתקדם. נבצע 100 איטרציות ונשמור את ההפסד בכל איטרציה. כדי לראות מקרוב מה קורה בהתחלה, נדפיס את ההפסד בכל אחד מעשרת האפוקים הראשונים, ואחר כך אחת לעשרה:
for epoch in range(epochs):
    Y_predict = Model(X)
    loss = Loss(Y_predict, Y)
    loss.backward()
    optim.step()

    if epoch < 10 or epoch % 10 == 0:
        print(f"epoch= {epoch} loss={loss.item():.4f}")

    losses.append(loss.item())
    optim.zero_grad()
תוצאות האימון — התבדרות
היינו מצפים שההפסד יקטן מאיטרציה לאיטרציה, כפי שקרה בפרקים הקודמים. הפעם קורה ההפך. בדוגמה זו ההפסד גדל במהירות במקום לקטון. דוגמת פלט מריצה שהתבדרה:
פלט
epoch= 0 loss=1879.0968
epoch= 1 loss=14039284736.0000
epoch= 2 loss=104893924685905920.0000
epoch= 3 loss=783710210201926452117504.0000
epoch= 4 loss=5855457594745668314902032285696.0000
epoch= 5 loss=inf
epoch= 6 loss=inf
epoch= 7 loss=inf
epoch= 8 loss=inf
epoch= 9 loss=inf
epoch= 10 loss=inf
epoch= 20 loss=nan
epoch= 30 loss=nan
epoch= 40 loss=nan
epoch= 50 loss=nan
epoch= 60 loss=nan
epoch= 70 loss=nan
epoch= 80 loss=nan
epoch= 90 loss=nan
עשרת האפוקים הראשונים מראים את ההתבדרות צעד אחר צעד. ההפסד מתחיל מכ־1,879, ובאפוק הבא הוא כבר 14 מיליארד; בכל אפוק הוא גדל פי כמה מיליונים, ואחרי ארבעה אפוקים הוא מספר בן 31 ספרות. באפוק 5 הוא כבר גדול מהמספר הגדול ביותר שטנסור מסוג float32 יכול להחזיק (בערך 3.4·10³⁸), והפלט הופך ל־inf.
inf מציין גלישה מספרית לערך אינסופי — המספר גדל מעבר למה שאפשר לייצג במחשב — ו־nan (Not a Number) מציין תוצאה שאינה מספר תקין, למשל תוצאה של חישוב עם אינסוף. משהופיע nan, כל חישוב שממשיך ממנו מחזיר nan, ולכן האימון למעשה נהרס ואין טעם להמשיך אותו. ערך ההפסד ההתחלתי עשוי להשתנות בין הרצות, משום שהשכבה מאותחלת מחדש.
גרדיאנטים גדולים או קטנים מדי
מה קרה כאן? נזכור שגודל הצעד בכל עדכון הוא מכפלת קצב הלמידה בגרדיאנט. במודל לינארי הגרדיאנט של המשקל תלוי ישירות בערכי הקלט: כשהמודל טועה במיליון שקלים ובשטח הדירה כתוב 120, הגרדיאנט מוכפל ב־120. גרדיאנטים גדולים מדי עלולים לגרום לעדכונים גדולים ולהתבדרות; גרדיאנטים קטנים מאוד עלולים להאט את הלמידה. בדוגמת הדירות, ערכי השטח 90–140 יחד עם קצב הלמידה שנבחר מובילים להתבדרות החישוב: כל עדכון קופץ הרחק מעבר למינימום, הטעות גדלה, הגרדיאנט הבא גדול עוד יותר, וכך הלאה עד לאינסוף.
שינוי קצב הלמידה ומספר האיטרציות
הדרך הישירה ביותר להקטין את הצעדים היא להקטין את קצב הלמידה. אפשר להקטין את קצב הלמידה ל־0.000001 ולהגדיל את מספר האיטרציות ל־1,000, מפני שצעדים קטנים דורשים צעדים רבים יותר. נאתחל מודל ואופטימייזר חדשים ונריץ שוב את לולאת האימון:
learning_rate = 0.000001
epochs = 1000
losses = []
Model = nn.Linear(1, 1, bias=True)
Loss = nn.MSELoss()
optim = torch.optim.SGD(Model.parameters(), lr=learning_rate)
דוגמה לפלט מתחילת האימון ובהמשכו:
פלט
epoch= 0 loss=8185.0425
epoch= 100 loss=32.0105
epoch= 200 loss=0.1555
epoch= 300 loss=0.0311
epoch= 400 loss=0.0306
epoch= 900 loss=0.0306
הפעם האימון מתכנס: ההפסד יורד מאלפים ל־0.03 ומתייצב. אבל הפתרון אינו נוח. היה עלינו לנחש קצב למידה קטן פי מאה אלף מהרגיל, ואם היינו מוסיפים תכונה בסדר גודל אחר, למשל הקומה, קצב אחד לא היה מתאים לשתיהן. נציג את ההפסד:
plt.plot(losses)
plt.show()
שינוי האופטימייזר
אפשרות נוספת היא להשתמש באופטימייזר Adam. Adam הוא אופטימייזר משוכלל יותר מ־SGD: הוא מתאים את גודל הצעד לכל פרמטר בנפרד לפי הגרדיאנטים שראה עד כה, ולכן הוא רגיש פחות לסולם הנתונים ולבחירת קצב הלמידה. גם הוא אינו מבטיח לפתור כל בעיית אימון; נבחן את התוצאה לאחר החלפת האופטימייזר.
נגדיר מחדש את המודל, הפעם בקצב 0.1 וב־200 איטרציות, ונריץ שוב את לולאת האימון:
learning_rate = 0.1
epochs = 200
losses = []
Model = nn.Linear(1, 1, bias=True)
Loss = nn.MSELoss()
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
דוגמה לשורות מתוך הפלט:
פלט
epoch= 0 loss=6299.0166
epoch= 10 loss=359.4584
epoch= 20 loss=134.9965
epoch= 30 loss=158.4764
epoch= 40 loss=11.8144
epoch= 100 loss=0.0269
epoch= 190 loss=0.0260
Adam הצליח להתכנס עם קצב הלמידה המקורי 0.1, אך הדרך אינה חלקה: ההפסד יורד, עולה שוב (בין איטרציה 20 ל־30) ורק אחר כך מתייצב. שני הפתרונות שראינו מטפלים בתסמין ולא בסיבה. הסיבה היא סולם הנתונים, ובה נטפל עכשיו.
נרמול הנתונים
נרמול משנה את סולם הערכים לפני הכנסתם למודל. הרעיון דומה להמרת יחידות: במקום לדבר על שטח במטרים, נדבר על "כמה הדירה גדולה ביחס לשאר הדירות". המידע נשמר — הדירה הגדולה נשארת הגדולה — אך המספרים נעשים קטנים ואחידים. שתי האפשרויות הבאות משתמשות במינימום ובמקסימום, או בממוצע ובסטיית התקן.
Min–Max: מחסרים את המינימום ומחלקים בטווח. ערכי האימון ממופים לתחום 0–1: הערך הקטן ביותר הופך ל־0, הגדול ביותר ל־1, והשאר נפרסים ביניהם באופן יחסי.
Z-normalization: מחסרים את הממוצע ומחלקים בסטיית התקן. כך הממוצע של הערכים המנורמלים הוא 0, ורובם נופלים בתחום שבין −3 ל־3. שיטה זו אינה מגבילה את הערכים לתחום 0–1, אך היא רגישה פחות לערך חריג יחיד שמותח את הטווח.
נכתוב את שתי השיטות כפונקציות שמקבלות את הנתונים ואת המדדים (מינימום ומקסימום, או ממוצע וסטיית תקן) כפרמטרים נפרדים. הסיבה תתברר בסוף הפרק: נצטרך את אותם מדדים גם בעת החיזוי.
def Normalize_minMax(X, x_max, x_min):
    return (X - x_min) / (x_max - x_min)

def Normalize_z(X, mean, std):
    return (X - mean) / std
יישום הנרמול
נחזור לנתוני הדירות וניישם עליהם את השיטה הראשונה. ניצור שוב את הטנסורים מהנתונים המקוריים וננרמל את השטח באמצעות Min–Max. המחיר נשאר במיליוני שקלים, מפני שערכיו כבר קטנים ואין צורך לנרמל אותם:
X = torch.from_numpy(X_np.astype(np.float32)).reshape(-1, 1)
Y = torch.from_numpy(P_np.astype(np.float32)).reshape(-1, 1)

x_max = X.max()
x_min = X.min()
X = Normalize_minMax(X, x_max, x_min)
print(X)
פלט
tensor([[0.0000],
        [0.2000],
        [0.3000],
        [0.4000],
        [0.5000],
        [0.6000],
        [0.8000],
        [0.8600],
        [1.0000]])
הדירה הקטנה ביותר, 90 מ"ר, קיבלה את הערך 0; הגדולה ביותר, 140 מ"ר, קיבלה 1; ודירה של 115 מ"ר, בדיוק באמצע הטווח, קיבלה 0.5. היחסים בין הדירות נשמרו, אך כל הקלט נמצא עכשיו באותו סדר גודל של המחירים.
נאתחל את המודל ואת האופטימייזר ונריץ שוב את לולאת האימון, על X המנורמל. שימו לב שחזרנו ל־SGD ולקצב הלמידה הרגיל 0.1, בלי שום התאמה מיוחדת:
learning_rate = 0.1
epochs = 1000
losses = []
Model = nn.Linear(1, 1, bias=True)
Loss = nn.MSELoss()
optim = torch.optim.SGD(Model.parameters(), lr=learning_rate)
הצגת התוצאה
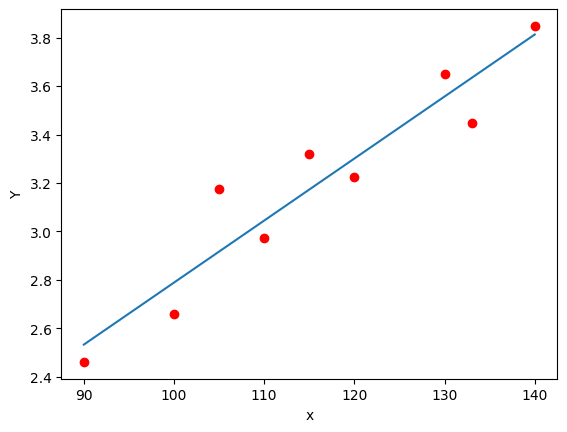
הפעם האימון מתכנס בקלות, בלי התבדרות ובלי קצב למידה מיוחד. נציג את הקו שנלמד מול שטחי הדירות המקוריים. המודל מקבל את X המנורמל, אך על ציר האופקי נצייר את השטחים המקוריים X_np, כדי שהגרף יהיה קריא במטרים:
print(f"END: loss={loss.item():.4f}")
plt.scatter(X_np, P_np, color='red')
plt.xlabel("Area in square metres")
plt.ylabel("Price in millions")

with torch.no_grad():
    predicted = Model(X).detach().numpy()
    plt.plot(X_np, predicted)

plt.show()
דוגמה לפלט סיום של מודל מאומן:
פלט
END: loss=0.0185
חיזוי וקריאת הפרמטרים
כעת נשתמש במודל למטרה שלשמה אימנו אותו: הערכת מחיר של דירה. כאן מסתתרת מלכודת נפוצה. המודל למד על ערכים בתחום 0–1, ואם נזין לו שטח של 110 כמו שהוא, הוא יתייחס אליו כאל דירה גדולה פי מאה מהגדולה ביותר שראה, ויחזיר מחיר חסר משמעות. גם שטח של דירה חדשה חייב לעבור את אותו נרמול, עם המינימום והמקסימום ששימשו באימון — ולא עם ערכים שמחושבים מחדש מהנתונים החדשים:
test = torch.tensor([[110.0]])
test = Normalize_minMax(test, x_max, x_min)
with torch.no_grad():
    print(Model(test).item())
דירה של 110 מ"ר אינה ברשימת האימון, ובכל זאת קיבלנו עבורה הערכת מחיר — זו ההכללה שלשמה בנינו את המודל. נציג את הפרמטרים שנלמדו:
for name, param in Model.named_parameters():
    print(name, param)
דוגמה לפלט:
פלט
weight Parameter containing:
tensor([[1.2791]], requires_grad=True)
bias Parameter containing:
tensor([2.5335], requires_grad=True)
שימו לב שהפרמטרים מתייחסים לקלט המנורמל: ההטיה 2.53 היא בקירוב מחיר הדירה הקטנה ביותר (X מנורמל = 0), והמשקל 1.28 הוא תוספת המחיר, במיליוני שקלים, ממנה ועד הדירה הגדולה ביותר (X מנורמל = 1). כדי לפרש את המשקל במונחי "מחיר למטר" צריך לחלק אותו בטווח השטחים, 50 מ"ר.
הנוסחה שנלמדה — הפונקציה price
נסכם את מה שהמודל למד בנוסחה אחת. המודל מחשב price = w·x_norm + b, ו־x_norm הוא השטח אחרי הנרמול, (area − 90) / (140 − 90). אם נציב את הפרמטרים מהדוגמה נקבל את נוסחת מחיר הדירה, במיליוני שקלים, כתלות בשטח במטרים:
price(area) = 1.2791 × (area − 90) / 50 + 2.5335
נכתוב את הנוסחה כפונקציית פייתון. הפרמטרים נקראים מהמודל המאומן, והמינימום והמקסימום הם אלה ששימשו באימון, כך שהנרמול נעשה בתוך הפונקציה ואי אפשר לשכוח אותו:
w = Model.weight.item()
b = Model.bias.item()

def price(area):
    x_norm = (area - x_min.item()) / (x_max.item() - x_min.item())
    return w * x_norm + b

print(f"{price(110):.3f}")
עם הפרמטרים מהדוגמה:
פלט
3.045
הפונקציה מחזירה לדירה של 110 מ"ר את אותו מחיר שקיבלנו מהמודל, כ־3.05 מיליון שקלים, ואפשר להציב בה כל שטח. אפשר גם לקרוא ממנה את "המחיר למטר": 1.2791 / 50 ≈ 0.0256 מיליון שקלים, כלומר כ־25,600 שקלים למטר, קרוב מאוד ל־25.5 שבשורת ההערה שממנה נוצרו המחירים.
המודל מתייחס בשלב זה רק לשטח הדירה. בפרק הבא נוסיף את הקומה ונעבור לרגרסיה במספר משתנים.