ג.17 רשת באמצעות מחלקה וסיווג
עד כה המודל החזיר ערך מספרי או תשובה בינארית. בזיהוי הספרה 7 שאלנו "האם זו 7?", ובפרק הקודם "האם זו שמלה?" ו"האם זו ספרה?". אבל השאלה הטבעית על תמונה של ספרה אינה שאלת כן/לא אלא "איזו ספרה זו?" — ויש לה עשר תשובות אפשריות. כך גם בעולם האמיתי: אפליקציה שמזהה פרחים צריכה לבחור מבין מאות מינים, ומערכת שממיינת דוא"ל בוחרת תיקייה מבין כמה. זהו סיווג רב־קטגוריות — Multi-class Classification: לכל דוגמה יש תשובה נכונה אחת, הנבחרת מתוך כמה אפשרויות.
הרעיון הכללי של הפתרון פשוט: במקום נוירון פלט אחד, ניתן לרשת נוירון פלט לכל קטגוריה. כל נוירון מחזיר "ציון" שמבטא עד כמה הקלט מתאים לקטגוריה שלו, והתשובה של הרשת היא הקטגוריה בעלת הציון הגבוה ביותר. כדי לאמן רשת כזו צריך שני כלים חדשים: דרך להפוך את הציונים להסתברויות — Softmax — ופונקציית הפסד שמשווה את ההסתברויות לתשובה הנכונה — Cross Entropy. שאר התהליך, מהכנת הנתונים ועד לולאת האימון, נשאר כפי שהכרנו.
בפרק זה נכיר תחילה את שני הכלים האלה, ואז נבנה רשת שמסווגת תמונת MNIST לאחת מעשר הספרות 0–9. בדרך נלמד גם דרך שנייה להגדיר רשת ב־PyTorch: באמצעות מחלקה במקום nn.Sequential. הדרך הזו גמישה יותר, והיא הדרך המקובלת ברשתות מורכבות.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 9. רשת נורונים באמצעות מחלקה (עותק מקומי) · מחברת התרגול (עותק מקומי)
Softmax
בסיווג לכמה קבוצות, לכל קבוצה יש נוירון פלט. נרצה שהערך המתאים לקבוצה הנכונה יהיה גבוה מהערכים האחרים. אבל הציונים שהשכבה הלינארית האחרונה מחזירה הם מספרים כלשהם — חיוביים או שליליים, גדולים או קטנים — וקשה לפרש אותם ולהשוות ביניהם. בסיווג בינארי פתרנו זאת בעזרת Sigmoid, שהפכה מספר אחד להסתברות בין 0 ל־1. Softmax היא ההכללה של Sigmoid לכמה פלטים: היא הופכת את ציוני הפלט להסתברויות שסכומן 1, כך שכל ערך מבטא את "הביטחון" של הרשת בקטגוריה המתאימה, וסדר הציונים נשמר — הציון הגבוה ביותר הופך להסתברות הגבוהה ביותר.
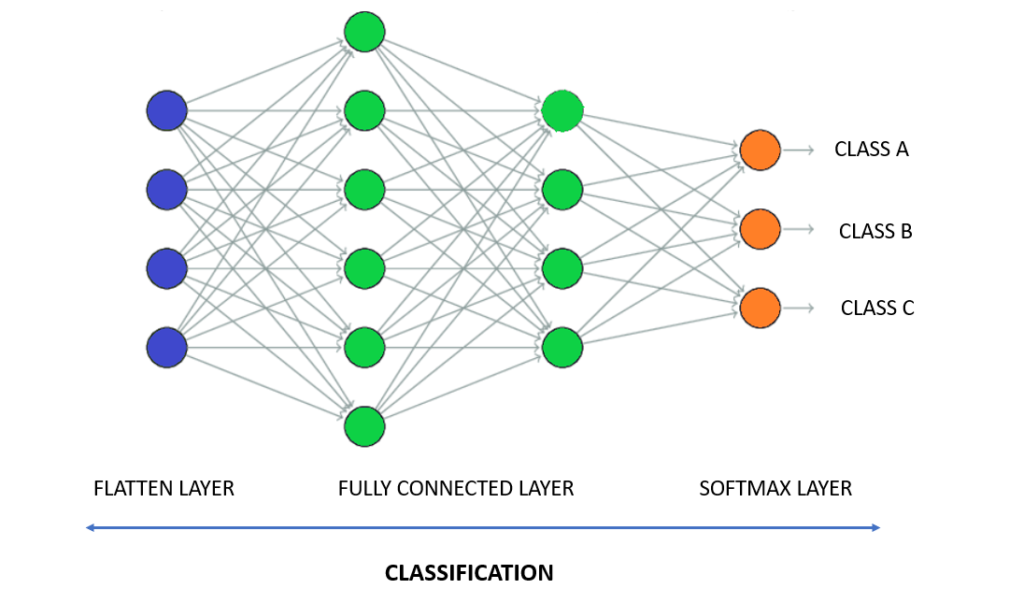
החישוב לכל ציון z_i מתוך K הציונים הוא:
$$ Softmax(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{K} e^{z_j}} $$
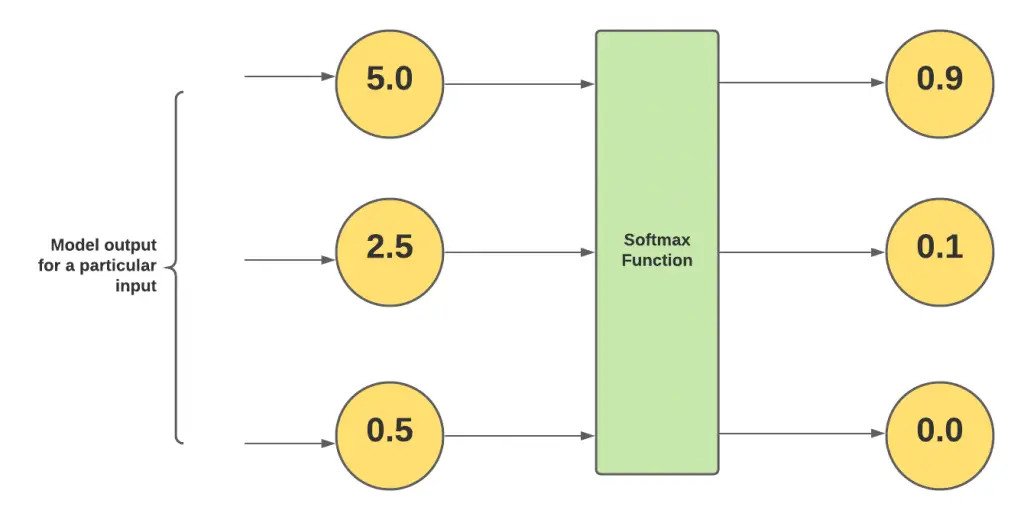
מעלים כל ציון בחזקת e, וכך כל הערכים הופכים לחיוביים, ומחלקים בסכום כדי שהתוצאות יסתכמו ל־1. מכיוון שהפונקציה המעריכית גדלה מהר, פערים קטנים בין הציונים הופכים לפערים גדולים בהסתברויות. לדוגמה, הציונים [5.0, 2.5, 0.5] נותנים בקירוב, לאחר עיגול לספרה אחת, [0.9, 0.1, 0.0]:
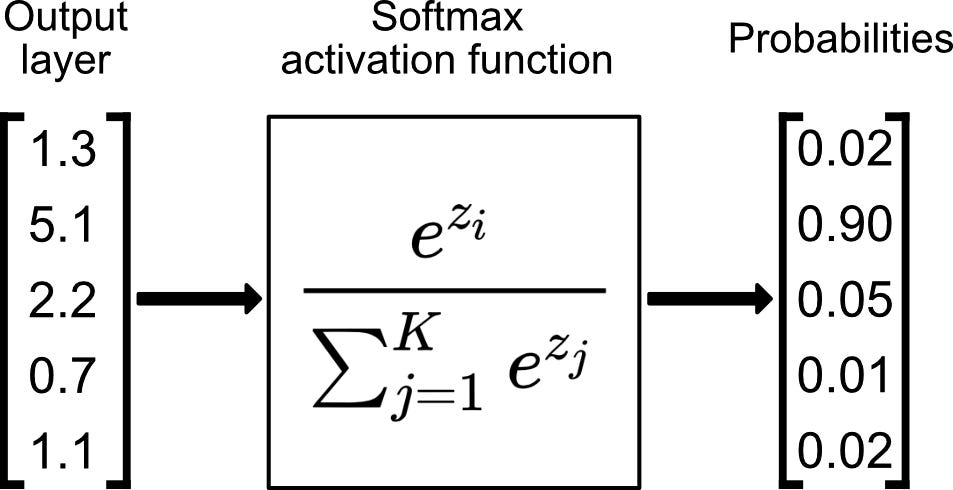
שתי דוגמאות נוספות, בערכים מעוגלים:
| ציוני הפלט | הסתברויות אחרי Softmax |
|---|---|
[1.3, 5.1, 2.2, 0.7, 1.1] |
[0.02, 0.90, 0.05, 0.01, 0.02] |
[5, 6, 11, 7] |
[0.00, 0.01, 0.97, 0.02] |
בשתי הדוגמאות הקטגוריה בעלת הציון הגבוה ביותר מקבלת כמעט את כל ההסתברות, והאחרות נשארות עם מעט. כדי לדעת מה הרשת "בחרה" מספיק לאתר את המקום של הערך הגבוה ביותר.
Cross Entropy
אחרי שיש בידינו הסתברויות, נותר להגדיר כיצד מודדים את הטעות של הרשת. Cross Entropy היא פונקציית ההפסד לסיווג לכמה קטגוריות, והרעיון שלה פשוט מאוד: מסתכלים רק על ההסתברות p שהרשת נתנה לקטגוריה הנכונה, ומחשבים:
$$ loss = -\log(p) $$
זו בדיוק הפונקציה שהכרנו בפרק ג.13, כשלמדנו את Binary Cross Entropy: שם, כאשר התשובה האמיתית הייתה 1, נשאר מהנוסחה רק האיבר −log(p). Cross Entropy היא ההכללה של BCE לכמה קטגוריות, ולכן גם הגרף שלה הוא אותו גרף:
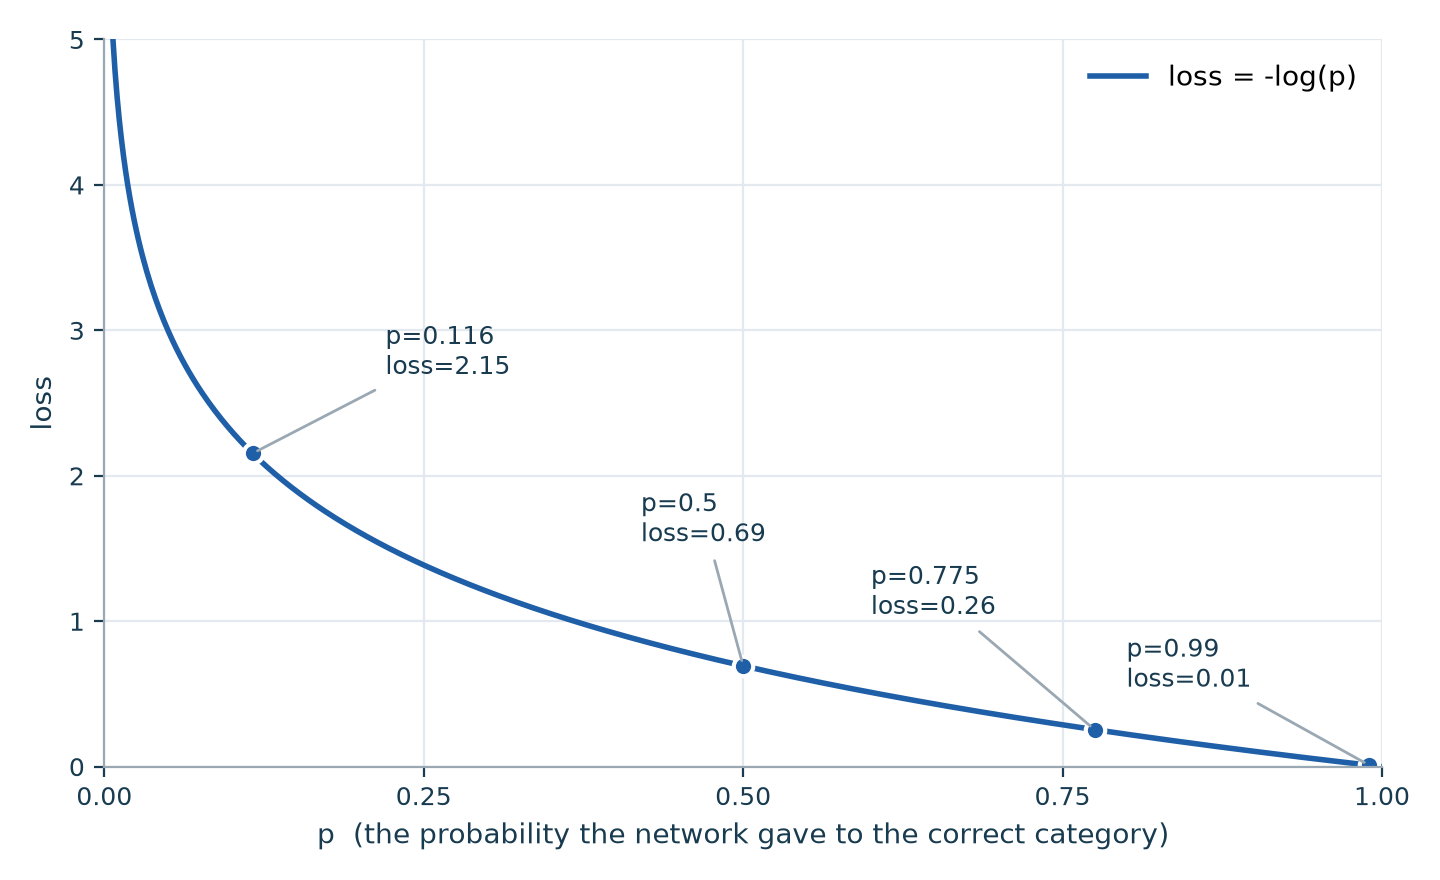
מהגרף רואים את ההתנהגות הרצויה: אם הרשת נתנה לקטגוריה הנכונה הסתברות קרובה ל־1, ההפסד קרוב לאפס. ככל שההסתברות הזו קטנה, ההפסד גדל, ובקרבת אפס הוא מזנק: רשת שהייתה "בטוחה" בתשובה שגויה נענשת בחומרה.
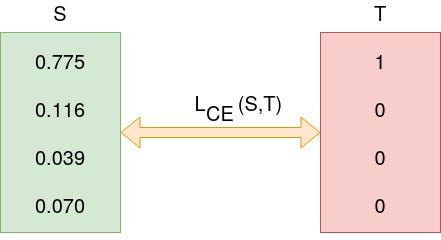
שימו לב מה לא מופיע בנוסחה: ההסתברויות של הקטגוריות הלא נכונות. Cross Entropy מתעלמת מהן לחלוטין. אין בכך אובדן מידע, כי ההסתברויות מסתכמות ל־1: אם הקטגוריה הנכונה קיבלה 0.775, השאר חולקות ביניהן את 0.225 שנותרו, ולא משנה איך. הדרך היחידה להקטין את ההפסד היא להעלות את ההסתברות של הקטגוריה הנכונה.
דוגמה מספרית. נניח שיש ארבע קטגוריות, הרשת החזירה את ההסתברויות [0.775, 0.116, 0.039, 0.070], והתשובה הנכונה היא הקטגוריה הראשונה. ההסתברות לקטגוריה הנכונה היא 0.775, ולכן:
$$ loss = -\log(0.775) = 0.255 $$
אילו הרשת הייתה טועה ונותנת לקטגוריה הראשונה רק 0.116, ההפסד היה −log(0.116) = 2.154, פי שמונה יותר. ואילו הייתה בטוחה ונותנת לה 0.99, ההפסד היה −log(0.99) = 0.01. כמו ב־BCE, את ההפסד מחשבים לכל דוגמה בנפרד ולוקחים את הממוצע על כל הדוגמאות באצווה.
הכנת נתוני MNIST
נחזור למאגר MNIST שהכרנו בפרק ג.15, והפעם נשמור את תוויות הספרות עצמן, ולא נהפוך אותן לתשובת כן/לא. הכנת הנתונים זהה לזו שראינו, ולכן נעבור עליה בקצרה. נתקדם דרך הכנת הנתונים, הגדרת הרשת וההפסד, אימון ובדיקת התוצאות.
תחילה נייבא את הספריות. חדש כאן הוא torch.nn.functional, המיובא בקיצור F: הוא מכיל את פונקציות האקטיבציה כפונקציות רגילות (למשל F.relu) במקום כשכבות, ונשתמש בו בהגדרת המחלקה:
import torch
import torch.nn as nn
import torch.nn.functional as F
import numpy as np
import matplotlib.pyplot as plt
import torchvision
import torchvision.transforms as transforms
נבחר את התקן החישוב:
if torch.cuda.is_available():
    device = torch.device('cuda')
else:
    device = torch.device('cpu')
נטען את קבוצות האימון והבדיקה וניצור אצוות של 50 תמונות, בדיוק כמו בפרק ג.15:
batch_size = 50

train_dataset = torchvision.datasets.MNIST(root='./data',
                                           train=True,
                                           transform=transforms.ToTensor(),
                                           download=True)

test_dataset = torchvision.datasets.MNIST(root='./data',
                                          train=False,
                                          transform=transforms.ToTensor())

# Data loader
train_loader = torch.utils.data.DataLoader(dataset=train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True)

test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle=False)
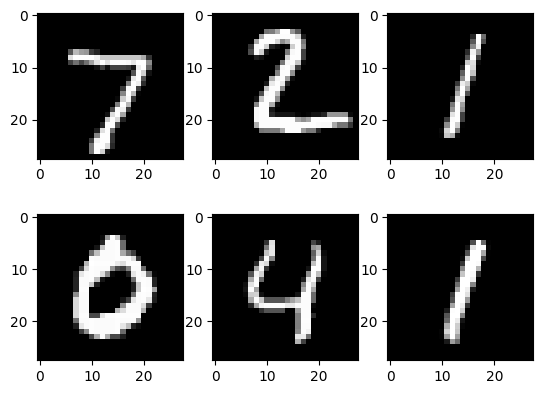
נציג שש תמונות מאצוות הבדיקה הראשונה ואת התוויות שלהן. שימו לב שהתוויות הן הספרות עצמן, 0–9, וכך הן יישארו לאורך כל הפרק:
examples = iter(test_loader)
example_data, example_targets = next(examples)

for i in range(6):
    plt.subplot(2,3,i+1)
    plt.imshow(example_data[i][0], cmap='gray')
    print(example_targets[i].item(),end = " ")
plt.show()
פלט
7 2 1 0 4 1
פרמטרים ומחלקת הרשת
כל תמונה מכילה 28×28 פיקסלים, כלומר 784 ערכי קלט. החידוש הוא הפרמטר num_classes: מספר הקטגוריות, שיהיה גם מספר נוירוני הפלט. נגדיר עשר קטגוריות, חמישה אפוקים וקצב למידה 0.01. כמו בפרק ג.14, נקבע זרע אקראי כדי שההרצה שלכם תיתן את המספרים שבספר (ההרצה כאן נעשתה על GPU; על CPU התוצאות עשויות להיות שונות מעט):
torch.manual_seed(0)   # same initial weights on every run
input_size = 784 # 28x28
hidden_size = 200
num_classes = 10
epochs = 5
learning_rate = 0.01
# losses = torch.zeros(epochs*len(train_loader)//10)
עד כה הגדרנו רשתות באמצעות nn.Sequential, שמעבירה את הנתונים משכבה לשכבה בסדר קבוע. זה נוח, אך מגביל: אי אפשר, למשל, לפצל את הנתונים לשני מסלולים או להפעיל תנאי בדרך. הדרך הכללית ב־PyTorch היא לכתוב מחלקה משלנו.
המחלקה ANN_Model יורשת מ־nn.Module, מחלקת הבסיס של כל המודלים ב־PyTorch. בזכות הירושה היא מקבלת את כל היכולות שהכרנו: parameters(), .to(device) והקריאה למודל כפונקציה.
במחלקה שתי שיטות דרושות:
__init__— הבנאי. תחילה מאתחלים את מחלקת הבסיס בקריאהsuper().__init__(), ואז מגדירים את השכבות כשדות של האובייקט:linear1,linear2ו־linear3.forward— מעבר הנתונים. כאן כותבים בעצמנו, שורה אחרי שורה, את מה ש־nn.Sequentialעשתה בשבילנו: הקלט עובר בשכבה הראשונה, אחריה ReLU, בשכבה השנייה, שוב ReLU, ולבסוף בשכבת הפלט.
הרשת שנבנה כוללת שתי שכבות נסתרות, בגודל 200 ו־100, ושכבת פלט בת עשרה נוירונים, נוירון לכל ספרה. הגרסה השקולה ב־nn.Sequential מופיעה בהערה בתחילת הקוד, לצורך השוואה.
# Model = nn.Sequential(
#     nn.Linear(input_size,hidden_size,device=device),
#     nn.ReLU(),
#     nn.Linear(hidden_size, num_classes, device=device),
# )

class ANN_Model(nn.Module):
    def __init__(self):
        super().__init__()
        self.linear1 = nn.Linear(input_size,hidden_size)
        self.linear2 = nn.Linear(hidden_size,100)
        self.linear3 = nn.Linear(100, num_classes)

    def forward(self, x):
        x = self.linear1(x)
        x = F.relu(x)         # torch.nn.functional as F
        x = self.linear2(x)
        x = F.relu(x)
        x = self.linear3(x)
        return x

Model = ANN_Model().to(device)
הקריאה Model(images) מפעילה את מעבר הנתונים שהוגדר ב־forward; איננו קוראים ל־forward ישירות. אחרי שתי השכבות הראשונות מופעלת ReLU; השכבה האחרונה מחזירה עשרה ציונים גולמיים לכל תמונה, ללא Softmax. הסיבה לכך מוסברת בסעיף הבא. שימו לב גם ש־.to(device) מועבר הפעם על המודל כולו, בשורה האחרונה, ולא על כל שכבה בנפרד.
פונקציית הפסד ואופטימייזר
כאן נפגשים שני הכלים שהכרנו בתחילת הפרק. ב־PyTorch, nn.CrossEntropyLoss כוללת את חישוב LogSoftmax ו־NLLLoss — כלומר היא מפעילה בעצמה את Softmax על הציונים ואז מחשבת את Cross Entropy — ולכן אין להוסיף Softmax בסוף הרשת; אם נוסיף, Softmax יופעל פעמיים והאימון ייפגע. נוחות נוספת: אין צורך להכין את התוויות בשום צורה מיוחדת. נעביר אליה את ציוני הרשת ואת מספרי הספרות כפי שהם, והיא תדע לפרש את המספר 3 כ"הקטגוריה השלישית". נשתמש ב־Adam לעדכון המשקלים.
Loss = nn.CrossEntropyLoss () # applies nn.LogSoftmax + nn.NLLLoss, No softmax in last layer

# init optimizer
# optim = torch.optim.SGD(Model.parameters(), lr=learning_rate,momentum=0.9)
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון הרשת
לולאת האימון כמעט זהה לזו של הסיווג הבינארי. בכל אצווה נפרוש את התמונות לשורות של 784 ערכים ונעביר אותן ואת התוויות להתקן. ההבדל היחיד הוא בטיפול בתוויות: בפרקים הקודמים המרנו אותן ל־0/1 וסידרנו בעמודה, ואילו כאן הן נשארות וקטור של 50 ספרות, כפי ש־CrossEntropyLoss מצפה. לאחר החישוב קדימה נחשב הפסד ונגזרות, נעדכן את המשקלים ונאפס את הגרדיאנטים.
n_total_steps = len(train_loader)

for epoch in range(epochs):
    for i, (images, lables) in enumerate(train_loader):

        # origin shape: [50, 1, 28, 28]
        # resized: [50, 784]
        images = images.reshape(-1, 28*28).to(device)
        lables = lables.to(device)    #no reshape for CrossEntropyLoss

        # forward
        Y_predict = Model(images)

        # backward
        loss = Loss(Y_predict, lables)
        loss.backward()

        # update wights
        optim.step()

        if i % 100 == 0:
            print(f"epoch= {epoch} i= {i+epoch * n_total_steps} loss={loss.item():.4f} ")

        # zero grads
        optim.zero_grad()
תחילת פלט ההרצה וסופו, בדילוג על שורות הביניים:
פלט
epoch= 0 i= 0 loss=2.2990
epoch= 0 i= 100 loss=0.3536
epoch= 0 i= 200 loss=0.6079
...
epoch= 4 i= 5800 loss=0.6306
epoch= 4 i= 5900 loss=0.2661
ההפסד המודפס שייך לאצווה הנוכחית, ולא לממוצע של האפוק. ההפסד ההתחלתי, 2.2990, הוא בערך מה שמצפים מרשת שעדיין אינה יודעת דבר ומחלקת את ההסתברות באופן שווה בין עשר ספרות: Cross Entropy במקרה כזה היא ln 10, כ־2.3. כבר אחרי 100 אצוות ההפסד יורד לכ־0.35, ובהמשך הוא מתנדנד בין אצווה לאצווה: יש אצוות "קלות" עם הפסד קרוב לאפס ואצוות "קשות" עם הפסד של 0.6, גם באפוק החמישי. זה טבעי כשמודדים הפסד על 50 תמונות בלבד בכל פעם, ולכן את איכות הרשת נבדוק מיד על כל 10,000 תמונות הבדיקה.
פירוש פלט הרשת
בסיווג בינארי עיגלנו את פלט הרשת כדי לקבל תשובה; כאן הפלט הוא עשרה מספרים לכל תמונה, ונצטרך דרך אחרת לחלץ ממנו תשובה. נבחן את Y_predict שנשאר מאצוות האימון האחרונה. לכל תמונה עשרה ציונים; torch.max(Y_predict, 1) מחזירה שני טנסורים: את הציון המרבי בכל שורה (הפרמטר 1 מציין חיפוש לאורך השורה, כלומר בין עשרת הציונים של אותה תמונה) ואת מיקומו, שהוא הספרה החזויה. אין צורך להפעיל Softmax לשם כך: Softmax שומרת על סדר הציונים, ולכן המקום של הציון הגבוה ביותר הוא גם המקום של ההסתברות הגבוהה ביותר. נדפיס את הציונים, את המקסימום, את המיקומים ואת התוויות האמיתיות לצורך השוואה:
print(f"epoch= {epoch} i= {i+epoch * n_total_steps} loss={loss.item():.4f}")
print(Y_predict)
v, i = torch.max(Y_predict,1)
print (v)
print ('max index: \n', i)
print('Labels: \n', lables)
שלוש השורות הראשונות של Y_predict, ועשרת הערכים הראשונים מכל אחד מהטנסורים הבאים:
פלט
epoch= 4 i= 5999 loss=0.1683
tensor([[-16.3961,   3.1881,  -2.5105,   0.4105,  -4.7684, -10.9531, -22.8867,   6.9665,  -1.9956,  -1.3484],
        [ -8.6753,  -6.0872,  -4.7047,  -0.9392,  -0.8521,  -1.2668, -12.0945,   0.4688,  -0.7312,   5.2434],
        [ 13.9811, -31.2211,  -1.4041,   0.4586, -10.2911, -18.4572, -21.3297, -22.0446,  -5.8702,  -6.0315]],
       device='cuda:0', grad_fn=<SliceBackward0>)
tensor([ 6.9665,  5.2434, 13.9811,  8.5569, 13.6774,  8.4491, 10.4824, 11.7859, 12.5762, 19.8252], device='cuda:0')
max index:
 tensor([7, 9, 0, 7, 1, 5, 3, 0, 5, 4], device='cuda:0')
Labels:
 tensor([7, 9, 0, 7, 1, 5, 3, 0, 5, 4], device='cuda:0')
נקרא את השורה הראשונה: עשרה ציונים, אחד לכל ספרה מ־0 עד 9. הציון הגבוה ביותר הוא 6.9665, במקום מספר 7, ולכן הרשת "אומרת" 7 — וזו אכן התווית. בשורה השנייה הציון הגבוה, 5.2434, נמצא במקום 9, ובשלישית 13.9811 במקום 0. שימו לב שהציונים אינם הסתברויות: יש בהם מספרים שליליים גדולים (למשל −31.2), והם אינם מסתכמים ל־1. Softmax הייתה הופכת אותם להסתברויות, אך לבחירת הספרה מספיק המקום של הציון הגבוה, וזה מה ש־torch.max מחזירה. בעשר התמונות הראשונות של האצווה כל התחזיות תואמות לתוויות.
בדיקת הדיוק
כעת נעבור על קבוצת הבדיקה, נבחר לכל תמונה את הספרה בעלת הציון המרבי באותה דרך, ונמנה כמה תחזיות תואמות לתוויות. את ערך המקסימום עצמו אין לנו צורך לשמור, ולכן הוא נקלט במשתנה __:
with torch.no_grad():
    n_correct = 0
    n_samples = 0
    for images, lables in test_loader:
        images = images.reshape(-1, 28*28).to(device)
        lables = lables.to(device)
        Y_predict = Model(images)
        __,y_predict_arg = torch.max(Y_predict,1)
        n_samples += lables.size(0)
        n_correct += (y_predict_arg == lables).sum().item()

    acc = 100 * n_correct / n_samples
    print(f'Accuracy of the network on the {n_samples} test images: {acc} %')
תוצאת ההרצה:
פלט
Accuracy of the network on the 10000 test images: 95.41 %
הרשת זיהתה נכון 9,541 מתוך 10,000 תמונות שלא ראתה מעולם באימון, כלומר כ־95 מתוך כל 100. שימו לב שזו משימה קשה יותר מזו של פרק ג.15: שם היו רק שתי תשובות אפשריות, וכאן עשר. זו תוצאה טובה לרשת פשוטה, אך היא גם מראה שנותרו טעויות; בפרק על רשתות קונבולוציה נראה מבנה רשת שמתאים יותר לתמונות ומשפר את הדיוק.
הצגת התחזיות
נציג תמונות לצד התחזיות כדי לראות כיצד החלטות הרשת מתאימות לתוכן התמונה. ניצור איטרטור חדש של קבוצת הבדיקה:
examples = iter(test_loader)
ניקח אצווה, נחשב את הספרה החזויה לכל תמונה ונדפיס אותה לצד התווית:
example_data, example_targets = next(examples)
example_data = example_data.to(device)
example_targets = example_targets.to(device)
example_predict_value, example_predict_arg = torch.max(Model(example_data.reshape(-1, 28*28)),1)
# print(example_predict_arg)
for i in range(len(example_data)):
    print ("Predict: ",example_predict_arg[i].item(), "target Label: ",example_targets[i].item() )
עשר השורות הראשונות מתוך 50:
פלט
Predict:  7 target Label:  7
Predict:  2 target Label:  2
Predict:  1 target Label:  1
Predict:  0 target Label:  0
Predict:  4 target Label:  4
Predict:  1 target Label:  1
Predict:  4 target Label:  4
Predict:  9 target Label:  9
Predict:  5 target Label:  5
Predict:  9 target Label:  9
נציג 25 תמונות מהאצווה, עם הספרה החזויה בכותרת כל תמונה:
plt.figure(figsize=(8, 6))
for i in range(25):
    subplot = plt.subplot(5,5,i+1)
    plt.imshow(example_data[i][0].to('cpu'), cmap='gray')
    subplot.set_title (example_predict_arg[i].item())
    print(f'target: {example_targets[i].item()} predicted: {example_predict_arg[i].item()}',end = " ")

plt.tight_layout()

plt.show()
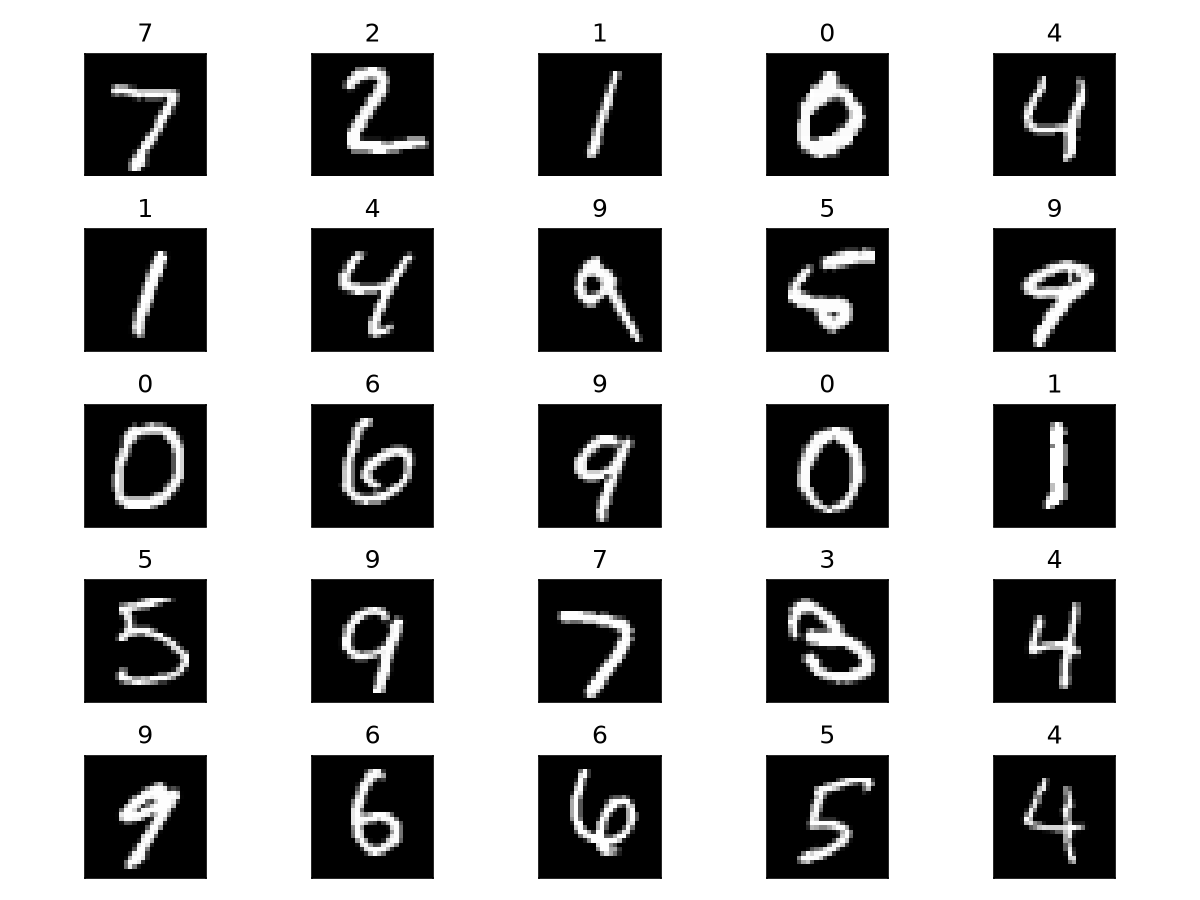
באצווה הזו הרשת צדקה בכל 25 התמונות, אף שהספרות כתובות בסגנונות שונים: יש 4 עם קו עליון פתוח ו־4 סגור, 9 זקוף ו־9 נטוי, 6 עגול ו־6 מוארך. עם דיוק של 95.41% מצפים לטעות אחת בערך בכל 22 תמונות, ולכן אצווה ללא טעות אינה מפתיעה; באצוות אחרות נמצא ספרות שהרשת מתבלבלת בהן, בדרך כלל כתב יד מרושל או ספרות דומות כמו 4 ו־9. את המחברת אפשר להריץ ולעבור לאצווה הבאה בעזרת next(examples) כדי לחפש טעויות כאלה.