ג.8 רגרסיה לינארית — כמה נקודות
בפרק הקודם הישר נדרש להגיע לנקודה אחת, ולכן תמיד היה פתרון מושלם: הטעות ירדה לאפס. במציאות, כמו בדוגמת המכירות של החנות, אוספים נקודות רבות, ובגלל הרעש האקראי שבכל מדידה הן אינן מסודרות על קו אחד. שום ישר לא יעבור בכל הנקודות, ובכל זאת אנו מחפשים ישר יחיד שמתאר את כולן "הכי טוב שאפשר": כזה שהטעויות שלו, על כל הנקודות יחד, קטנות ככל האפשר.
המודל נשאר אותו מודל, הישר y = w·x עם משקל אחד, וגם האלגוריתם והלולאה נשארים כפי שלמדנו בפרק ג.7. הדבר היחיד שצריך לחשוב עליו מחדש הוא פונקציית הטעות: כשיש כמה נקודות יש כמה טעויות, ונחוץ מספר אחד שמסכם את כולן. זה הנושא של פרק זה.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: 5. רגרסיה לינארית (עותק מקומי) · מחברת רגרסיה לינארית (עותק מקומי)
רגרסיה בארבע נקודות
נתונות לנו ארבע נקודות:
$$ X = 0,\ 1,\ 2,\ 3 \qquad Y = 0.7576,\ 2.2793,\ 4.4031,\ 6.7347 $$
עלינו למצוא את נוסחת הקו הישר, המתחיל בראשית הצירים, שמתאר בצורה הטובה ביותר את הנקודות הללו. ידוע לנו שנוסחת הישר היא y = w·x, ולכן, בדיוק כמו בפרק הקודם, אנחנו מחפשים מספר אחד: את המשקל w. מבט בנתונים מגלה ש־y גדל בערך פי 2 מ־x, אבל לא בדיוק: לכל נקודה נוסף מספר אקראי קטן, ולכן שום ישר לא יעבור בכל הארבע.
הטעות של כל נקודה
נבחר ניחוש שרירותי, w = 1, ונצייר את הישר y = 1·x יחד עם הנקודות. בפרק הקודם היה חץ אחד בין הישר לנקודה; עכשיו יש ארבעה חצים, אחד לכל נקודה, כי לכל נקודה יש טעות משלה:
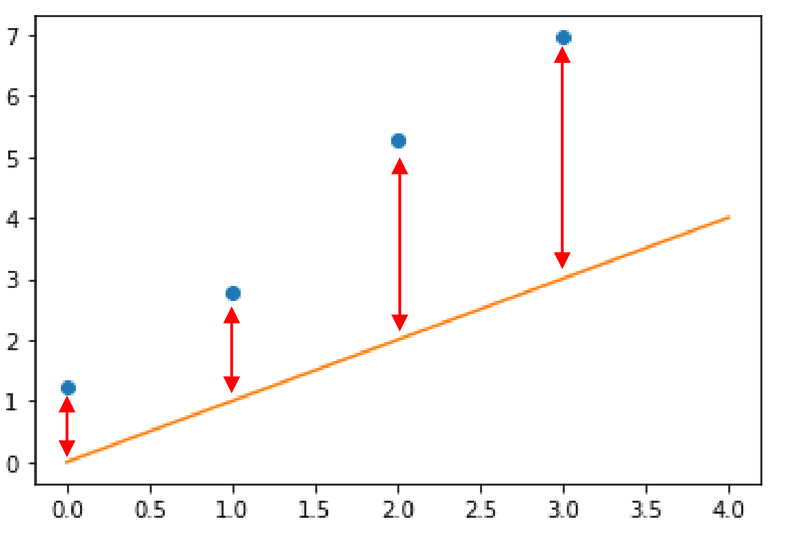
נחשב את הטעויות עם הנתונים שלנו. עבור w = 1 הישר מנבא y_predict = 0, 1, 2, 3, והערכים האמיתיים הם 0.7576, 2.2793, 4.4031, 6.7347. הטעות של כל נקודה, y_predict − y, היא בהתאמה −0.76, −1.28, −2.40, −3.73: הישר נמוך מדי בכל הנקודות, ויותר ויותר ככל ש־x גדל. כמו בפרק הקודם נעלה כל טעות בריבוע, כדי שתהיה מספר חיובי, ונקבל 0.57, 1.64, 5.77, 13.95.
ממוצע הטעויות — MSE
יש לנו עכשיו ארבעה מספרים, אבל Gradient Descent יודע למזער פונקציה שמחזירה מספר אחד. איך מאחדים ארבע טעויות למספר אחד? מחשבים את הממוצע שלהן: מסכמים את ריבועי הטעויות של כל הנקודות ומחלקים במספר הנקודות. עבור הניחוש w = 1: הסכום הוא 0.57 + 1.64 + 5.77 + 13.95 = 21.93, והממוצע הוא 21.93 / 4 = 5.48. זהו ההפסד של הישר w = 1 על ארבע הנקודות יחד. פונקציית טעות זו נקראת ממוצע ריבועי השגיאות — MSE, Mean Squared Error:
$$ loss=\frac{1}{n}\sum_{i=1}^{n}(y_{predict,i}-y_i)^2=\frac{1}{n}\sum_{i=1}^{n}(w\cdot x_i-y_i)^2 $$
הסימן Σ (סיגמא) פירושו "סכום על כל הנקודות", n הוא מספר הנקודות, ו־1/n הופך את הסכום לממוצע. שימו לב שגם כאן המשתנה של הפונקציה הוא w ולא x: כל ערכי x ו־y קבועים מהנתונים, ולכל ערך של w הפונקציה מחזירה מספר אחד, הטעות הממוצעת של הישר עם המשקל הזה.
מדוע ממוצע ולא סכום? הסכום גדל ככל שאוספים יותר נקודות, גם אם הישר טוב באותה מידה; הממוצע נשאר "טעות לנקודה", ולכן אפשר להשוות בין הפסדים של קבוצות נתונים בגדלים שונים ולקרוא את המספר באותה דרך תמיד. עכשיו המשימה זהה לזו של הפרק הקודם: למצוא את w שמביא את פונקציית הטעות למינימום, באמצעות Gradient Descent.
האלגוריתם
האלגוריתם הוא זה שלמדנו בפרק ג.7, עם שני הבדלים קטנים בשלבים 2 ו־3: התחזית מחושבת לכל הנקודות בבת אחת, והטעות היא ממוצע ריבועי השגיאות של כולן.
- מתחילים מ־w שרירותי.
- מחשבים את התחזיות של הישר לכל הנקודות: y_predict = w·x עבור כל x בנתונים.
- מחשבים את הטעות הממוצעת: ריבוע הטעות של כל נקודה, ואז ממוצע על כל הנקודות (MSE).
- מחשבים את הנגזרת של ההפסד לפי w.
- מעדכנים את המשקל בכיוון ההפוך לנגזרת, ומאפסים את הנגזרת.
- חוזרים לשלב 2 עם ה־w החדש, עד שההפסד מפסיק לרדת.
הלולאה והחלוקה לחמשת חלקי התוכנית (הכנת הנתונים, בניית המודל, ההפסד והאופטימייזר, לולאת האימון, הדפסת התוצאות) נשארות כפי שהיו. ההבדל היחיד בקוד יהיה בפונקציית ההפסד.
מימוש בקוד
הקוד ממשיך את המחברת של הפרק הקודם ומשתמש באותם ייבואים:
import torch
import numpy as np
import matplotlib.pyplot as plt
הכנת הנתונים
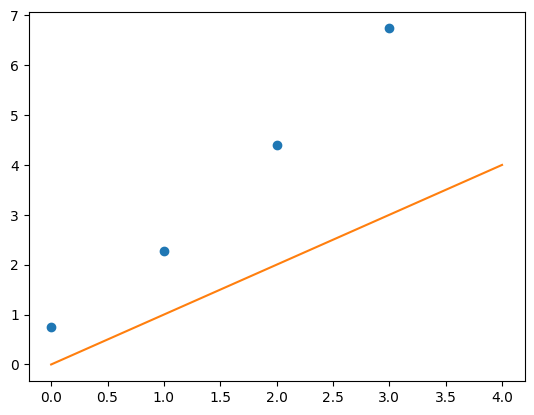
נכין את ארבע הנקודות. ערכי y מתקבלים מהכפלת x ב־2 ומהוספת מספר אקראי בין 0 ל־1 — הרעש האקראי מדמה את הגורמים שאינם בשליטתנו, כמו בדוגמת המכירות, ובגללו שום ישר לא יעבור בכל הנקודות. הפקודה torch.manual_seed(1) קובעת את המספרים האקראיים כך שנקבל אותם ערכים בכל הרצה. נצייר גם את ישר הניחוש w = 1:
torch.manual_seed(1)
X = torch.tensor([0, 1, 2, 3], dtype=torch.float32)
Y = X * 2 + torch.rand(4,)
print (Y)
plt.plot (0,0)
plt.scatter(X,Y)
plt.plot([0,4], [0,4])
פלט
tensor([0.7576, 2.2793, 4.4031, 6.7347])
גרף פונקציית ההפסד
כמו במקרה של נקודה אחת, נצייר תחילה את פונקציית הטעות הממוצעת כדי לראות מה אנו עומדים למזער. ניקח 100 משקלים בין −4 ל־9, ונחשב בלולאה, לכל משקל בנפרד, את ה־MSE שלו: W[i]*X נותן את ארבע התחזיות של הישר עם המשקל ה־i, מחסרים את Y, מעלים בריבוע ומחשבים ממוצע. כל תוצאה נשמרת במקום המתאים בטנסור loss, ובסוף מציירים את ההפסד כתלות במשקל:
W = torch.tensor(np.linspace(-4, 9, 100), dtype=torch.float32)
loss = torch.zeros(100)
for i in range(100):
    loss[i] = ((W[i]*X - Y)**2).mean()

plt.plot(W.numpy(), loss.numpy())
plt.title("Loss = ((w * x - Y)**2).mean()")
plt.ylabel("Loss")
plt.xlabel("W")
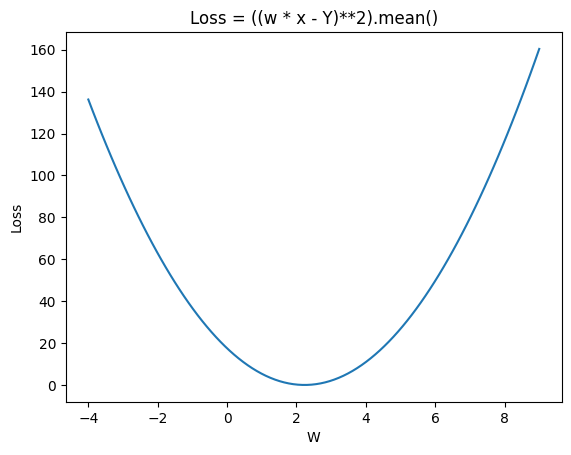
ההפסד יורד מערכים של מעל 100 בקצוות הטווח לערכים קטנים מ־1 בסביבת המשקל 2, ואז עולה שוב. גם כאן קיבלנו פרבולה עם מינימום יחיד, אך שימו לב שהמינימום אינו אפס: מכיוון שהנקודות אינן על ישר אחד, אף משקל אינו מבטל את כל הטעויות בבת אחת, והמינימום הוא הפשרה הטובה ביותר ביניהן.
בניית המודל
עד כאן רק ציירנו את ההפסד; כעת נאמן את המודל כדי שימצא את המינימום בעצמו. נעבור לחמש נקודות ונאתחל משקל חדש שערכו 8, הרחק מהפתרון. המודל הוא אותו ישר y = w·x, אלא שהפעם X הוא טנסור של חמישה ערכים, ולכן קריאה אחת ל־Model מחזירה טנסור של חמש תחזיות בבת אחת, אחת לכל נקודה:
torch.manual_seed(1)
X = torch.tensor([0, 1, 2, 3, 4], dtype=torch.float32)
Y = X * 2 + torch.rand(5,)
W = torch.tensor(8.0, requires_grad=True)
learning_rate = 0.01
print (X, Y, W)

def Model (X):
    return W * X
Y_predict = Model(X)
print (Y_predict)
פלט
tensor([0., 1., 2., 3., 4.]) tensor([0.7576, 2.2793, 4.4031, 6.7347, 8.0293]) tensor(8., requires_grad=True)
tensor([ 0.,  8., 16., 24., 32.], grad_fn=<MulBackward0>)
התחזיות ההתחלתיות (0, 8, 16, 24, 32) גדולות בהרבה מהערכים האמיתיים (כ־0.76 עד 8.03), כצפוי ממשקל 8 כשהשיפוע האמיתי הוא בערך 2. הפעם הישר גבוה מדי, ולכן הטעויות חיוביות.
בניית פונקציית ההפסד והאופטימייזר
ההבדל היחיד לעומת הפרק הקודם הוא בפונקציית ההפסד: (Y_predict - Y)**2 מחשב את ריבוע הטעות של כל אחת מחמש הנקודות, ו־.mean() מחשב את הממוצע שלהן, המספר האחד שהאלגוריתם ימזער. האופטימייזר זהה:
def Loss (Y_predict, Y):
    return ((Y_predict - Y)**2).mean() #((W * X - Y)**2).mean()

optimizer = torch.optim.SGD([W], lr=learning_rate) # W = W - W.grad * LR
לולאת האימון
לולאת האימון זהה לחלוטין לזו של הנקודה היחידה — זהו יתרון גדול של הגישה: אותו קוד עובד לנקודה אחת, לחמש נקודות ולאלפי נקודות. נבצע 200 אפוקים ונדפיס את המצב אחת לעשרה:
for epoch in range(200):

    # forward
    Y_predict = Model(X)

    # backward
    loss = Loss(Y_predict, Y)
    loss.backward()

    if epoch % 10 == 0:
        print(f"epoch= {epoch} W= {W.item():.3f} loss={loss.item():.3f} grad= {W.grad.item():.3f}")

    # Update weight
    optimizer.step()

    # zero grads
    optimizer.zero_grad()
פלט
epoch= 0 W= 8.000 loss=208.095 grad= 70.637
epoch= 10 W= 3.753 loss=16.319 grad= 19.673
epoch= 20 W= 2.570 loss=1.444 grad= 5.479
epoch= 30 W= 2.241 loss=0.291 grad= 1.526
epoch= 40 W= 2.149 loss=0.201 grad= 0.425
epoch= 50 W= 2.123 loss=0.194 grad= 0.118
epoch= 60 W= 2.116 loss=0.194 grad= 0.033
epoch= 70 W= 2.114 loss=0.194 grad= 0.009
epoch= 80 W= 2.114 loss=0.194 grad= 0.003
epoch= 90 W= 2.114 loss=0.194 grad= 0.001
epoch= 100 W= 2.114 loss=0.194 grad= 0.000
epoch= 110 W= 2.114 loss=0.194 grad= 0.000
epoch= 120 W= 2.114 loss=0.194 grad= 0.000
epoch= 130 W= 2.114 loss=0.194 grad= 0.000
epoch= 140 W= 2.114 loss=0.194 grad= 0.000
epoch= 150 W= 2.114 loss=0.194 grad= 0.000
epoch= 160 W= 2.114 loss=0.194 grad= 0.000
epoch= 170 W= 2.114 loss=0.194 grad= 0.000
epoch= 180 W= 2.114 loss=0.194 grad= 0.000
epoch= 190 W= 2.114 loss=0.194 grad= 0.000
נקרא את הפלט. בתחילת האימון ההפסד הממוצע הוא 208 והנגזרת חיובית וגדולה (70.6): הישר גבוה מדי, ולכן יש להקטין את המשקל, ובצעדים גדולים. ואכן המשקל צונח מ־8 ל־3.75 בתוך עשרה אפוקים, ול־2.24 אחרי שלושים. הנגזרת מתכווצת בהדרגה ומתאפסת, והמשקל מתייצב על 2.114, קרוב ל־2, השיפוע שממנו יצרנו את הנתונים. שימו לב להבדל מהפרק הקודם: ההפסד נעצר על 0.194 ואינו יורד לאפס. זה אינו כישלון של האלגוריתם; זהו המינימום של הפרבולה שראינו, הטעות הממוצעת הקטנה ביותר שישר דרך הראשית יכול להשיג על נקודות שאינן על קו אחד.
הדפסת התוצאות
נציג את המשקל ואת הישר שהתקבל. הבלוק with torch.no_grad() אומר ל־PyTorch שלא לעקוב אחר החישוב לצורך נגזרות, כי כאן אנו רק מציירים ולא מאמנים:
print(W)
print(f"END: W= {W.item():.3f} loss={loss.item():.3f}")
plt.scatter(X, Y, color='b')
plt.xlabel("x")
plt.ylabel("Y")
with torch.no_grad():
    plt.plot(X, Model(X), color='r')
plt.show()
פלט
tensor(2.1136, requires_grad=True)
END: W= 2.114 loss=0.194
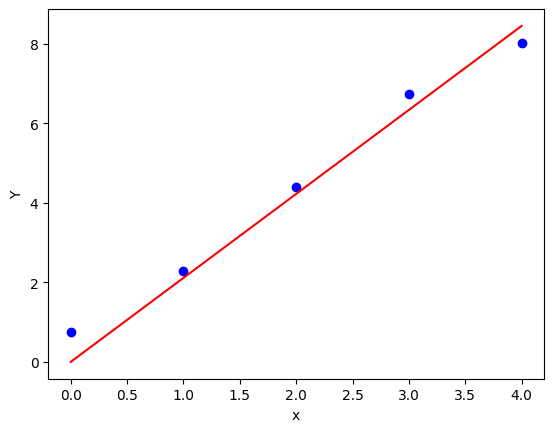
הישר אינו עובר בכל הנקודות בדיוק, אלא עובר ביניהן: מעל חלקן ומתחת לאחרות, כך שהטעות הממוצעת קטנה ככל האפשר. זה בדיוק מה שרצינו: הישר תופס את המגמה הכללית ולא את הרעש האקראי של כל נקודה. עכשיו אפשר לעשות את מה שדיברנו עליו בפתיחת הפרק הקודם — להציב בישר ערך x חדש, למשל 2.5, ולקבל הערכה סבירה ל־y, אף שמעולם לא ראינו נקודה כזו. זוהי ההכללה. בפרק הבא נראה מה קורה כשהנקודות מונחות על ישר שאינו עובר בראשית הצירים, ומה צריך להוסיף למודל כדי לתאר אותו.