ג.18 רשת באמצעות מחלקה וסיווג — דוגמאות
בפרק הקודם למדנו כיצד מסווגים לכמה קטגוריות: נוירון פלט לכל קטגוריה, Softmax שהופכת את הציונים להסתברויות, Cross Entropy שמודדת את הטעות לפי ההסתברות שניתנה לקטגוריה הנכונה, ורשת שכתובה כמחלקה. הדגמנו זאת על ספרות MNIST. פרק זה אינו מוסיף כלים חדשים: הוא רק מדגים את אותו מתכון על שני מאגרים נוספים, כדי לראות שהוא עובד גם על נתונים מטבלה וגם על תמונות מסוג אחר.
שני המאגרים מוכרים לנו מהגרסה הבינארית שלהם, והפעם נפתור בהם את השאלה המלאה. תחילה נסווג פרחי Iris לאחד משלושה מינים לפי ארבע מדידות; המאגר קטן, ואפשר להעביר בו את כל הנתונים ברשת בבת אחת. אחר כך נסווג תמונות Fashion-MNIST לאחת מעשר קטגוריות לבוש; המאגר גדול ודורש עבודה באצוות. בסוף הפרק נראה גם כיצד לקרוא לא רק את הקטגוריה שהרשת בחרה אלא גם עד כמה היא "בטוחה" בבחירתה.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: מצגת רשת נוירונים באמצעות מחלקה (עותק מקומי) · מחברת Iris ו־Fashion-MNIST (עותק מקומי)
סיווג מיני Iris
את מאגר Iris הכרנו בפרק ג.13, ושם צמצמנו את השאלה לשאלה בינארית — האם הפרח הוא מין מסוים או לא. הפעם נשאל את השאלה הטבעית: לאיזה משלושת המינים שייך הפרח? נבנה את הדוגמה הראשונה סביב ארבע המדידות של כל פרח ושלושת המינים האפשריים. נייבא את הספריות לעבודה עם הנתונים והרשת:
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
נטען את Iris ונדפיס את תיאור המאגר. יש בו 150 פרחים משלושה מינים וארבע מדידות בסנטימטרים לכל פרח: אורך ורוחב עלה הגביע ואורך ורוחב עלה הכותרת.
iris = datasets.load_iris()
data, targets = iris.data, iris.target

print(iris.DESCR)
נבדוק את שמות המינים, צורת הנתונים, חמש הדוגמאות הראשונות והתוויות:
print ("target_names",iris.target_names)
print ("X, y",data.shape, targets.shape)
print(data[0:5],'\n', targets)
פלט
target_names ['setosa' 'versicolor' 'virginica']
X, y (150, 4) (150,)
[[5.1 3.5 1.4 0.2]
 [4.9 3.  1.4 0.2]
 [4.7 3.2 1.3 0.2]
 [4.6 3.1 1.5 0.2]
 [5.  3.6 1.4 0.2]]
 [0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2 2
 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2
 2 2]
התוויות הן המספרים 0, 1 ו־2, לפי סדר שמות המינים: 0 הוא setosa, 1 הוא versicolor ו־2 הוא virginica. זה הייצוג שבו נשתמש לאורך הפרק: כל קטגוריה מקבלת מספר שלם, והרשת תצטרך ללמוד להחזיר את המספר הנכון. שימו לב שהפרחים במאגר מסודרים לפי מין, 50 מכל אחד, ולכן חשוב שהפיצול לאימון ולבדיקה יערבב אותם.
נציג את זוגות התכונות בגרפי פיזור, כדי לקבל תחושה עד כמה קל להפריד בין המינים. הצבעים מסמנים את מיני הפרחים; האלכסון נשאר ריק, מפני שאין טעם להציג תכונה מול עצמה.
fig, axes = plt.subplots(4, 4, figsize=(15, 15))
features = iris.feature_names

for i in range(4):
    for j in range(4):
        ax = axes[i, j]
        # Plot scatter plots only on off-diagonal combinations
        if i != j:
            scatter = ax.scatter(data[:, j], data[:, i], c=iris.target, cmap='viridis', s=15)

        # Add labels to the outer edges of the grid
        if i == 3:
            ax.set_xlabel(features[j])
        if j == 0:
            ax.set_ylabel(features[i])

# Add a main legend to the figure
handles, labels = scatter.legend_elements()
fig.legend(handles, iris.target_names, loc='upper right', title="Classes")

plt.tight_layout()
plt.show()
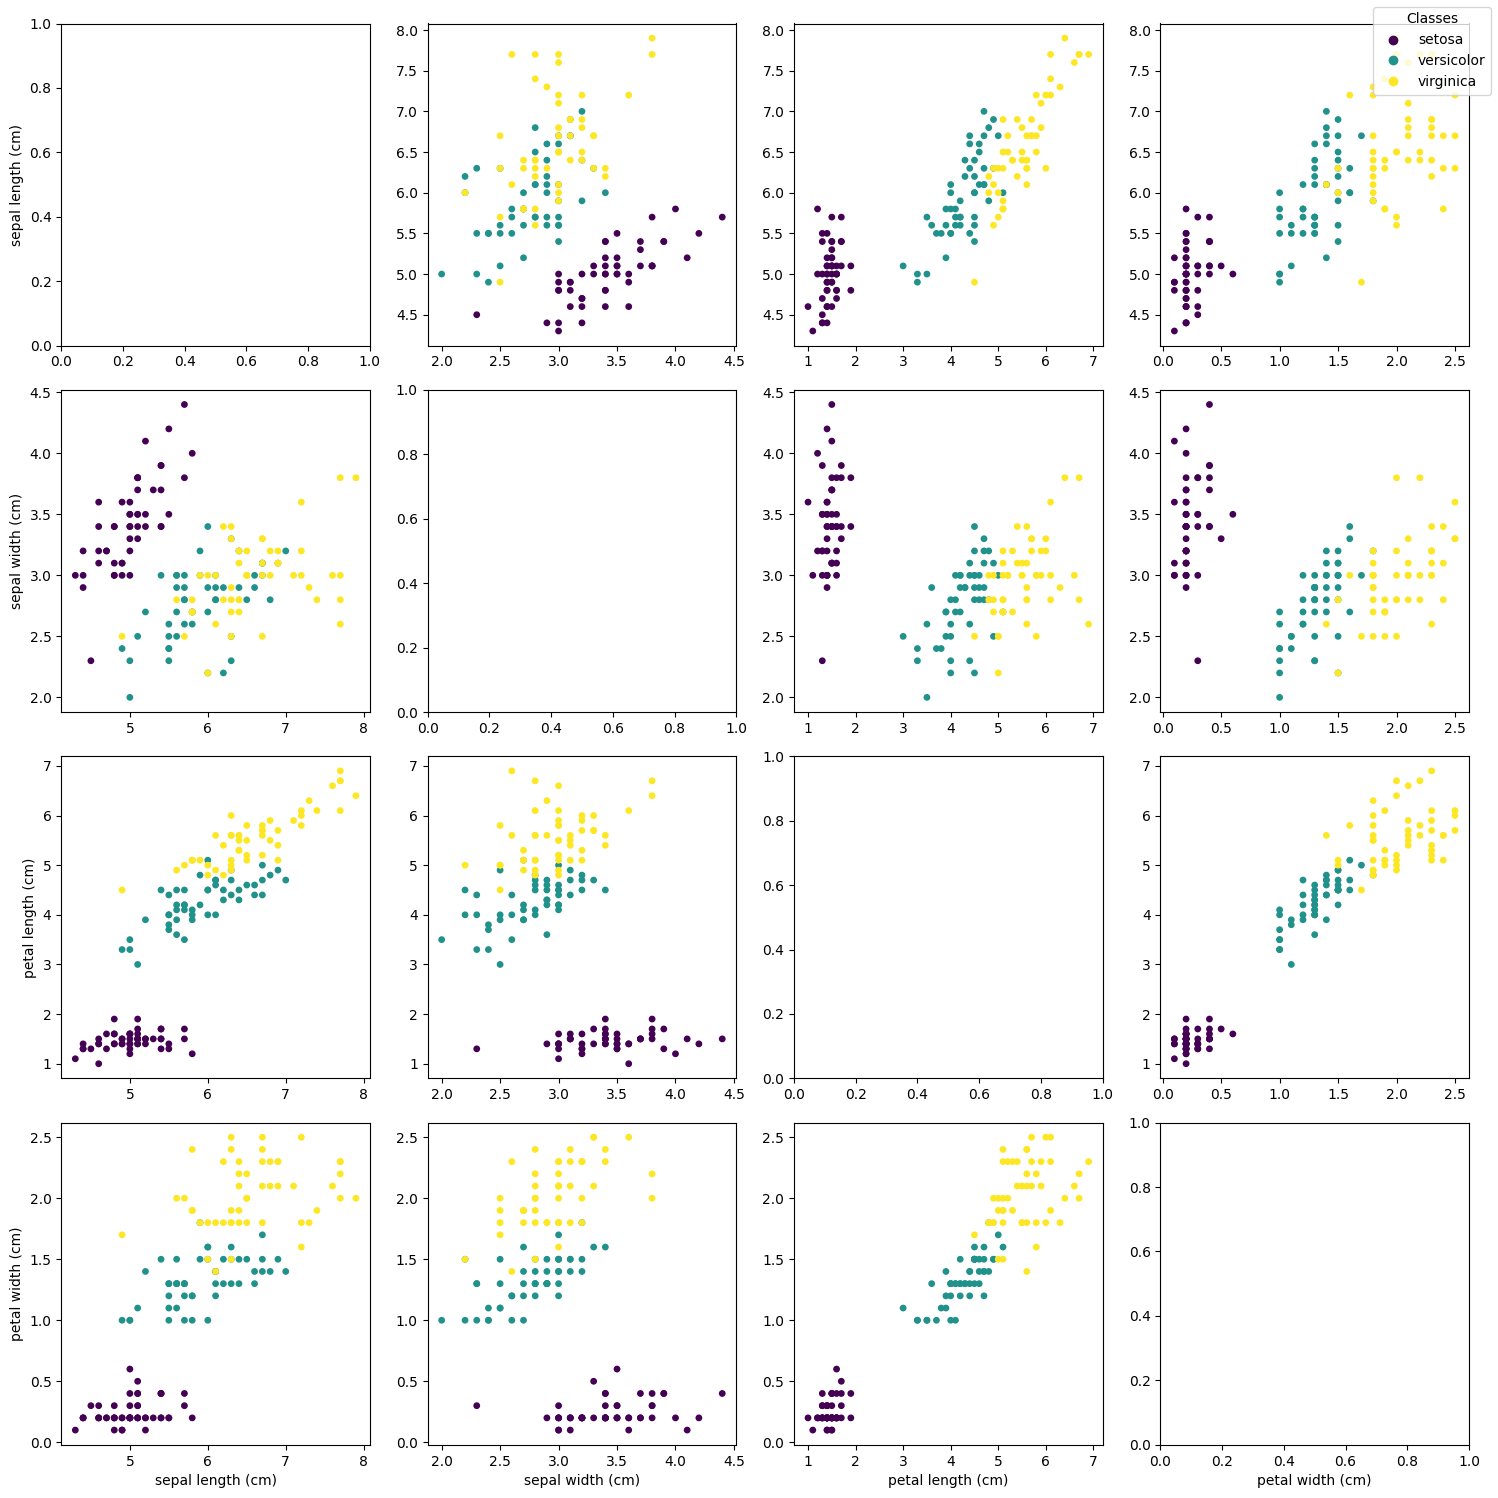
בגרפים רואים שמין אחד (setosa) נפרד היטב מהשניים האחרים כמעט בכל זוג תכונות, ואילו versicolor ו־virginica חופפים במקצת. נצפה אפוא שרוב הטעויות של הרשת יהיו בין שני המינים האלה.
פיצול הנתונים ויצירת טנסורים
כמו בפרקים הקודמים, נשמור חלק מהנתונים בצד כדי לבדוק את הרשת על פרחים שלא ראתה באימון. נפצל ל־80% אימון ו־20% בדיקה, ונמיר את המדידות לטנסורים מסוג float32 ואת התוויות לווקטורים מסוג long. הטיפוס long נדרש מפני ש־CrossEntropyLoss מצפה לקבל את התוויות כמספרים שלמים — אינדקס הקטגוריה — ולא כווקטור one-hot וגם לא כמספרים עשרוניים:
n_samples, n_features = data.shape
X_train_np, X_test_np, y_train_np, y_test_np = train_test_split (data,targets, test_size=0.2, random_state = 4)

X_train = torch.from_numpy(X_train_np.astype(np.float32))
X_test = torch.from_numpy(X_test_np.astype(np.float32))

y_train = torch.from_numpy(y_train_np).long() # Target labels should be 1D and of type long
y_test = torch.from_numpy(y_test_np).long()   # Target labels should be 1D and of type long
נבדוק את צורת הטנסורים:
print (X_train.shape, y_train.shape)
print (X_test.shape, y_test.shape)
פלט
torch.Size([120, 4]) torch.Size([120])
torch.Size([30, 4]) torch.Size([30])
נרמול
ארבע התכונות נמדדות בסנטימטרים, אך בטווחים שונים: אורך עלה הגביע נע בין 4.3 ל־7.9, ואילו רוחב עלה הכותרת בין 0.1 ל־2.5. כפי שלמדנו בפרק ג.10, נביא את כולן לסולם אחיד. נחשב מינימום ומקסימום לכל תכונה לפי קבוצת האימון ונגדיר נרמול Min–Max. הפרמטר dim=0 אומר ל־max ול־min לעבוד לאורך השורות, כלומר להחזיר ערך אחד לכל עמודה (תכונה):
max_train,__ = X_train.max(dim=0)
min_train, __ = X_train.min(dim=0)

def Normalize_minMax(X):
    return (X - min_train) / (max_train - min_train)


print (max_train, min_train)
פלט
tensor([7.9000, 4.4000, 6.9000, 2.5000]) tensor([4.3000, 2.2000, 1.0000, 0.1000])
ננרמל את שתי הקבוצות באמצעות אותם ערכי אימון ונבדוק את התוצאה. חשוב שגם קבוצת הבדיקה תנורמל לפי המינימום והמקסימום של קבוצת האימון, ולא לפי ערכיה שלה, כדי שהרשת תקבל בבדיקה קלט באותו סולם שעליו התאמנה:
X_train = Normalize_minMax(X_train)
X_test = Normalize_minMax(X_test)
# X_train = Normalize_z(X_train)
# X_test = Normalize_z(X_test)
print (X_train[0:5])
max_val, max_idx = X_train.max(dim=0)
print (max_val, max_idx)
פלט
tensor([[0.3056, 0.3636, 0.5932, 0.5833],
        [0.0833, 0.4545, 0.0678, 0.0417],
        [0.6667, 0.1364, 0.8136, 0.7083],
        [0.1667, 0.3636, 0.0678, 0.0417],
        [0.1944, 0.0455, 0.3898, 0.3750]])
tensor([1., 1., 1., 1.]) tensor([102,  16,  22,   5])
כל הערכים בקבוצת האימון נמצאים עתה בין 0 ל־1, והמקסימום של כל עמודה הוא בדיוק 1; השורה השנייה בפלט מציינת באיזו שורה נמצא המקסימום של כל תכונה.
התקן החישוב
לרשת הקטנה של Iris אין באמת צורך ב־GPU, אך נתרגל את המבנה הקבוע שנשתמש בו גם ברשתות גדולות. נבחר GPU אם הוא זמין, ואחרת CPU:
if torch.cuda.is_available():
    device = torch.device('cuda')
else:
    device = torch.device('cpu')
print(device)
נעביר את נתוני האימון והבדיקה לאותו התקן:
X_train = X_train.to(device)
X_test = X_test.to(device)
y_train = y_train.to(device)
y_test = y_test.to(device)
רשת Iris, הפסד ואופטימייזר
כאן נכנס ההבדל העיקרי מסיווג בינארי. נגדיר רשת עם ארבעה קלטים, שתי שכבות נסתרות בגודל 64 ו־128 ושלושה פלטים — נוירון פלט אחד לכל מין. שימו לב שהשכבה האחרונה מחזירה את הציונים הגולמיים בלי Softmax ובלי Sigmoid: nn.CrossEntropyLoss מפעילה בעצמה את Softmax על הפלט לפני חישוב ההפסד, ולכן הוספת Softmax ברשת הייתה מיותרת. הרשת מוגדרת כמחלקה, כפי שלמדנו בפרק הקודם, ומועברת להתקן החישוב באמצעות .to(device). נשתמש ב־CrossEntropyLoss וב־Adam, בקצב למידה 0.01 ולמשך 1,000 תקופות.
learning_rate = 1e-2
epochs = 1000
losses = [] # tensor to save losses for print

# design model
class ANN_Model(nn.Module):
    def __init__(self, input_size, num_classes):
        super().__init__()
        self.linear1 = nn.Linear(input_size,64)
        self.linear2 = nn.Linear(64, 128)
        self.linear3 = nn.Linear(128, num_classes)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.linear1(x)
        x = self.relu(x)         # torch.nn.functional as F
        x = self.linear2(x)
        x = self.relu(x)
        x = self.linear3(x)
        return x

Model = ANN_Model(input_size=4, num_classes=3).to(device)

#construct loss and optimizer
Loss = nn.CrossEntropyLoss ()

# init optimizer
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון Iris
לולאת האימון זהה לזו שהכרנו. מכיוון שקבוצת האימון קטנה, 120 פרחים בלבד, אין צורך באצוות: בכל תקופה נעביר את כל קבוצת האימון ברשת, נחשב הפסד ונגזרות, נעדכן משקלים ונאפס גרדיאנטים. נשמור את ההפסדים לציור גרף:
for epoch in range(epochs):
    # forward
    y_predict = Model(X_train)

    # backward
    loss = Loss(y_predict, y_train)
    loss.backward()

    # update wights
    optim.step()
    losses.append(loss.item())

    if epoch % 10 == 0:
        print(f"epoch= {epoch} loss={loss.item():.4f} ")

    # zero grads
    optim.zero_grad()
תחילת הפלט וסופו, בדילוג על שורות הביניים:
פלט
epoch= 0 loss=1.1119
epoch= 10 loss=0.3873
...
epoch= 990 loss=0.0000
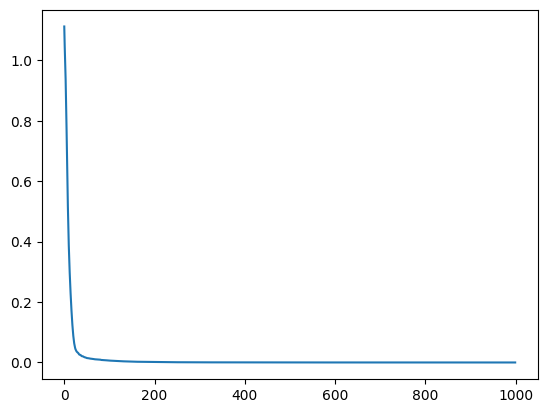
ההפסד ההתחלתי, כ־1.1, הוא בערך מה שמצפים מרשת שעדיין אינה יודעת דבר ומחלקת את ההסתברות באופן שווה בין שלושה מינים (ההפסד במקרה כזה הוא ln 3 ≈ 1.1). כבר אחרי עשר תקופות הוא ירד ל־0.39, ובסוף האימון הוא מתאפס בעיגול לארבע ספרות — הרשת מסווגת נכון את כל פרחי האימון.
תוצאות האימון
נציג את ההפסד לאורך האימון:
plt.plot(losses)
plt.show()
בדיקת Iris
הרשת מחזירה לכל פרח שלושה ציונים, אחד לכל מין. כדי להפוך אותם לתשובה אחת נבחר לכל פרח את אינדקס הציון המרבי ונשווה לתווית האמיתית. torch.max עם הפרמטר 1 מחזירה לכל שורה את הערך המרבי ואת האינדקס שלו; האינדקס הוא מספר המין שהרשת בחרה, ואין צורך להפעיל Softmax לשם כך, מפני ש־Softmax אינה משנה את סדר הציונים. הבדיקה כולה מתבצעת בתוך torch.no_grad(), שכן בשלב זה איננו מאמנים ואין צורך בנגזרות:
with torch.no_grad():
    y_predicted = Model(X_test)
    __,y_predict_arg = torch.max(y_predicted,1)
    n_correct = (y_predict_arg == y_test).sum().item()
    accuracy = n_correct / float(y_predicted.shape[0])
    print (f'accuracy = {accuracy*100:.4f}%')
פלט
accuracy = 93.3333%
נציג את התחזית והתווית זו לצד זו:
print ("predicted, test \n", torch.cat((y_predict_arg.view(-1,1), y_test.view(-1,1)), dim=1))
פלט
predicted, test
 tensor([[2, 2],
        [0, 0],
        [2, 2],
        [2, 2],
        [2, 2],
        [1, 1],
        [2, 1],
        [0, 0],
        [0, 0],
        [1, 2],
        [0, 0],
        [0, 0],
        [0, 0],
        [1, 1],
        [2, 2],
        [0, 0],
        [1, 1],
        [0, 0],
        [0, 0],
        [2, 2],
        [0, 0],
        [2, 2],
        [1, 1],
        [0, 0],
        [0, 0],
        [0, 0],
        [0, 0],
        [0, 0],
        [0, 0],
        [2, 2]], device='cuda:0')
בפלט השמור יש שתי טעויות מתוך 30 פרחים; הפסד אימון המעוגל לאפס אינו מבטיח שכל תחזיות הבדיקה נכונות. שתי הטעויות הן בין המינים 1 ו־2 — versicolor ו־virginica — בדיוק שני המינים שראינו חופפים בגרפי הפיזור, ואילו setosa (0) זוהה נכון בכל המקרים. הרשת למדה את קבוצת האימון בשלמות, אך על פרחים חדשים היא מדייקת "רק" ב־93%. זהו ההבדל בין שינון להכללה, ולכן תמיד מודדים את הדיוק על קבוצת בדיקה נפרדת.
סיווג Fashion-MNIST
כעת נעבור מטבלה קטנה של מדידות לתמונות. את Fashion-MNIST פגשנו בפרק ג.16, שם שאלנו רק "שמלה או לא שמלה". כעת נסווג תמונות לעשר קטגוריות לבוש — השאלה המלאה שלשמה נבנה המאגר. המבנה הכללי נשאר כמו ב־Iris, אך 60,000 תמונות של 784 פיקסלים כל אחת אי אפשר להעביר ברשת בבת אחת, ולכן נחזור לעבודה באצוות באמצעות DataLoader. נייבא את הספריות עבור דוגמה זו:
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt
import torchvision
import torchvision.transforms as transforms
נבחר שוב את התקן החישוב:
if torch.cuda.is_available():
    device = torch.device('cuda')
else:
    device = torch.device('cpu')
print(device)
טעינת נתוני הבגדים
המאגר כבר מחולק מראש לקבוצת אימון ולקבוצת בדיקה, ולכן איננו צריכים לפצל אותו בעצמנו. נטען את קבוצות האימון והבדיקה. ToTensor ממירה כל תמונה לטנסור, וגם מנרמלת את ערכי הפיקסלים מהתחום 0–255 לתחום 0–1, כך שהנרמול כאן נעשה בשבילנו:
train_dataset = torchvision.datasets.FashionMNIST(root='./data',
                                           train=True,
                                           transform=transforms.ToTensor(),
                                           download=True)

test_dataset = torchvision.datasets.FashionMNIST(root='./data',
                                          train=False,
                                          transform=transforms.ToTensor(),
                                          download=True)
נציג את פרטי שתי הקבוצות:
print(train_dataset)
print(test_dataset)
פלט
Dataset FashionMNIST
    Number of datapoints: 60000
    Root location: ./data
    Split: Train
    StandardTransform
Transform: ToTensor()
Dataset FashionMNIST
    Number of datapoints: 10000
    Root location: ./data
    Split: Test
    StandardTransform
Transform: ToTensor()
כמו ב־Iris, כל קטגוריה מיוצגת במספר שלם, והפעם יש עשר כאלה. נציג את שמות הקטגוריות ואת מספריהן, כדי שנוכל לתרגם את תשובות הרשת לשמות מובנים:
print(f'Class names: {train_dataset.classes}')
for number, name in enumerate(train_dataset.classes):
    print(f"Class Number: {number}, Class Name: {name}")
פלט
Class names: ['T-shirt/top', 'Trouser', 'Pullover', 'Dress', 'Coat', 'Sandal', 'Shirt', 'Sneaker', 'Bag', 'Ankle boot']
Class Number: 0, Class Name: T-shirt/top
Class Number: 1, Class Name: Trouser
Class Number: 2, Class Name: Pullover
Class Number: 3, Class Name: Dress
Class Number: 4, Class Name: Coat
Class Number: 5, Class Name: Sandal
Class Number: 6, Class Name: Shirt
Class Number: 7, Class Name: Sneaker
Class Number: 8, Class Name: Bag
Class Number: 9, Class Name: Ankle boot
יצירת אצוות
אצווה — Batch היא קבוצה קטנה של דוגמאות שמעבירים ברשת יחד ומבצעים אחריה צעד עדכון אחד. כך הרשת מתעדכנת אלפי פעמים במהלך תקופה אחת, במקום פעם אחת בלבד, והזיכרון הנדרש קטן. נחלק לאצוות של 50 תמונות; את קבוצת האימון נערבב, כדי שכל אצווה תכיל תערובת של קטגוריות ולא רצף של פריטים דומים:
batch_size = 50

train_loader = torch.utils.data.DataLoader(dataset=train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True)

test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle=False)
נבדוק כמה אצוות יש בכל קבוצה:
print(len(train_loader))
print(len(test_loader))
פלט
1200
200
60,000 תמונות האימון חולקו ל־1,200 אצוות של 50, ו־10,000 תמונות הבדיקה ל־200 אצוות.
דוגמאות מהנתונים
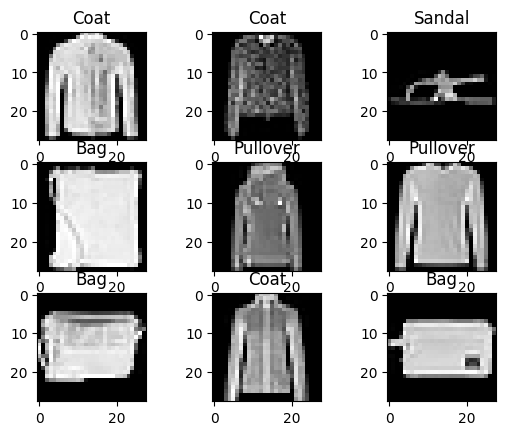
לפני הגדרת הרשת נבדוק מה כוללת אצווה וכיצד התמונות והתוויות מיוצגות. ניקח את האצווה השנייה ונציג ממנה תשע תמונות, את תוויותיהן ואת צורת הטנסורים. בסוף נדפיס שורת פיקסלים מהתמונה התשיעית:
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data, example_targets = next(examples)

for i in range(9):
    plt.subplot(3,3,i+1)
    plt.title (train_dataset.classes[example_targets[i].item()])
    plt.imshow(example_data[i][0], cmap='gray')
    print(example_targets[i].item(), example_data[i].shape)

plt.show()
print(example_data[8][0][10])
פלט
4 torch.Size([1, 28, 28])
4 torch.Size([1, 28, 28])
5 torch.Size([1, 28, 28])
8 torch.Size([1, 28, 28])
2 torch.Size([1, 28, 28])
2 torch.Size([1, 28, 28])
8 torch.Size([1, 28, 28])
4 torch.Size([1, 28, 28])
8 torch.Size([1, 28, 28])
פלט
tensor([0.0000, 0.0000, 0.0000, 0.0588, 0.9843, 0.8039, 0.7961, 0.8353, 0.8275,
        0.8078, 0.8196, 0.8235, 0.8353, 0.8314, 0.8314, 0.8392, 0.8353, 0.8392,
        0.8471, 0.8392, 0.8314, 0.8196, 0.8392, 0.8275, 0.8235, 0.8235, 0.9020,
        0.2431])
כל תמונה היא טנסור בצורה [1, 28, 28]: ערוץ צבע אחד (גווני אפור) ו־28 על 28 פיקסלים. שורת הפיקסלים שהודפסה מראה ערכים בין 0 (שחור) ל־1 (לבן) — כפי שציפינו מ־ToTensor.
פרמטרים ורשת לבגדים
הרשת לתמונות בנויה על אותו עיקרון כמו רשת Iris, רק גדולה יותר: יותר קלטים, שכבות נסתרות רחבות יותר ועשרה פלטים במקום שלושה. נגדיר 784 קלטים — מספר הפיקסלים בתמונה, 28 כפול 28 — שכבות נסתרות בגודל 256 ו־128, עשרה פלטים, חמש תקופות וקצב למידה 0.001. חמש תקופות בלבד מספיקות מפני שבכל תקופה מתבצעים 1,200 צעדי עדכון, אחד לכל אצווה:
input_size = 784 # 28x28
hidden_size1 = 256
hidden_size2 = 128
output_size = 10
epochs = 5
learning_rate = 1e-3
נגדיר מחדש את מחלקת הרשת וניצור מודל עבור תמונות הבגדים. המחלקה זהה במבנה לזו של Iris, אלא שגודלי השכבות הנסתרות נלקחים מהמשתנים שהגדרנו:
# design model
class ANN_Model(nn.Module):
    def __init__(self, input_size, num_classes):
        super().__init__()
        self.linear1 = nn.Linear(input_size,hidden_size1)
        self.linear2 = nn.Linear(hidden_size1, hidden_size2)
        self.linear3 = nn.Linear(hidden_size2, num_classes)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.linear1(x)
        x = self.relu(x)
        x = self.linear2(x)
        x = self.relu(x)
        x = self.linear3(x)
        return x

Model = ANN_Model(input_size, output_size).to(device)
נגדיר CrossEntropyLoss ואופטימייזר Adam עבור המודל החדש:
#construct loss and optimizer
Loss = nn.CrossEntropyLoss ()

# init optimizer
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון Fashion-MNIST
לולאת האימון מקבלת כאן לולאה פנימית: הלולאה החיצונית עוברת על התקופות, והפנימית על האצוות שבכל תקופה. בכל אצווה נפרוש את התמונות לשורות של 784 ערכים — הרשת שלנו מקבלת וקטור שטוח ולא ריבוע של פיקסלים — נעביר אותן ואת התוויות להתקן ונבצע צעד אימון. ההדפסה מתבצעת פעם ב־100 אצוות, והמונה num סופר את הצעדים מתחילת האימון:
n_total_steps = len(train_loader)
for epoch in range(epochs):
    for i, (images, lables) in enumerate(train_loader):

        # origin shape: [50, 1, 28, 28]
        # resized: [50, 784]
        images = images.reshape(-1, 28*28).to(device)
        lables = lables.to(device)

        # forward
        Y_predict = Model(images)

        # backward
        loss = Loss(Y_predict, lables)
        loss.backward()

        # update wights
        optim.step()

        if (i + epoch * n_total_steps) % 100 == 0:
            print(f"epoch= {epoch} i= {i} num= {i+epoch * n_total_steps} loss={loss.item():.4f} ")

        # zero grads
        optim.zero_grad()
תחילת הפלט וסופו, בדילוג על שורות הביניים:
פלט
epoch= 0 i= 0 num= 0 loss=2.2812
epoch= 0 i= 100 num= 100 loss=0.6721
...
epoch= 4 i= 1100 num= 5900 loss=0.1990
ההפסד ההתחלתי, כ־2.28, קרוב ל־ln 10 ≈ 2.3 — הערך של רשת שמחלקת את ההסתברות באופן שווה בין עשר קטגוריות. ההפסד המודפס הוא של אצווה אחת בלבד, ולכן הוא קופץ מעט משורה לשורה; המגמה הכללית היא ירידה, וכעבור כ־6,000 צעדים הוא מגיע לכ־0.2.
בדיקת Fashion-MNIST
גם את הבדיקה נבצע באצוות. נעבור על קבוצת הבדיקה, נבחר בכל אצווה את הקטגוריה בעלת הציון המרבי בעזרת torch.max, נצבור את מספר התשובות הנכונות ונחשב את אחוז התחזיות הנכונות:
with torch.no_grad():
    n_correct = 0
    n_samples = 0
    for images, lables in test_loader:
        images = images.reshape(-1, 28*28).to(device)
        labels = lables.to(device)
        labels_pre = Model(images)
        __,labels_pre_arg = torch.max(labels_pre,1)
        n_correct += (labels_pre_arg == labels).sum().item()
        n_samples += lables.size(0)


    acc = 100 * n_correct / n_samples
    print(f'Accuracy of the network on the {n_samples} test images: {acc} %')
פלט
Accuracy of the network on the 10000 test images: 87.56 %
כ־87.5% מ־10,000 תמונות הבדיקה סווגו נכון. זו תוצאה סבירה לרשת פשוטה שרואה כל תמונה כרשימת פיקסלים; בפרקים על רשתות קונבולוציה נראה כיצד לשפר אותה. שימו לב שהמשימה קשה יותר מסיווג הספרות בפרק הקודם: חלק מהקטגוריות, כמו חולצה, טי־שירט וסוודר, דומות זו לזו מאוד.
תחזיות והסתברויות
עד כה שאלנו את הרשת רק "מה התשובה?". בסיווג רב־קטגוריות אפשר לשאול גם "עד כמה את בטוחה?". אפשר להציג הן את הקטגוריה שהרשת בחרה והן את ההסתברויות שחישבה לקטגוריות השונות. ניקח את אצוות הבדיקה הראשונה. הפלט הגולמי של הרשת, הציונים לפני Softmax, נקרא לוגיטים — Logits. argmax בוחרת את הקטגוריה — האינדקס של הציון הגבוה ביותר — ו־Softmax מחשבת את ההסתברויות שנדפיס לצד התחזיות. ההסתברות שנדפיס היא זו של הקטגוריה שנבחרה, ולכן היא תמיד הגבוהה מבין העשר:
print(len(test_loader))
print (n_samples)
print(lables.shape)
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data = example_data.to(device)
example_targets = example_targets.to(device)
with torch.no_grad():
    # Get raw model outputs (logits)
    raw_predictions = Model(example_data.reshape(-1, 28*28))
    # Calculate probabilities using softmax
    probabilities = torch.softmax(raw_predictions, dim=1)
    # Apply argmax to find the predicted class for each example
    predicted_classes = torch.argmax(raw_predictions, dim=1)

print("Predicted, True (Class Index) and Probability")
for i in range(len(example_data)):
    predicted_class_index = predicted_classes[i].item()
    predicted_prob = probabilities[i, predicted_class_index].item()
    print (f"Pred: {predicted_class_index}, True: {example_targets[i].item()}, Prob: {predicted_prob:.2f}")
פלט
200
10000
torch.Size([50])
Predicted, True (Class Index) and Probability
Pred: 9, True: 9, Prob: 0.98
Pred: 2, True: 2, Prob: 1.00
Pred: 1, True: 1, Prob: 1.00
Pred: 1, True: 1, Prob: 1.00
Pred: 0, True: 6, Prob: 0.49
Pred: 1, True: 1, Prob: 1.00
Pred: 4, True: 4, Prob: 0.99
Pred: 6, True: 6, Prob: 0.99
Pred: 5, True: 5, Prob: 1.00
Pred: 7, True: 7, Prob: 1.00
Pred: 4, True: 4, Prob: 0.72
Pred: 5, True: 5, Prob: 1.00
Pred: 7, True: 7, Prob: 0.74
Pred: 3, True: 3, Prob: 1.00
Pred: 4, True: 4, Prob: 0.61
Pred: 1, True: 1, Prob: 1.00
Pred: 2, True: 2, Prob: 1.00
Pred: 2, True: 4, Prob: 0.98
Pred: 8, True: 8, Prob: 1.00
Pred: 0, True: 0, Prob: 0.98
Pred: 2, True: 2, Prob: 0.99
Pred: 5, True: 5, Prob: 0.82
Pred: 7, True: 7, Prob: 1.00
Pred: 9, True: 9, Prob: 0.49
Pred: 1, True: 1, Prob: 1.00
Pred: 2, True: 4, Prob: 0.85
Pred: 6, True: 6, Prob: 0.88
Pred: 0, True: 0, Prob: 0.81
Pred: 9, True: 9, Prob: 0.98
Pred: 3, True: 3, Prob: 0.48
Pred: 8, True: 8, Prob: 1.00
Pred: 8, True: 8, Prob: 1.00
Pred: 3, True: 3, Prob: 0.97
Pred: 3, True: 3, Prob: 0.96
Pred: 8, True: 8, Prob: 1.00
Pred: 0, True: 0, Prob: 0.98
Pred: 7, True: 7, Prob: 1.00
Pred: 5, True: 5, Prob: 1.00
Pred: 7, True: 7, Prob: 1.00
Pred: 9, True: 9, Prob: 1.00
Pred: 0, True: 6, Prob: 0.98
Pred: 1, True: 1, Prob: 1.00
Pred: 6, True: 3, Prob: 0.40
Pred: 7, True: 7, Prob: 0.86
Pred: 6, True: 6, Prob: 0.97
Pred: 7, True: 7, Prob: 0.93
Pred: 2, True: 2, Prob: 0.98
Pred: 1, True: 1, Prob: 1.00
Pred: 2, True: 2, Prob: 0.62
Pred: 6, True: 2, Prob: 0.58
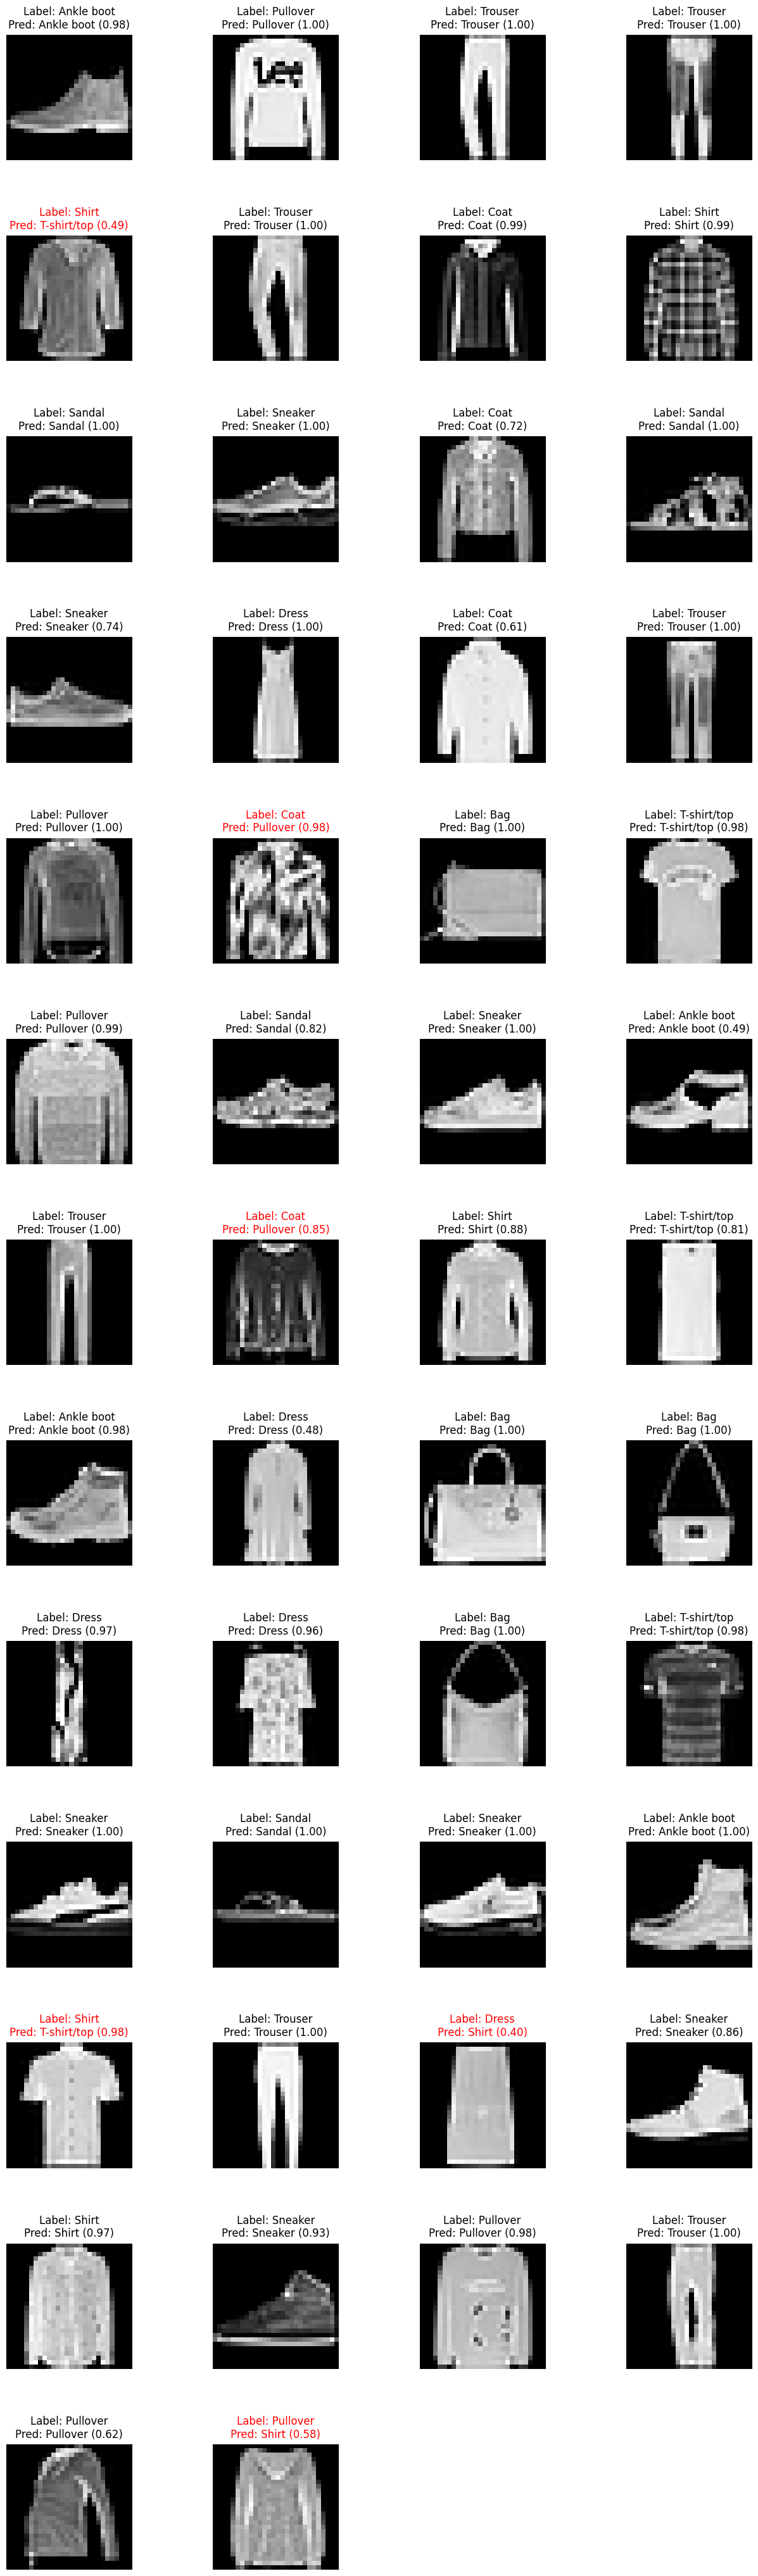
רוב התחזיות הנכונות מגיעות עם הסתברות קרובה ל־1 — הרשת "בטוחה". כשההסתברות נמוכה, למשל 0.49 או 0.40, פירוש הדבר שהרשת התלבטה בין כמה קטגוריות, ובמקרים כאלה יש סיכוי גבוה יותר לטעות; ואכן, כמה מהטעויות בפלט מופיעות עם הסתברות נמוכה. אבל גם תחזית עם הסתברות גבוהה יכולה להיות שגויה: בפלט מופיעה, למשל, תחזית 2 (סוודר) במקום 4 (מעיל) בהסתברות 0.98. ההסתברות מבטאת את הביטחון של הרשת, לא את הנכונות.
לסיום נחבר את המספרים לתמונות עצמן. נציג את 50 התמונות עם שם הקטגוריה האמיתית, שם התחזית וההסתברות שלה. כותרת אדומה מסמנת טעות, וכך אפשר לראות בעין אילו פריטים מבלבלים את הרשת:
examples = iter(test_loader)
example_data, example_targets = next(examples)
example_data = example_data.to(device)
example_targets = example_targets.to(device)

with torch.no_grad():
    raw_predictions_plot = Model(example_data.reshape(-1, 28*28))
    probabilities = torch.softmax(raw_predictions_plot, dim=1)
    predicted_classes_plot = torch.argmax(raw_predictions_plot, dim=1)

num_images = 50
cols = 4
rows = (num_images + cols - 1) // cols

plt.figure(figsize=(16, rows * 4))

for i in range(num_images):
    plt.subplot(rows, cols, i + 1)

    true_label = train_dataset.classes[example_targets[i].item()]
    pred_idx = predicted_classes_plot[i].item()
    pred_label = train_dataset.classes[pred_idx]
    pred_prob = probabilities[i, pred_idx].item()

    color = 'black' # Default color for correct answers
    if pred_idx != example_targets[i].item():
        color = 'red' # Red for incorrect answers

    plt.title(
        f"Label: {true_label}\nPred: {pred_label} ({pred_prob:.2f})",
        fontsize=12,
        pad=8,
        color=color
    )

    plt.imshow(example_data[i][0].cpu(), cmap="gray")
    plt.axis("off")

plt.subplots_adjust(wspace=0.25, hspace=0.6)
plt.show()