ג.20 רשתות קונבולוציה — CNN ו־CIFAR-10
עד כה סיווגנו תמונות ברשת נוירונים "רגילה": שיטחנו כל תמונה לווקטור ארוך של פיקסלים והזנו אותו לשכבות לינאריות, שבהן כל נוירון מחובר לכל קלט. על ספרות ופריטי לבוש קטנים בגוני אפור זה עבד לא רע, אבל לגישה הזו שתי בעיות שמתגלות ברגע שהתמונות נעשות גדולות וצבעוניות. הראשונה היא כמות המשקלים: תמונת CIFAR-10 קטנה יחסית, 32×32 פיקסלים בשלושה ערוצי צבע, ובכל זאת יש בה 3×32×32 ערכים, וכל נוירון בשכבה הראשונה זקוק למשקל נפרד לכל אחד מהם. בתמונה של מצלמה רגילה, עם מיליוני פיקסלים, מספר המשקלים בשכבה הראשונה בלבד היה עצום — קשה לאמן, קל להתאים יתר על המידה.
הבעיה השנייה עמוקה יותר: ההשטחה מוחקת את המבנה של התמונה. אחרי ההשטחה, פיקסל ושכנו הצמוד הם בעיני הרשת שני קלטים סתמיים, לא יותר קרובים זה לזה מפיקסל בפינה הנגדית. אבל בתמונה, מה שמשמעותי הוא דווקא הקשר בין שכנים — קו הוא רצף של פיקסלים כהים זה לצד זה, פינה היא מפגש של שני קווים, אוזן של חתול היא שילוב של כמה עקומות. יתרה מזו, חתול שמופיע בצד ימין של התמונה וחתול זהה בצד שמאל מפעילים קלטים שונים לגמרי, והרשת הרגילה צריכה ללמוד לזהות כל אחד מהם בנפרד.
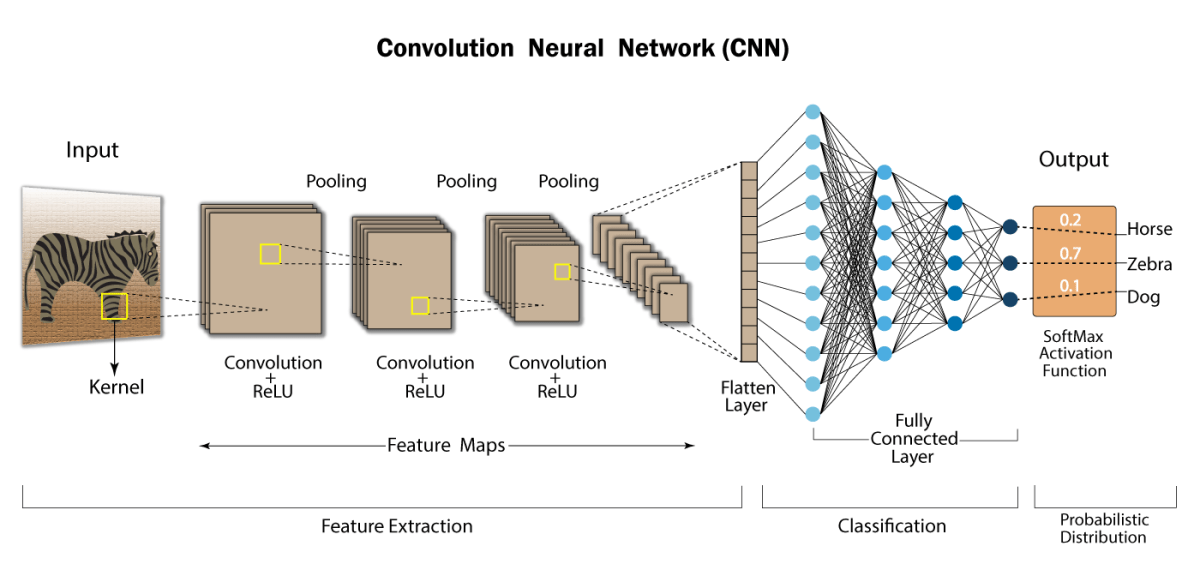
רשת קונבולוציה — Convolutional Neural Network (CNN) פותרת את שתי הבעיות ברעיון אחד. במקום נוירון שמסתכל על כל התמונה, היא משתמשת במסנן — Filter (או Kernel): מטריצה קטנה של משקלים, למשל 3×3 או 5×5, ש"מחליקה" על פני התמונה ובודקת בכל מיקום עד כמה האזור הקטן שמתחתיה דומה לתבנית שהיא מחפשת. מסנן אחד עשוי לזהות קו אנכי, אחר קו אופקי, שלישי מעבר חד מבהיר לכהה. אותם משקלים משמשים בכל מיקום, ולכן מספר הפרמטרים קטן, וקו אנכי מזוהה בכל מקום בתמונה. מה שהמסננים מחפשים אינו נקבע מראש: הרשת לומדת את משקליהם באימון, בדיוק כפי שלמדה את המשקלים בשכבות הלינאריות. שכבות מוקדמות לומדות תבניות פשוטות כמו קווים וקצוות, ושכבות עמוקות יותר מצרפות אותן לצורות מורכבות — עין, גלגל, כנף.
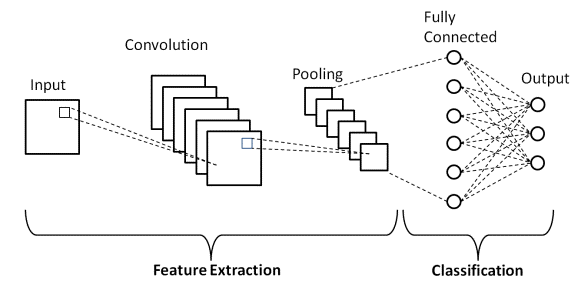
רשת CNN מעבדת אזורים קטנים בתמונה באמצעות מסננים, וכך מפיקה מידע שישמש לסיווג. פעולת החישוב הזו נקראת קונבולוציה — Convolution. הרשת מתחילה בשכבות קונבולוציה, שתפקידן להפיק מהתמונה תכונות, וממשיכה ברשת נוירונים רגילה, שמסווגת על סמך התכונות האלה; לפני שנכיר את הפעולה, נכיר את ייצוג התמונה בזיכרון.
השיעור וההרצאות באתר של גלעד מרקמן
חומרי הליווי: מצגת רשתות קונבולוציה (עותק מקומי) · מחברת CIFAR-10 (עותק מקומי)
ייצוג תמונה בזיכרון
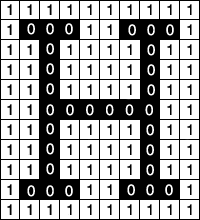
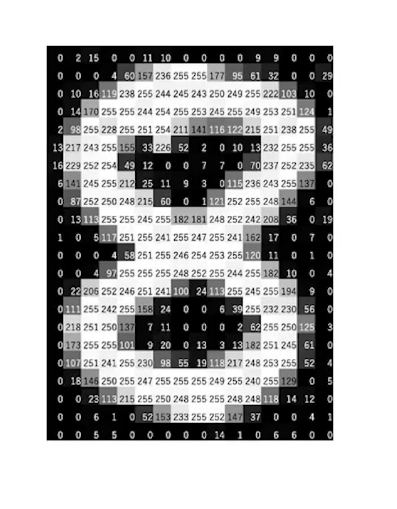
כדי להבין מה המסנן עושה, עלינו לדעת על מה בדיוק הוא פועל. בשביל המחשב תמונה אינה "ציור" אלא טבלה של מספרים: תמונה מיוצגת כמטריצה של פיקסלים, וממדי המטריצה — מספר השורות ומספר העמודות — הם הרזולוציה שלה. כל תא במטריצה מכיל את הבהירות של פיקסל אחד. בתמונה בינארית הערכים הם 0 או 1; בתמונת גוני אפור של 8 סיביות הערכים הם 0–255, משחור ללבן.
תמונה צבעונית — RGB
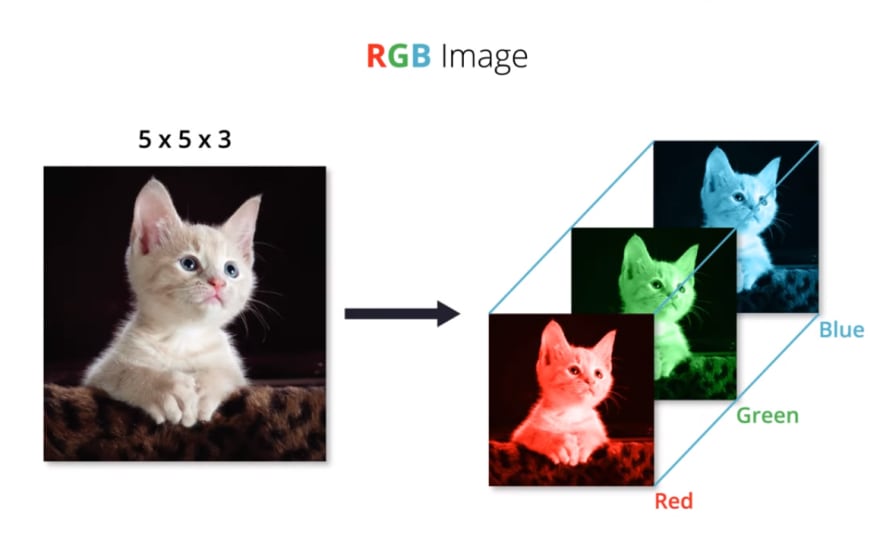
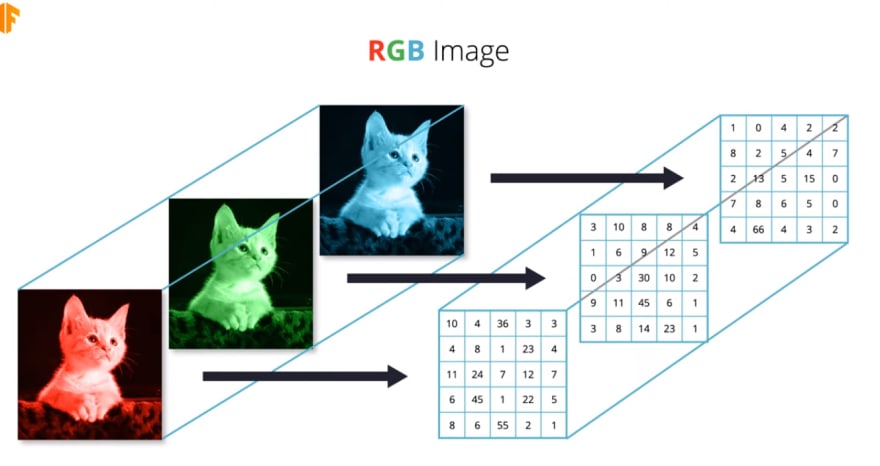
בתמונה צבעונית אין די במספר אחד לפיקסל, כי צבע נוצר מעירוב של שלושה אורות בסיסיים. לכן תמונה צבעונית מיוצגת בשלוש מטריצות באותם ממדים: אדום, ירוק וכחול. אלה שלושת ערוצי הצבע — Channels. לכל פיקסל שלושה ערכים, אחד מכל ערוץ: שחור הוא (0,0,0), לבן הוא (255,255,255), ואדום טהור הוא ערך גבוה בערוץ הראשון ואפס בשניים האחרים. כך תמונת CIFAR-10 של 32×32 פיקסלים נשמרת כטנסור בצורה 3×32×32.
קונבולוציה בתמונה בגוני אפור
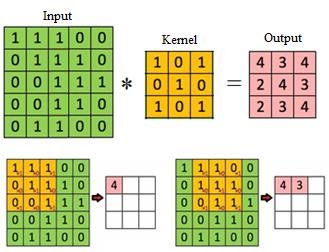
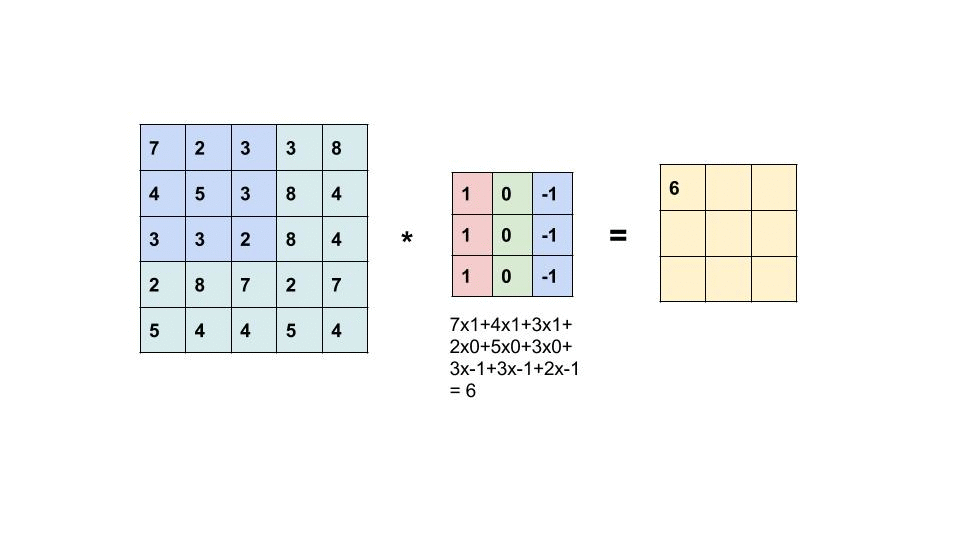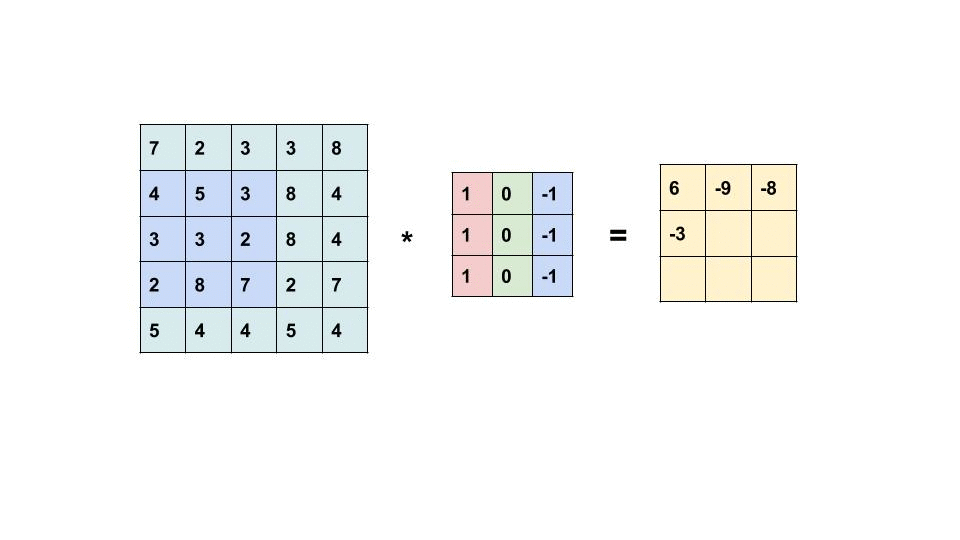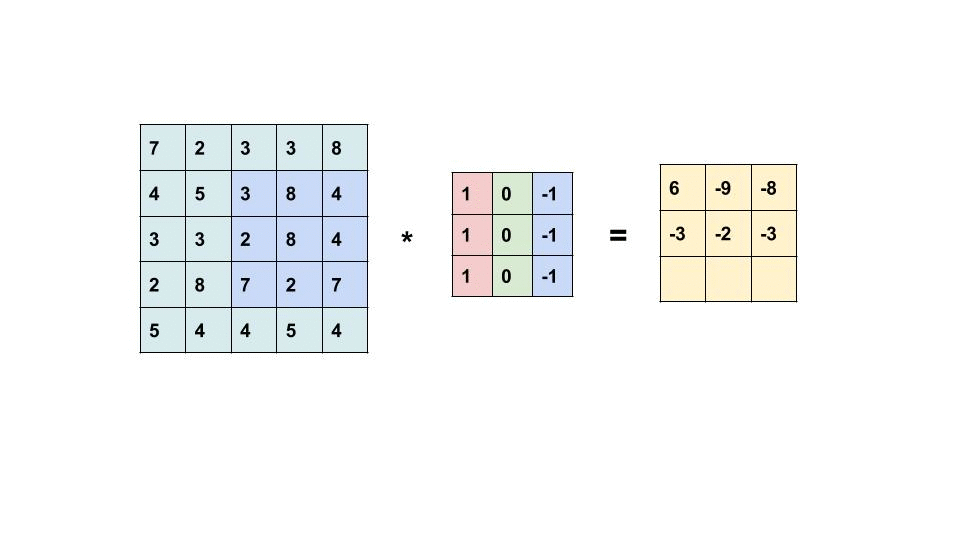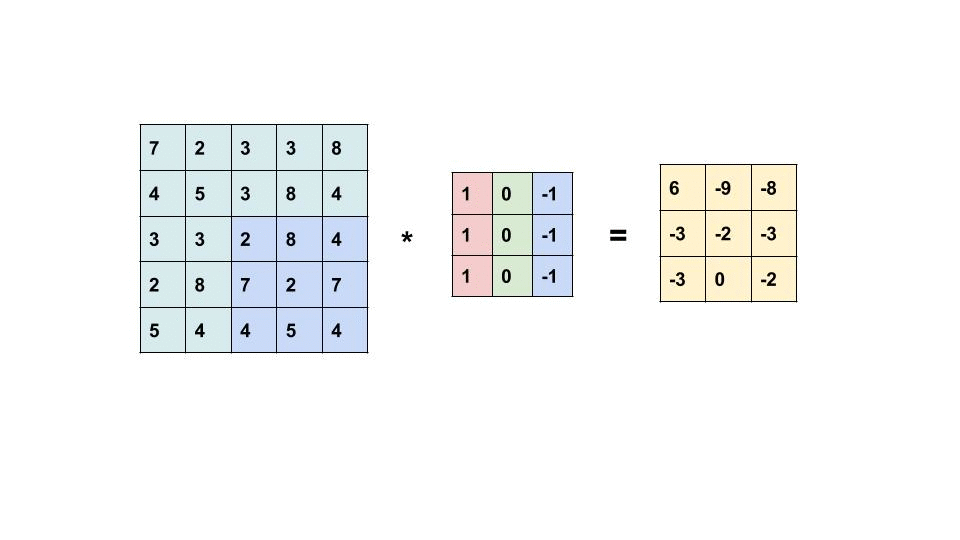
כעת נראה כיצד המסנן "מחליק" על התמונה בפועל. המסנן, Kernel, הוא מטריצה קטנה של משקלים, והוא עובר על התמונה בחלונות בגודלו. בכל מיקום כופלים את האיברים המתאימים בחלון ובמסנן וסוכמים את כל המכפלות למספר אחד, שנרשם בתא אחד של הפלט; אחר כך מזיזים את המסנן ימינה ולמטה בצעדים קבועים וחוזרים על החישוב. התוצאה היא מטריצה חדשה, מפת תכונות — Feature Map, שבה כל תא אומר עד כמה התבנית של המסנן נמצאה באזור המתאים בתמונה.
בחלון הראשון בדוגמה, העמודה השמאלית היא 7, 4, 3 והימנית היא 3, 3, 2. המסנן מחבר את השמאלית ומחסר את הימנית, ולכן מתקבל 7+4+3−3−3−2=6. שימו לב מה המסנן הזה "מחפש": הוא מחזיר ערך גדול כשהצד השמאלי של החלון בהיר מהימני, ערך קרוב לאפס באזור אחיד, וערך שלילי כשהכיוון הפוך. כלומר זהו גלאי של קצה אנכי — מעבר מבהיר לכהה.
קונבולוציה בתמונה צבעונית
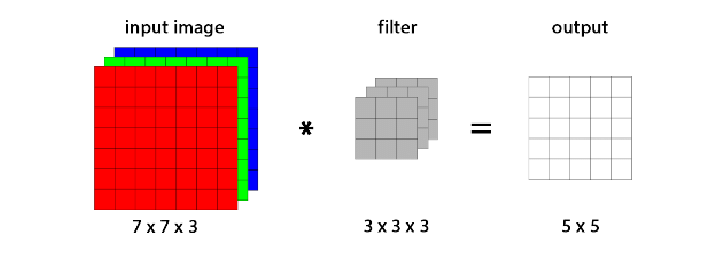
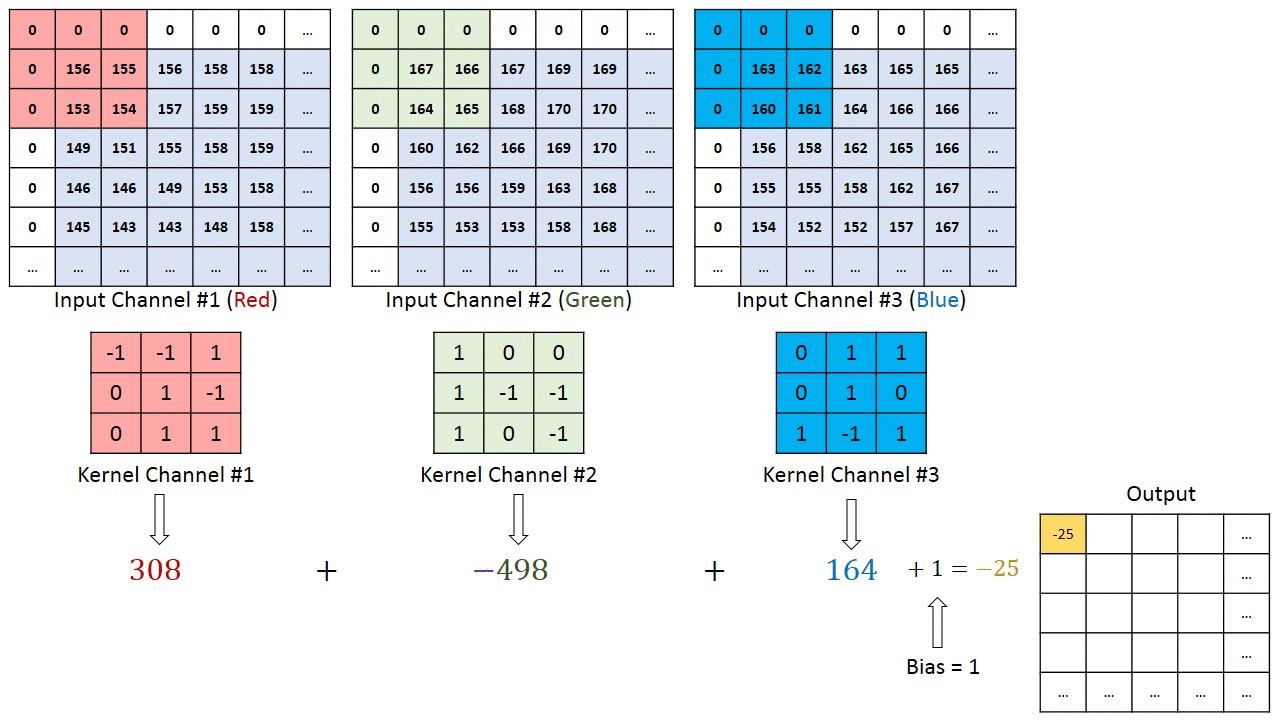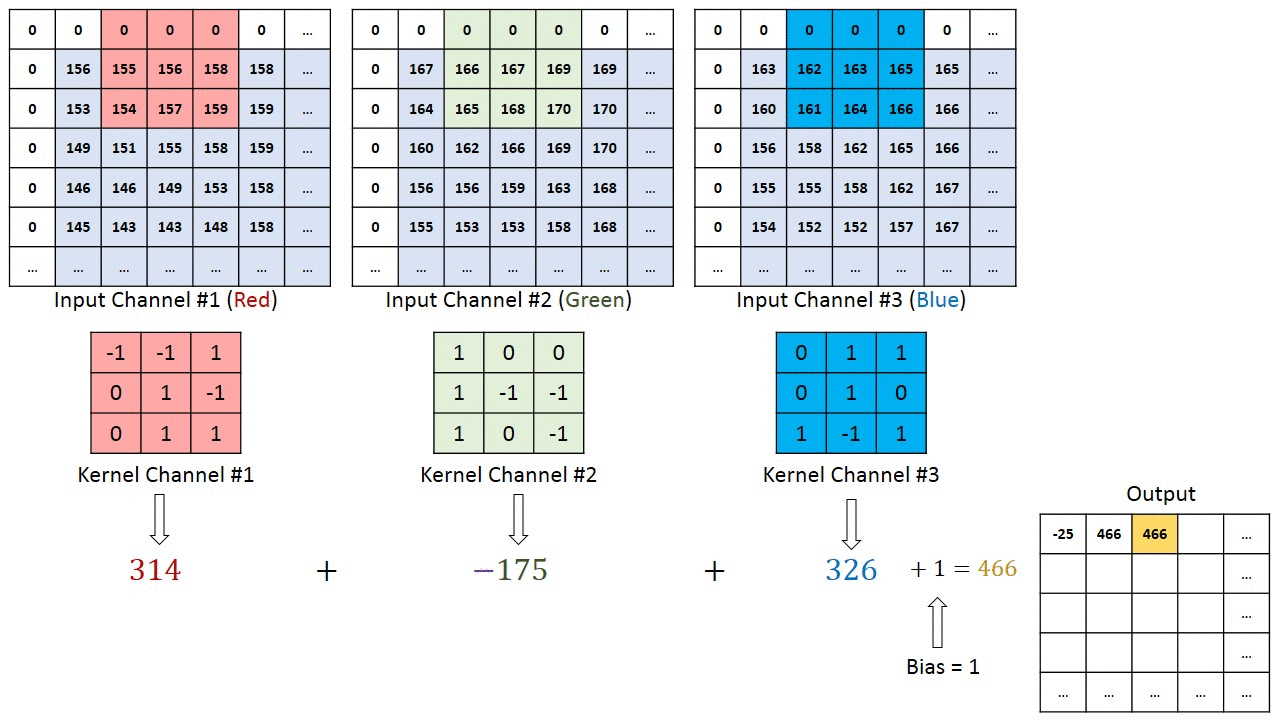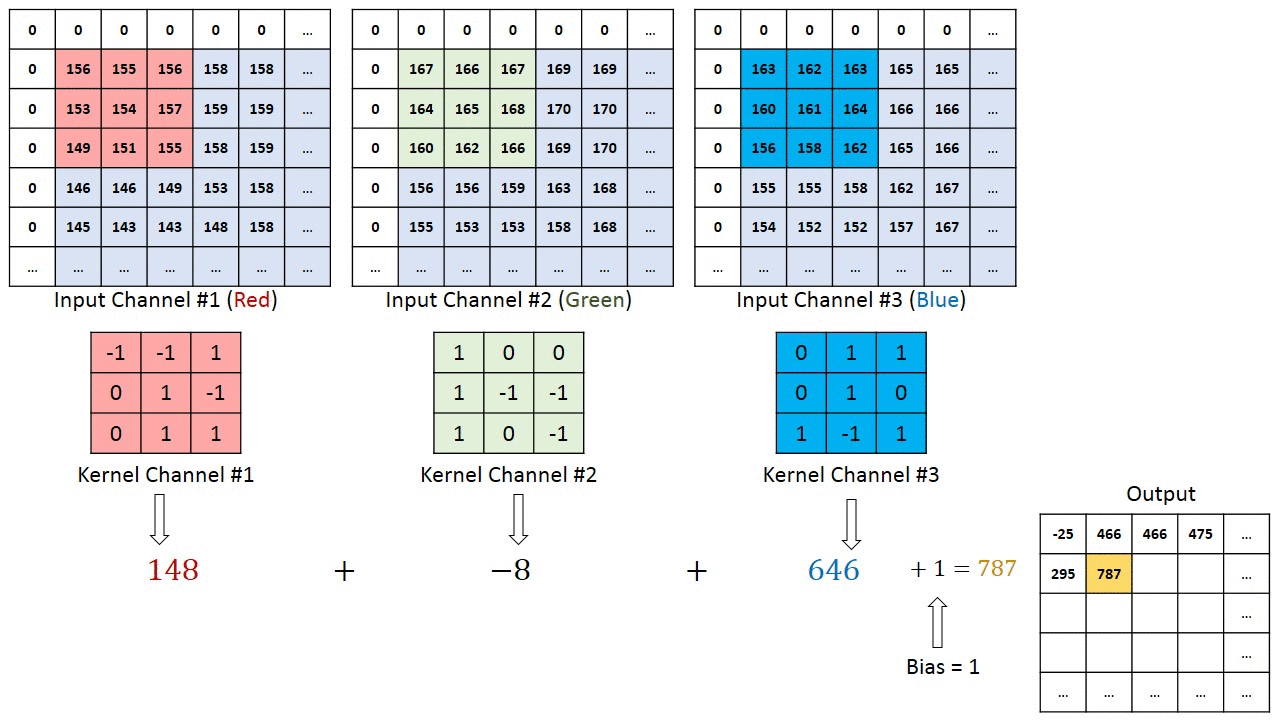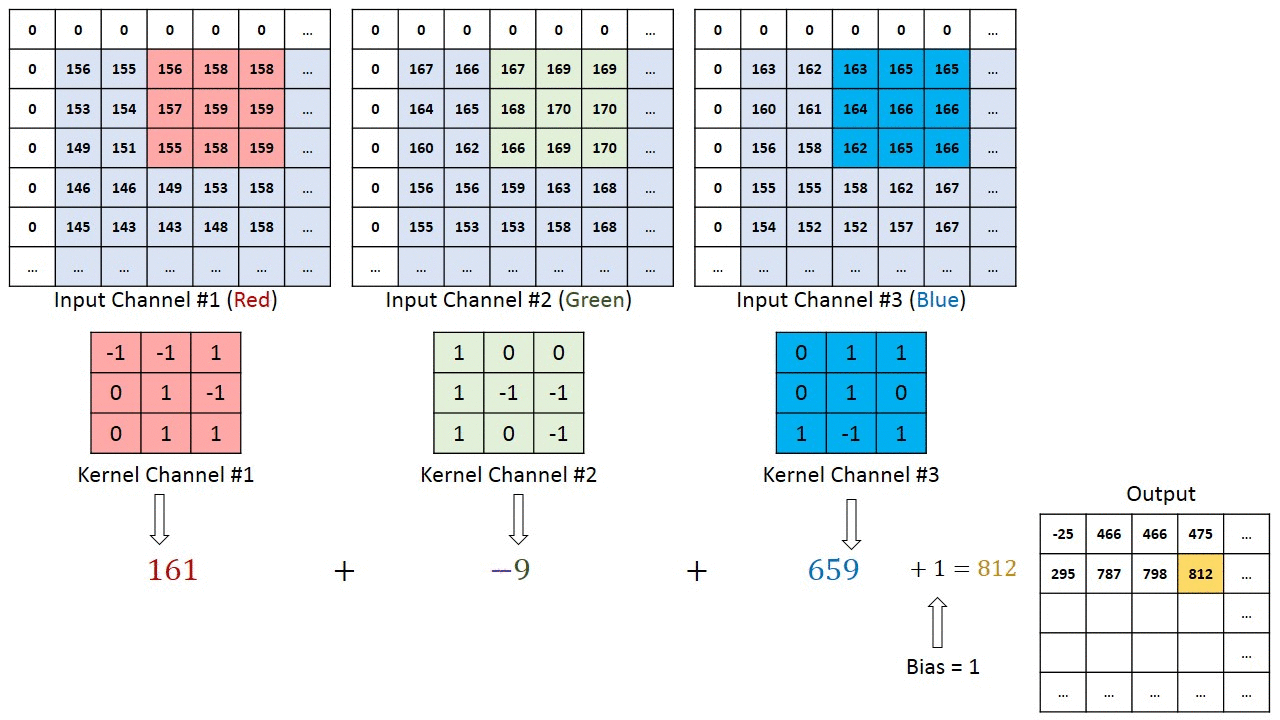
בתמונה צבעונית הקלט הוא שלוש מטריצות, ולכן גם המסנן צריך "עומק": המסנן כולל מטריצה לכל ערוץ קלט, ומסנן 3×3 לתמונת RGB מכיל בפועל 3×3×3 משקלים. מחשבים את המכפלות בכל ערוץ בנפרד וסוכמים את התוצאות של שלושת הערוצים למספר אחד; לכן מסנן אחד יוצר מפת פלט אחת, ולא שלוש.
בדוגמה המספרית של שלושת הערוצים מתקבלות התוצאות 308, −498 ו־164. כמו לנוירון בשכבה לינארית, גם למסנן יש הטיה (bias), מספר יחיד שמתווסף לסכום; לאחר הוספת הטיה של 1 מתקבל תא הפלט 308−498+164+1=−25.
מספר ערוצי הפלט
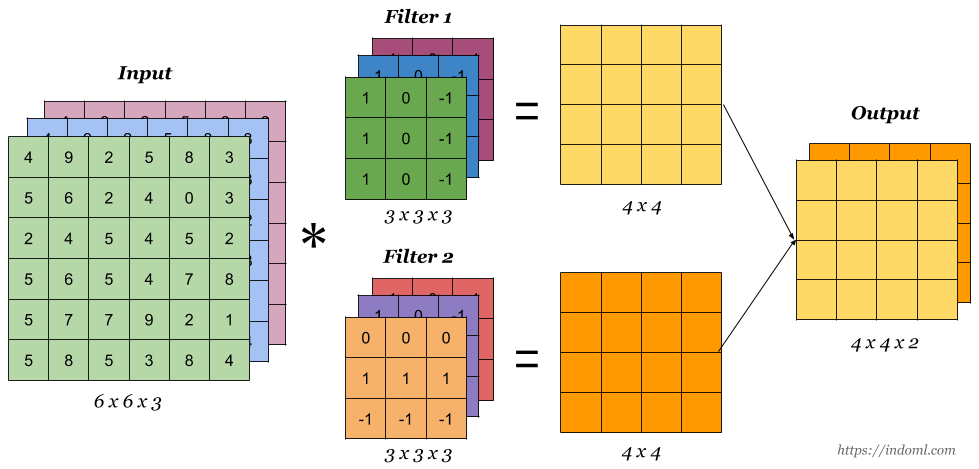
מסנן אחד מזהה תבנית אחת, וזה מעט מאוד. כדי לתאר תמונה צריך לחפש בה במקביל קווים בכיוונים שונים, קצוות, כתמי צבע ועוד. לכן מפעילים כמה מסננים על אותו קלט, לכל אחד משקלים משלו. כל מסנן מפיק מפת תכונות אחת, ולכן מספר המסננים הוא שקובע את מספר ערוצי הפלט.
נעקוב אחרי הממדים באיור. הקלט הוא תמונה בגודל 6×6 עם שלושה ערוצי צבע, כלומר 6×6×3. מפעילים עליה שני מסננים, וכל מסנן הוא בגודל 3×3×3: שלוש שורות, שלוש עמודות ועומק שלוש, כי עומק המסנן שווה תמיד למספר ערוצי הקלט. מסנן 3×3 שמחליק על תמונה 6×6 מפיק מפה בגודל 4×4, ומכיוון שיש שני מסננים מתקבלות שתי מפות 4×4. כלומר, מתמונה של שלושה ערוצים בגודל 6×6 קיבלנו תמונה חדשה של שני ערוצים בגודל 4×4, 4×4×2. מספר ערוצי הפלט אינו תלוי במספר ערוצי הקלט אלא רק במספר המסננים שבחרנו: אפשר היה להפעיל על אותה תמונה למשל 32 מסננים ולקבל תמונה בגודל 4×4 עם 32 ערוצים, 4×4×32. מפות התכונות האלה הן ה"ערוצים" של השכבה הבאה, ממש כפי ששלושת ערוצי הצבע היו הערוצים של השכבה הראשונה; מסנן בשכבה הבאה יהיה אז בעומק 32.
Padding
בחישוב שראינו המסנן אינו יכול לחרוג מגבולות התמונה, ולכן מפת הפלט קטנה מהקלט, והפיקסלים שבשוליים נכנסים לפחות חלונות מאלה שבמרכז. ריפוד — Padding מוסיף מסגרת אפסים סביב התמונה ומגדיל את התחום שעליו אפשר להפעיל את המסנן. כך אפשר לשמור על ממדי הפלט שווים לממדי הקלט ולתת גם לשוליים משקל שווה.
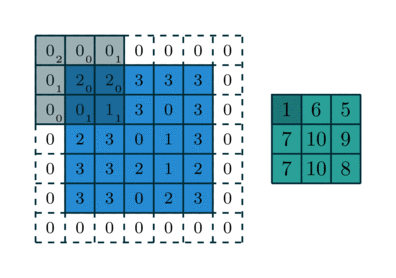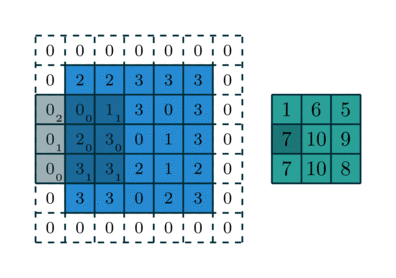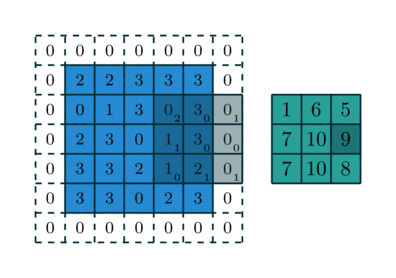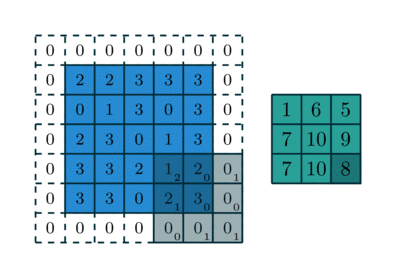
Stride
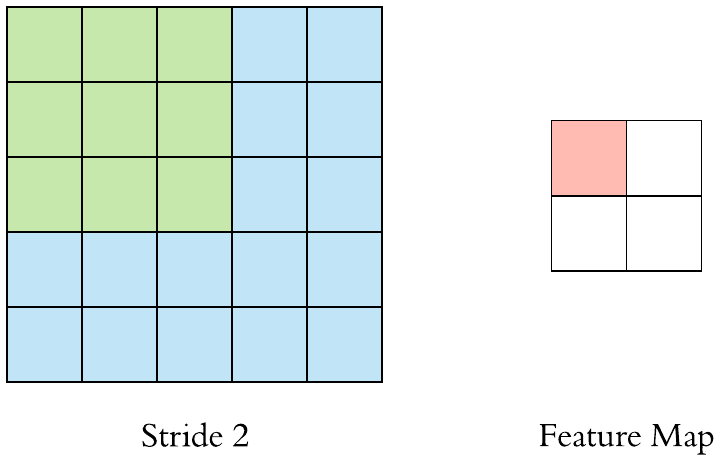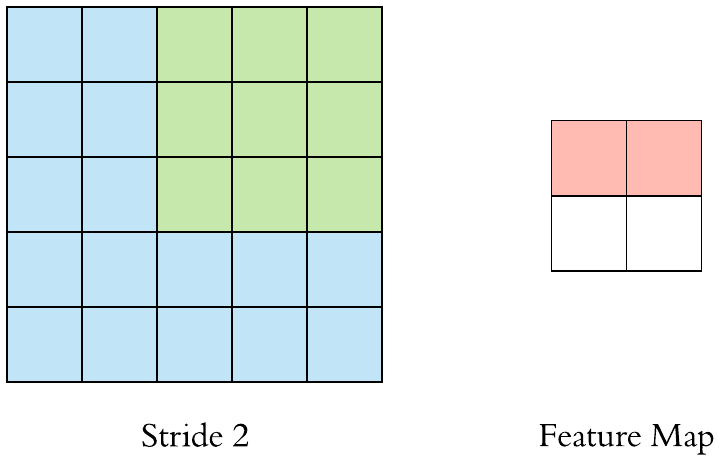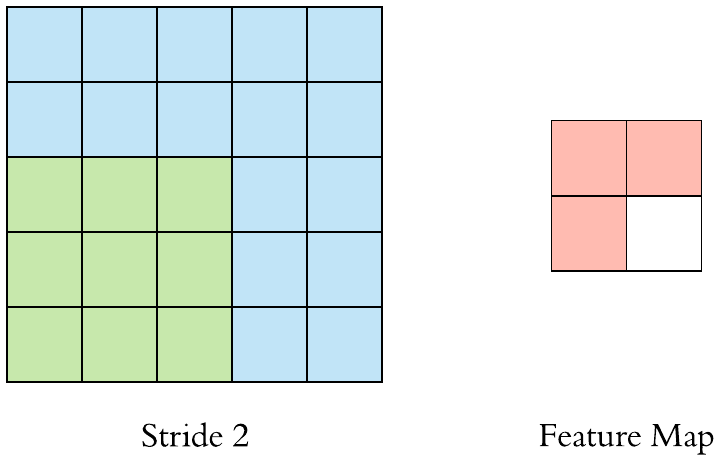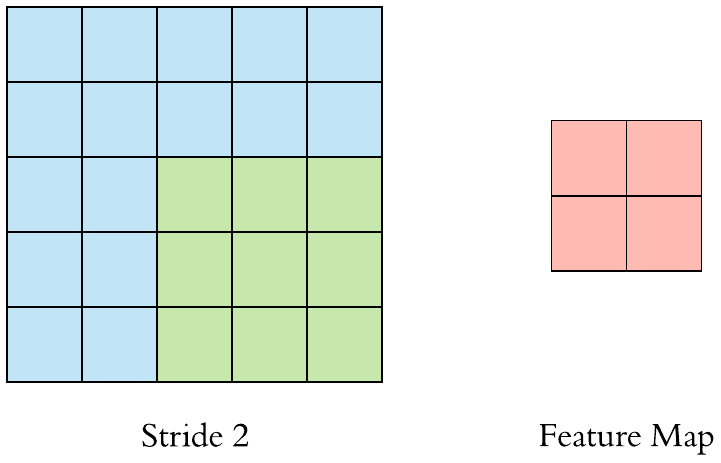
צעד — Stride הוא גודל הצעד של המסנן: בכמה פיקסלים מזיזים אותו בין חישוב לחישוב. צעד גדול יותר פירושו פחות חלונות, ולכן מפת פלט קטנה יותר וחישוב מהיר יותר, במחיר של דילוג על חלק מהמיקומים. בקלט 5×5 ומסנן 3×3 ללא padding, צעד 1 נותן פלט 3×3, וצעד 2 נותן פלט 2×2.
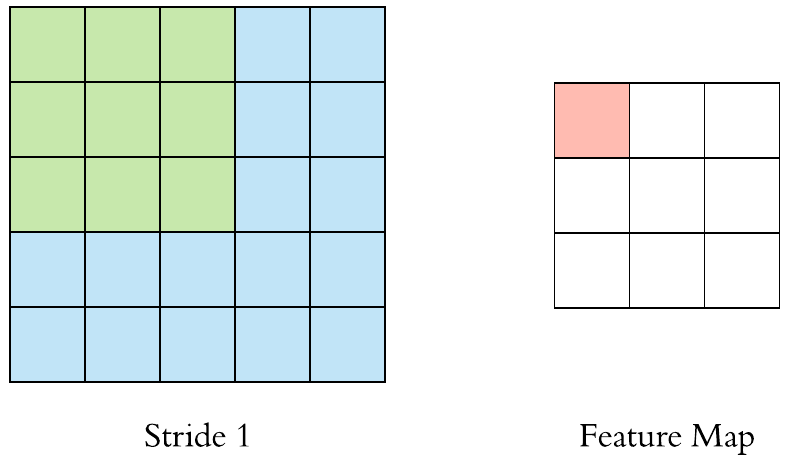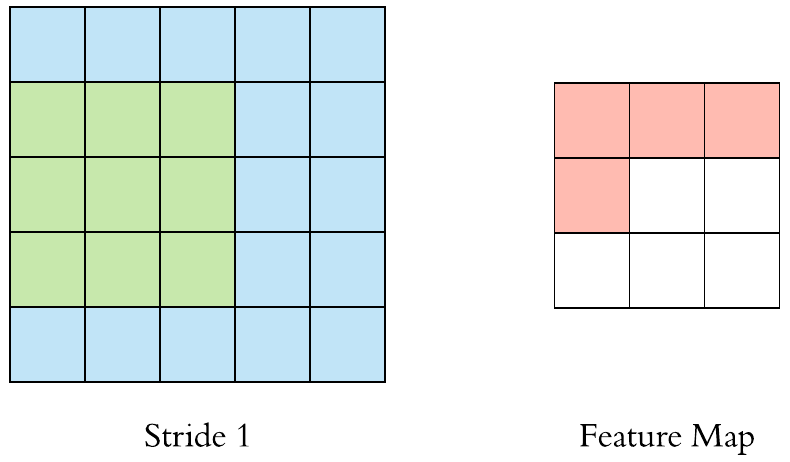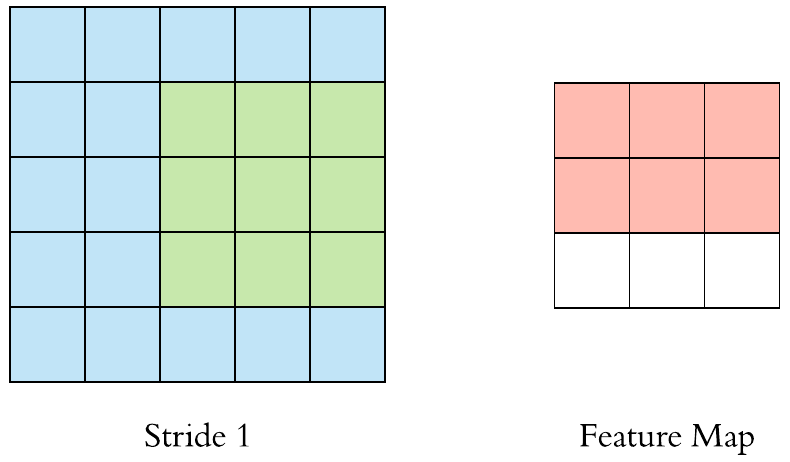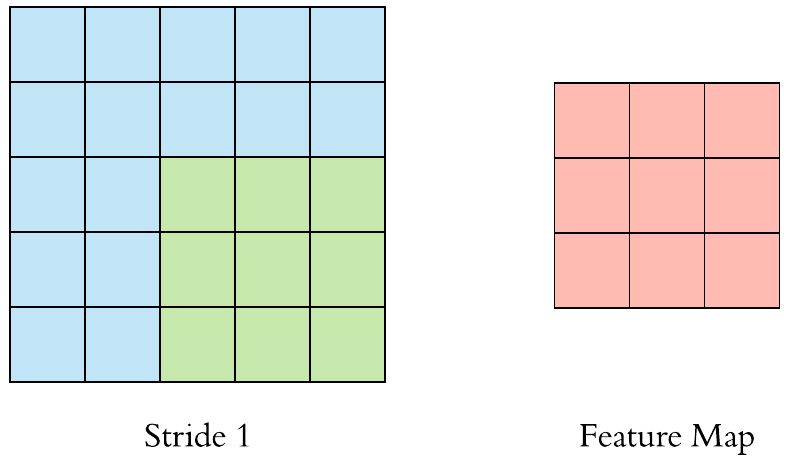
חישוב ממדי הקונבולוציה
כשבונים רשת צריך לדעת מראש מה גודל הפלט של כל שכבה, כי השכבה הבאה חייבת לקבל קלט בגודל מתאים — בייחוד השכבה הלינארית הראשונה, שמספר הקלטים שלה נקבע מראש. ממדי הפלט תלויים בגודל הקלט והמסנן, בריפוד ובצעד. נחשב אותם כדי לדעת מה עובר לשכבה הבאה:
$$ n_{out}=\left\lfloor\frac{n_{in}+2p-k}{s}\right\rfloor+1 $$
- n_in — גודל הקלט בציר אחד (רוחב או גובה), במספר פיקסלים.
- n_out — גודל הפלט באותו ציר.
- k — גודל המסנן (kernel): מסנן 3×3 הוא k = 3.
- p — הריפוד (padding): מספר שורות האפסים שנוספו בכל צד.
- s — הצעד (stride).
- ⌊ ⌋ — עיגול כלפי מטה למספר שלם (floor).
הנוסחה מחושבת בנפרד לכל ציר, רוחב וגובה; בתמונות ריבועיות התוצאה זהה בשניהם.
דוגמה: נחזור לאיורים מסעיף Stride. הקלט 5×5, המסנן 3×3, ללא ריפוד וצעד 1, כלומר n_in = 5, k = 3, p = 0, s = 1:
$$ n_{out}=\left\lfloor\frac{5+2\cdot 0-3}{1}\right\rfloor+1=\lfloor 2\rfloor+1=3 $$
מתקבלת מפת תכונות 3×3, כמו באיור הראשון. עם צעד 2, s = 2, מתקבל ⌊2/2⌋ + 1 = 2, כלומר מפה 2×2 כמו באיור השני. ואם נוסיף ריפוד של שורה אחת, p = 1, עם צעד 1, מתקבל ⌊(5 + 2 − 3)/1⌋ + 1 = 5: הפלט שומר על גודל הקלט, וזה בדיוק השימוש הנפוץ בריפוד.
Pooling
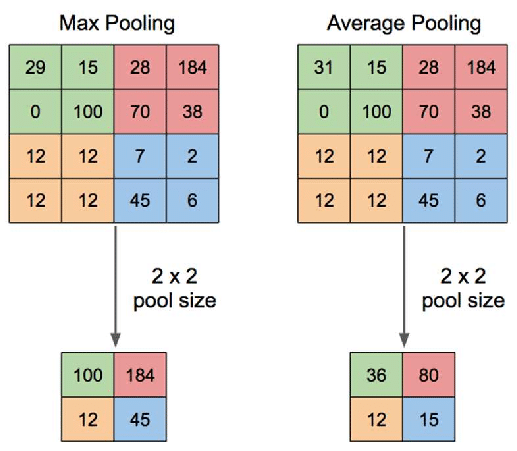
אחרי הקונבולוציה מפות התכונות עדיין גדולות, ולרוב אין צורך לדעת בדיוק באיזה פיקסל נמצא קצה — מספיק לדעת שיש קצה באזור. Pooling מצמצם את הממדים באמצעות בחירת מספר אחד מכל חלון: Max Pooling בוחרת את המקסימום, כלומר "האם התבנית נמצאה איפשהו בחלון", ו־Average Pooling את הממוצע. כך כמות החישוב בשכבות הבאות קטנה, והרשת נעשית פחות רגישה להזזות קטנות של העצם בתמונה.
בחלון הראשון בדוגמת המקסימום הערכים הם 29, 15, 0, 100, ולכן מתקבל 100. בדוגמת הממוצע הערכים הם 31, 15, 0, 100, ולכן הממוצע המדויק הוא 36.5.
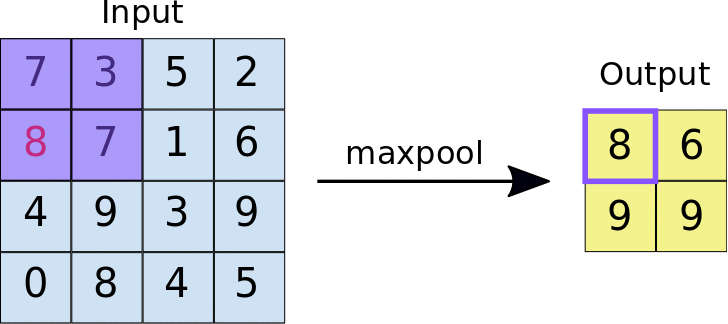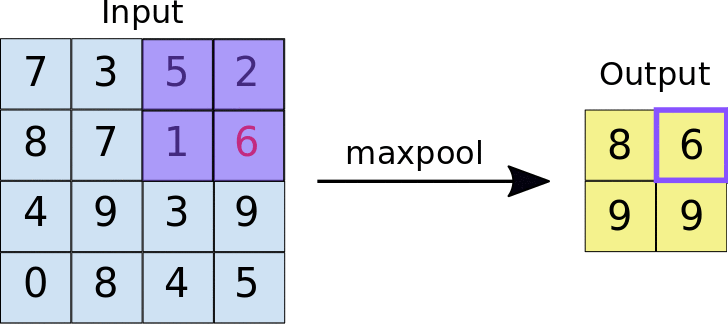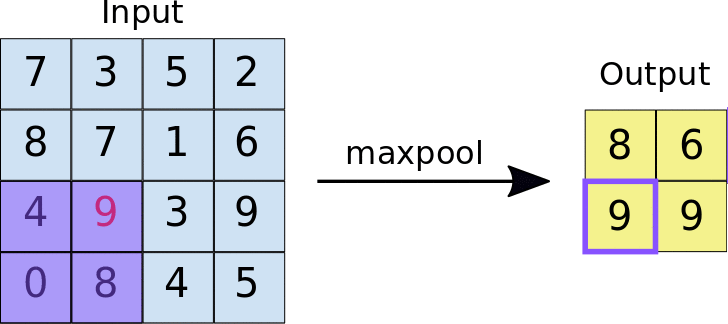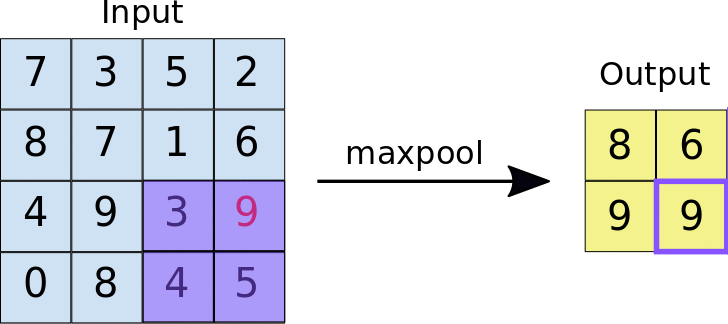
גם ל־Pooling יש חלון וצעד, ולכן גם את גודל הפלט שלו אפשר לחשב באותו אופן. ללא ריפוד, גודל הפלט הוא:
$$ n_{out}=\left\lfloor\frac{W-F}{S}\right\rfloor+1 $$
- W — גודל הקלט בציר אחד (רוחב או גובה).
- F — גודל חלון ה־Pooling: חלון 2×2 הוא F = 2.
- S — הצעד שבו החלון זז.
- n_out — גודל הפלט באותו ציר.
דוגמה: באיור ה־Max Pooling הקלט הוא 4×4, החלון 2×2 והצעד 2, כלומר W = 4, F = 2, S = 2:
$$ n_{out}=\left\lfloor\frac{4-2}{2}\right\rfloor+1=1+1=2 $$
מתקבלת מפה 2×2, כפי שרואים באיור. בחלון 2×2 ובצעד 2, המקרה הנפוץ, הפלט הוא תמיד חצי מהקלט בכל ציר: מפה 28×28 הופכת ל־⌊(28 − 2)/2⌋ + 1 = 14, כלומר 14×14.
Conv2d ו־MaxPool2d ב־PyTorch
אחרי שהבנו את הפעולות, נראה כיצד מגדירים אותן ב־PyTorch. שכבת קונבולוציה, nn.Conv2d, היא שכבה כמו nn.Linear: משקלי המסננים וההטיות שלהם הם הפרמטרים הנלמדים במהלך האימון, ו־Gradient Descent מעדכן אותם בדיוק כפי שהוא מעדכן משקלים בשכבה לינארית. ל־Pooling, לעומת זאת, אין משקלים נלמדים — זו פעולה קבועה. הפרמטרים של nn.Conv2d הם, לפי הסדר: מספר ערוצי הקלט, מספר ערוצי הפלט (מספר המסננים), גודל המסנן, הצעד והריפוד. נגדיר קונבולוציה משלושה ערוצים לשישה, כלומר שישה מסננים על תמונת RGB, עם מסנן 5×5, צעד 1 וללא ריפוד; אחריה Pooling בחלון 2×2 ובצעד 2:
import torch.nn as nn

in_Channels, out_channels, kernel, stride, padding = 3, 6, 5, 1, 0
c = nn.Conv2d(in_Channels, out_channels, kernel, stride, padding)

pool_kernel, pool_stride = 2, 2
mp = nn.MaxPool2d(pool_kernel, pool_stride)
נעבור על שתי הפקודות ועל מה שכל אחת מקבלת.
nn.Conv2d(in_channels, out_channels, kernel_size, stride, padding) יוצרת שכבת קונבולוציה:
in_channels = 3— מספר ערוצי הקלט. הוא חייב להתאים לתמונה שתיכנס לשכבה: תמונת RGB היא שלושה ערוצים. זהו גם העומק של כל מסנן.out_channels = 6— מספר המסננים, ולכן מספר ערוצי הפלט: השכבה תחזיר שש מפות תכונות.kernel_size = 5— גודל המסנן. מספר יחיד פירושו מסנן ריבועי 5×5.stride = 1ו־padding = 0— הצעד והריפוד. אלה ערכי ברירת המחדל, ואפשר להשמיט אותם.
השכבה יוצרת שישה מסננים בגודל 3×5×5, כלומר 450 משקלים ועוד שש הטיות. הם מאותחלים באקראי ומתעדכנים בכל צעד אימון, בדיוק כמו המשקלים של nn.Linear.
nn.MaxPool2d(kernel_size, stride) יוצרת שכבת Max Pooling: kernel_size = 2 הוא חלון 2×2 ו־stride = 2 הוא הצעד. לשכבה הזו אין משקלים, ולכן אין בה מה ללמוד; היא רק בוחרת את המקסימום בכל חלון.
סדר הממדים של הקלט. nn.Conv2d אינה מקבלת תמונה בודדת אלא טנסור בארבעה ממדים, ובסדר קבוע: מספר התמונות באצווה, מספר הערוצים, מספר השורות ומספר העמודות — בקיצור N×C×H×W. תמונת RGB אחת בגודל 32×32 צריכה להגיע כטנסור 1×3×32×32. הבעיה היא שתמונות מגיעות בדרך כלל בסדר אחר: ספריות התמונות, NumPy ו־matplotlib שומרות תמונה כשורות, עמודות וערוצים, H×W×C, למשל 32×32×3. לכן צריך לסדר מחדש את הצירים באמצעות permute, שמקבלת את הסדר החדש של הצירים, ולהוסיף בתחילת הטנסור את ממד האצווה באמצעות unsqueeze(0):
import torch

img = torch.rand(32, 32, 3)   # rows, columns, channels - the usual image order
print(img.shape)
x = img.permute(2, 0, 1)      # -> channels, rows, columns
print(x.shape)
x = x.unsqueeze(0)            # -> batch of one image
print(x.shape)

out = c(x)
print(out.shape)
print(mp(out).shape)
פלט
torch.Size([32, 32, 3])
torch.Size([3, 32, 32])
torch.Size([1, 3, 32, 32])
torch.Size([1, 6, 28, 28])
torch.Size([1, 6, 14, 14])
הקונבולוציה קיבלה תמונה אחת של שלושה ערוצים בגודל 32×32 והחזירה תמונה אחת של שישה ערוצים בגודל 28×28, בהתאם לנוסחה שראינו: ⌊(32 − 5)/1⌋ + 1 = 28. ה־Pooling הקטין אותה ל־14×14. ממד האצווה נשאר 1 לאורך כל הדרך. בהמשך הפרק לא נצטרך לסדר את הצירים בעצמנו: transforms.ToTensor של torchvision ממירה כל תמונה מסדר שורות־עמודות־ערוצים לסדר ערוצים־שורות־עמודות, ו־DataLoader מצרף את התמונות לאצווה ומוסיף את הממד הראשון. ולהפך, כשנרצה להציג תמונה ב־matplotlib נצטרך להחזיר את הצירים לסדר שורות־עמודות־ערוצים.
מבנה CNN
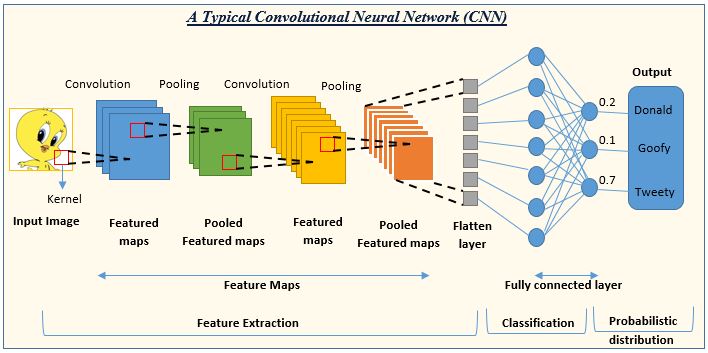
כעת נרכיב את אבני הבניין לרשת שלמה. בשונה מהרשתות הקודמות, התמונה נכנסת בלי השטחה — כטנסור של ערוצים, שורות ועמודות — כדי שהמסננים יוכלו לנצל את הקרבה בין פיקסלים שכנים. בכל שלב מפעילים קונבולוציה, אקטיבציה (ReLU) ו־Pooling: הקונבולוציה מחפשת תבניות, האקטיבציה מוסיפה אי־לינאריות כמו בכל רשת, וה־Pooling מקטין את המפות. אחרי כמה שלבים כאלה נשארות מפות תכונות קטנות שמתארות "מה יש בתמונה" במקום "מה הערך של כל פיקסל". רק אז משטחים את הפלט ומעבירים אותו לשכבות לינאריות לסיווג, כפי שהכרנו — החלק הזה של הרשת זהה לרשתות מהפרקים הקודמים.
דוגמה לרשת וחישוב הממדים
ברשת הבאה שתי קונבולוציות ושלוש שכבות לינאריות. זהו מבנה הרשת שנממש בהמשך על תמונות CIFAR-10 בגודל 3×32×32. הקונבולוציה הראשונה מפעילה שישה מסננים 5×5 על שלושת ערוצי הצבע, והשנייה מפעילה 16 מסננים על שש מפות התכונות שיצאו מהראשונה. ההערות בקוד מציינות את צורת הנתונים אחרי כל שלב, כש־n הוא מספר התמונות באצווה. את ReLU נגדיר הפעם כשכבה, nn.ReLU(), בתוך __init__ לצד שאר השכבות, ונפעיל אותה ב־forward כמו כל שכבה אחרת; זו דרך נוספת לכתוב את אותה אקטיבציה, במקום הפונקציה F.relu שבה השתמשנו קודם. לשכבת ReLU אין פרמטרים, ולכן מספיק להגדיר אותה פעם אחת ולהשתמש בה בכל מקום ברשת:
class CNN_Model(nn.Module):
    def __init__(self):
        super(CNN_Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.relu = nn.ReLU()
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        # -> n, 3, 32, 32
        x = self.pool(self.relu(self.conv1(x)))  # -> n, 6, 14, 14
        x = self.pool(self.relu(self.conv2(x)))  # -> n, 16, 5, 5
        x = x.view(-1, 16 * 5 * 5)               # -> n, 400
        x = self.relu(self.fc1(x))               # -> n, 120
        x = self.relu(self.fc2(x))               # -> n, 84
        x = self.fc3(x)                          # -> n, 10
        return x
| שלב | צורת הנתונים לתמונה אחת |
|---|---|
| קלט | 3×32×32 |
| קונבולוציה ראשונה | 6×28×28 |
| Pooling | 6×14×14 |
| קונבולוציה שנייה | 16×10×10 |
| Pooling | 16×5×5 |
| השטחה | 400 |
| שכבות לינאריות | 120 → 84 → 10 |
למשל, הקונבולוציה הראשונה נותנת floor((32−5)/1)+1=28, ואחריה Pooling נותנת floor((28−2)/2+1)=14. באותו אופן הקונבולוציה השנייה מקטינה את 14 ל־10 וה־Pooling ל־5. לכן אחרי ההשטחה יש לכל תמונה 16 מפות של 5×5, כלומר 400 ערכים — וזה המספר שחייב להופיע כמספר הקלטים של fc1. אם היינו טועים בחישוב, השכבה הלינארית הייתה מקבלת קלט בגודל לא מתאים והתוכנית הייתה נכשלת.
CIFAR-10
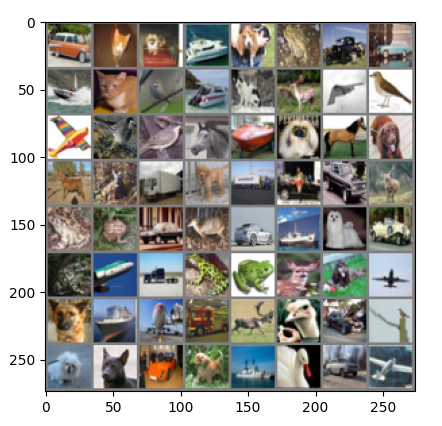
מהתיאוריה נעבור למימוש מלא. CIFAR-10 הוא מאגר של תמונות צבעוניות קטנות, ובניגוד לספרות ולפריטי לבוש בגוני אפור, אלה תמונות של עצמים אמיתיים בצבע, ברקעים שונים ובזוויות שונות — משימה קשה בהרבה לרשת רגילה, ובדיוק המקרה שרשת קונבולוציה נועדה לו. נבנה רשת לסיווג תמונות צבעוניות בגודל 32×32 לעשר קטגוריות: מטוס, מכונית, ציפור, חתול, אייל, כלב, צפרדע, סוס, ספינה ומשאית. במאגר 50,000 תמונות אימון ו־10,000 תמונות בדיקה; הנה דוגמה למה שיש בו:
נייבא את הספריות:
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt
import torchvision
import torchvision.transforms as transforms
נבחר התקן חישוב:
if torch.cuda.is_available():
    device = torch.device('cuda')
else:
    device = torch.device('cpu')
print(device)
טעינה ללא נרמול
נבחן תחילה את ייצוג התמונה לפני הוספת הנרמול, כדי לראות במו עינינו את מה שתיארנו בתחילת הפרק. נטען תמונות באמצעות ToTensor בלבד ונדפיס תמונה אחת ואת צורתה; נצפה לטנסור בצורה 3×32×32, שלושה ערוצי צבע של 32 שורות ו־32 עמודות, עם ערכים בין 0 ל־1:
batch_size = 4
transform = transforms.Compose([
    transforms.ToTensor()
    ])
test_dataset = torchvision.datasets.CIFAR10(root='./data',
                                            transform=transform,
                                            train=False,
                                            download=True
                                            )
test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle=False)
examples = iter(test_loader)
example = next(examples)
ex1 = example[0][0]
print(ex1)
print (ex1.shape)
אם הורדת הנתונים נכשלת, אפשר להשתמש בחלופת Hugging Face שמופיעה בהמשך סעיף הטעינה.
נרמול התמונות
כמו בכל רשת, גם כאן נרצה קלט מנורמל סביב האפס, כדי שהאימון יתכנס בקלות. ToTensor ממירה את ערכי התמונה מ־0–255 לטווח 0–1. Normalize מחסרת 0.5 ומחלקת ב־0.5 בכל ערוץ, כך שמתקבל הטווח −1 עד 1. שני השלבים משורשרים ב־Compose, ויופעלו אוטומטית על כל תמונה בזמן הטעינה:
# ToTensor maps these image values to [0, 1].
# We transform them to Tensors of normalized range [-1, 1]
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize(mean=(0.5, 0.5, 0.5),std= (0.5, 0.5, 0.5))
    ])
נטען את קבוצות האימון והבדיקה עם הנרמול, וניצור אצוות של 20 תמונות; קבוצת האימון מעורבבת וקבוצת הבדיקה לא:
batch_size = 20

train_dataset = torchvision.datasets.CIFAR10(root='./data',
                                           train=True,
                                           transform=transform,
                                           download=True)

test_dataset = torchvision.datasets.CIFAR10(root='./data',
                                          train=False,
                                          transform=transform)

# Data loader
train_loader = torch.utils.data.DataLoader(dataset=train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True)

test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle=False)
חלופת טעינה באמצעות Hugging Face
לעיתים ההורדה מהשרת של torchvision נכשלת. במקרה כזה אפשר להוריד את אותו מאגר מ־Hugging Face, אתר שמרכז מאגרי נתונים ומודלים. חלופה זו מחליפה את טעינת הנתונים באמצעות torchvision ומצריכה את הספרייה datasets; מי שהטעינה הרגילה עבדה אצלו יכול לדלג על סעיף זה:
from datasets import load_dataset

dataset = load_dataset("cifar10")

# Convert to PyTorch-style
train_dataset = dataset["train"]
test_dataset = dataset["test"]
המאגר שהתקבל מ־Hugging Face אינו באותו מבנה שמצפה לו DataLoader, ולכן נעטוף אותו במחלקה שיורשת מ־Dataset ומממשת את שתי הפעולות שהטוען זקוק להן: __len__ (כמה דוגמאות יש) ו־__getitem__ (החזרת תמונה ותווית לפי אינדקס, אחרי הפעלת ה־transform). לאחר מכן ניצור מחדש את הטוענים, ושאר הפרק ימשיך ללא שינוי:
from torch.utils.data import Dataset

# Create a PyTorch Dataset wrapper to mimic torchvision exactly
class HFDatasetWrapper(Dataset):
    def __init__(self, hf_dataset, transform=None):
        self.hf_dataset = hf_dataset
        self.transform = transform
        # Add the .classes attribute that torchvision datasets have
        self.classes = hf_dataset.features['label'].names

    def __len__(self):
        return len(self.hf_dataset)

    def __getitem__(self, idx):
        item = self.hf_dataset[idx]
        image = item['img'].convert("RGB")
        label = item['label']

        if self.transform:
            image = self.transform(image)

        return image, label

    def __repr__(self):
        head = "Dataset CIFAR10 (Hugging Face)"
        body = [f"Number of datapoints: {self.__len__()}"]
        if self.transform is not None:
            body.append(f"StandardTransform\nTransform: {self.transform}")
        lines = [head] + ["    " + line for line in body]
        return '\n'.join(lines)

# Wrap the original Hugging Face dataset splits
# ('dataset' is from the previous cell, 'transform' from earlier)
train_dataset = HFDatasetWrapper(dataset['train'], transform=transform)
test_dataset = HFDatasetWrapper(dataset['test'], transform=transform)

# Data loader - behaves completely normally now!
train_loader = torch.utils.data.DataLoader(dataset=train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True)

test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle=False)

print("Hugging Face dataset wrapped to behave exactly like torchvision!")
הצגת התמונות
כדאי תמיד להסתכל על הנתונים לפני שמאמנים עליהם. אבל התמונות שבידינו מנורמלות לטווח −1 עד 1, ו־PyTorch שומר אותן בסדר ערוצים־שורות־עמודות, בעוד matplotlib מצפה לערכים בטווח 0–1 ולסדר שורות־עמודות־ערוצים. כדי להציג את התמונות בצבעיהן הרגילים, נתאים בחזרה את הערכים (כפל ב־0.5 והוספת 0.5 — ההפך מהנרמול) ואת סדר הצירים באמצעות transpose. נגדיר פונקציה שמבצעת זאת:
def imshow(img):
    img = img / 2 + 0.5  # unnormalize
    npimg = img.numpy()
    plt.imshow(np.transpose(npimg, (1, 2, 0)))
    plt.show()
נציג שלוש אצוות, בחמש תמונות לשורה; make_grid מסדרת את 20 תמונות האצווה בתמונה אחת גדולה:
# get some random training images
dataiter = iter(train_loader)
for i in range(3):
    images, labels = next(dataiter)

    # show images
    imshow(torchvision.utils.make_grid(images, nrow=5))
פלט
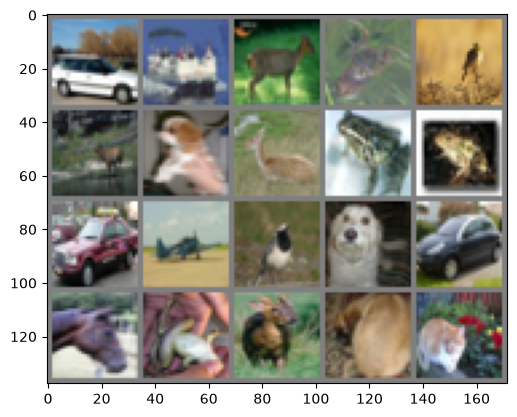
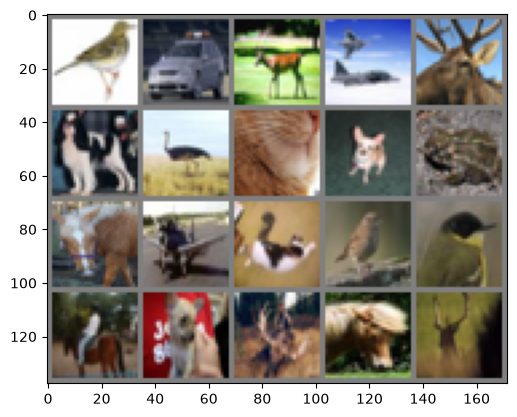
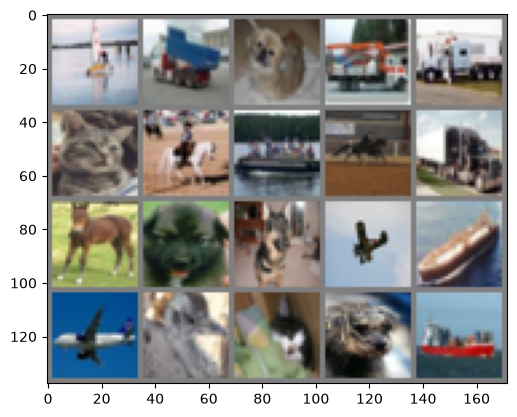
נבדוק את מבנה המאגר, תמונה אחת ותוויתה, ונגדיר את שמות הקטגוריות. התווית במאגר היא מספר בין 0 ל־9, והטאפל classes מתרגם אותו לשם — האינדקס 3, למשל, הוא cat:
print(train_dataset, '\nlength=',len(train_dataset))
print(type(train_dataset[0]), len(train_dataset[0]))
print(type(train_dataset[0][0]), type(train_dataset[0][1]) )
print(train_dataset[0][0].shape)
print(train_dataset[0][0])
print(train_dataset[0][1])
classes = ('plane', 'car', 'bird', 'cat', 'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
print(train_dataset.classes)
פרמטרים ומודל
כעת נרכיב את הרשת שמבנהּ הוצג קודם ונגדיר את פרטי האימון. נאמן במשך חמש תקופות בקצב למידה 0.001:
epochs = 5
learning_rate = 0.001
נממש את רשת הקונבולוציה — זו בדיוק המחלקה שניתחנו בסעיף "דוגמה לרשת וחישוב הממדים". ההשטחה, באמצעות view, מתבצעת רק אחרי שתי הקונבולוציות וה־Pooling, כשלכל תמונה נותרו 400 ערכים; שכבת הפלט מחזירה עשרה ציונים גולמיים, אחד לכל קטגוריה:
class CNN_Model(nn.Module):
    def __init__(self):
        super(CNN_Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.relu = nn.ReLU()
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        # -> n, 3, 32, 32
        x = self.pool(self.relu(self.conv1(x)))  # -> n, 6, 14, 14
        x = self.pool(self.relu(self.conv2(x)))  # -> n, 16, 5, 5
        x = x.view(-1, 16 * 5 * 5)               # -> n, 400
        x = self.relu(self.fc1(x))               # -> n, 120
        x = self.relu(self.fc2(x))               # -> n, 84
        x = self.fc3(x)                          # -> n, 10
        return x


Model = CNN_Model().to(device)
נגדיר את פונקציית ההפסד CrossEntropyLoss ואת האופטימייזר Adam, כמו בסיווג רב־קטגוריות בפרקים הקודמים; CrossEntropyLoss מפעילה בעצמה Softmax, ולכן אין להוסיף Softmax לשכבת הפלט לפני ההפסד:
# loss function
Loss = nn.CrossEntropyLoss () # applies nn.LogSoftmax + nn.NLLLoss, No softmax in last layer

# init optimizer
optim = torch.optim.Adam(Model.parameters(), lr=learning_rate)
אימון
לולאת האימון זהה לזו של הרשתות הקודמות, בהבדל אחד בולט: אין בה reshape של התמונות לווקטור. התמונות נכנסות לרשת בצורתן המקורית, n×3×32×32, והרשת עצמה משטחת אותן במקום הנכון. בכל אצווה נעביר את התמונות והתוויות להתקן ונבצע חישוב קדימה, חישוב הפסד ונגזרות, עדכון משקלים ואיפוס גרדיאנטים. שימו לב שהאימון כאן איטי יותר מברשתות הקודמות — הקונבולוציה היא פעולה כבדה, ו־GPU מאיץ אותה משמעותית:
n_total_steps = len(train_loader)


for epoch in range(epochs):
    for i, (images, lables) in enumerate(train_loader):

        images = images.to(device)
        lables = lables.to(device)

        # forward
        Y_predict = Model(images)

        # backward
        loss = Loss(Y_predict, lables)
        loss.backward()

        # update wights
        optim.step()

        if i % 100 == 0:
            print(f"epoch= {epoch} i= {i+epoch * n_total_steps} loss={loss.item():.4f} ")

        # zero grads
        optim.zero_grad()
בדיקת המודל
נמדוד את הדיוק על קבוצת הבדיקה, ללא מעקב גרדיאנטים. לכל תמונה הרשת מחזירה עשרה ציונים; נבחר את אינדקס הציון המרבי, שהוא הקטגוריה שהרשת בחרה, ונחשב את אחוז התחזיות הנכונות. אל תצפו לדיוק כמו ב־MNIST: CIFAR-10 קשה בהרבה, ורשת קטנה שאומנה חמש תקופות בלבד מגיעה לדיוק צנוע יותר:
with torch.no_grad():
    n_correct = 0
    n_samples = 0
    for images, lables in test_loader:
        images = images.to(device)
        lables = lables.to(device)
        __,y_predict = torch.max(Model(images),1)
        n_samples += lables.size(0)
        n_correct += (y_predict == lables).sum().item()

    acc = 100 * n_correct / n_samples
    print(f'Accuracy of the network on the {n_samples} test images: {acc} %')
אחוז יחיד אינו מספר לנו איפה הרשת טועה. נעבור על עשר אצוות בדיקה ונדפיס לכל תמונה את התחזית, את התווית והאם הן שוות, כדי לראות את התוצאות תמונה־תמונה:
examples = iter(test_loader)
for j in range(10):
    example_data, example_targets = next(examples)
    example_data = example_data.to(device)
    example_targets = example_targets.to(device)
    _, example_predict_arg = torch.max(Model(example_data),1)

    for i in range(len(example_data)):
        print (example_predict_arg[i].item(), example_targets[i].item(), example_predict_arg[i].item()== example_targets[i].item()  )
מספרים קשה לפרש בעין; נציג את האצווה האחרונה שנותרה מהלולאה כתמונות, ולצידן את שמות התחזיות והתוויות. כך אפשר לראות אילו טעויות "מובנות" — למשל בין בעלי חיים דומים — ואילו מפתיעות. את התמונות מעבירים חזרה ל־CPU לפני ההצגה, כי matplotlib אינו עובד עם טנסורים שעל GPU:
# Show test
def img_target_show(img):
        img = img / 2 + 0.5  # unnormalize
        npimg = img.numpy()
        plt.imshow(np.transpose(npimg, (1, 2, 0)))
        plt.show()

print('target\n',example_targets.reshape(-1,5))
print('predict\n',example_predict_arg.reshape(-1,5) )

imshow(torchvision.utils.make_grid(example_data.to('cpu'),nrow=5))
for i in range(4):
    for j in range (5):
        print(classes[example_targets[i*5+j]], classes[example_predict_arg[i*5+j]])
לסיום נדפיס את שמות הקטגוריות כפי שהם שמורים במאגר עצמו, כדי לוודא שהסדר שלהם תואם את הטאפל classes שהגדרנו:
print(train_dataset.classes)