ד.8 — מונטה קרלו באיקס עיגול — טבלת Q וקוד האימון
המצגת: מונטה קרלו באיקס עיגול · השיעור באתר הקורס · קוד: ענף התרגיל main · ענף הפתרון solved · MC_Trainer.py · AI_Agent.py · TicTacToe.py · State.py
בפרק הקודם בנינו את אלגוריתם מונטה קרלו בפסאודו־קוד: משחקים אפיזודה שלמה, מחשבים תשואות מהסוף להתחלה ומעדכנים טבלת Q. עכשיו נממש אותו על איקס עיגול. במשחק הזה יש לכל היותר 39 = 19,683 סידורי לוח, ובפועל פחות, כי לא כל סידור חוקי; מרחב קטן כזה אפשר היה לפתור גם בתכנון דינמי, אבל אנחנו נאמן את הסוכן מהתנסות בלבד, בלי מודל של היריב. הסוכן שלנו ישחק את השחקן הראשון, X, ויתאמן מול סוכן אקראי. זו הפעם הראשונה בחלק ד שסוכן לומד ממשחקים אמיתיים, ובסוף הפרק נמדוד כמה טוב הוא משחק.
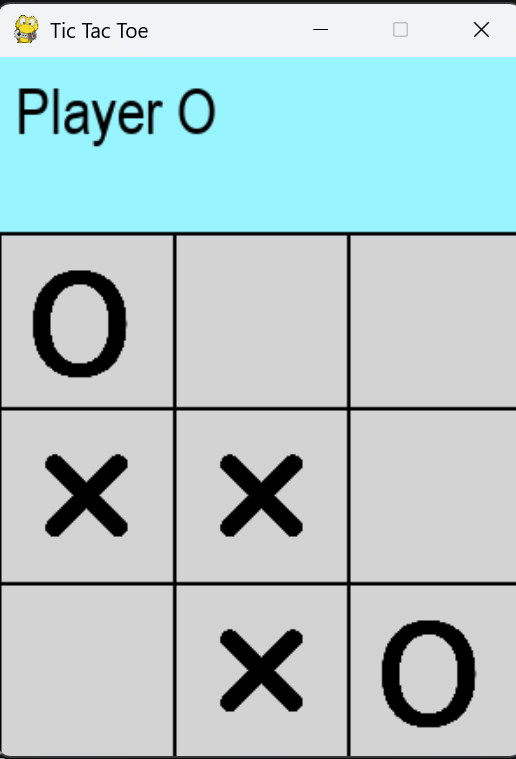
הפרק הזה הוא תרגיל, כמו פרק הפאזל: תחילה נכיר את המשחק הנתון ואת הממשק שלו, ואחר כך נראה איך שומרים את טבלת Q במילון ומה נדרש כדי שלוח שלם ישמש בו מפתח (על מילונים וגיבוב עצמם למדנו בחלק א, ורק נפנה לשם). אז יבואו השלד להשלמה, המשימה, הפתרון וההרצה.
המשחק הנתון — מאגר Tic_Tac_Toe_2
במאגר Tic_Tac_Toe_2 בגיטהב נתון משחק איקס עיגול שלם לפי מודל סוכן–סביבה, עם גרפיקה ב־pygame. הענף main הוא גרסת התרגיל, ובו קטעי הקוד להשלמה מסומנים בהערות בעברית; הענף solved הוא הפתרון. אלה הקבצים:
| קובץ | תפקיד |
|---|---|
Graphics.py |
קבועים (מידות, צבעים, FPS) וציור הלוח בחלון |
State.py |
המצב: הלוח כטבלת numpy בגודל 3×3, תור השחקן ותוצאת המשחק |
TicTacToe.py |
הסביבה: ביצוע מהלך, בדיקת חוקיות, חישוב המצב הבא והתגמול, בדיקת סיום |
Human_Agent.py |
סוכן אנושי: לחיצת עכבר על משבצת |
Random_Agent.py |
סוכן אקראי: משבצת פנויה אקראית; זה היריב באימון |
Random_Agent_Advanced.py |
יריב אקראי משופר: מנצח אם אפשר, חוסם אם צריך, ואחרת משחק באקראי; היריב בענף הפתרון |
AI_Agent.py |
הסוכן הלומד, ובו טבלת Q; משלימים בו את ε-greedy |
MC_Trainer.py |
האימון במונטה קרלו; משלימים בו את איסוף האפיזודה ואת לולאת האימון |
Tester.py |
1,000 משחקי בדיקה של סוכן מאומן, ללא גרפיקה |
Game.py |
משחק בחלון: הסוכן המאומן נגד שחקן אנושי |
Data/ |
טבלאות Q שמורות |
SARSA_Trainer.py |
אימון בשיטה שנלמד בפרקים הבאים |
המצב — State. הלוח הוא טבלת numpy בגודל 3×3: 1 עבור X, −1 עבור O ו־0 למשבצת ריקה. player הוא השחקן שתורו כעת (1 או −1), ו־end_of_game מחזיק את תוצאת המשחק: 0 כל עוד המשחק נמשך, 1 לניצחון X, −1 לניצחון O ו־2 לתיקו.
import numpy as np

class State:
    def __init__(self, board = None, player = 1):
        if board is not None:
            self.board = board
        else:
            self.board = self.init_board()
        self.player = player
        self.end_of_game = 0

    def init_board(self):
        board = np.zeros((3,3))
        # board[1,1] = 1
        # board[0,0] = -1
        return board

    def reset (self):
        self.board = self.init_board()
        self.player = 1
        self.end_of_game = 0

    def switch_players (self):
        if self.player == 1:
            self.player = -1
        else:
            self.player = 1

    def __eq__(self, other) ->bool:
        # b1 = np.equal(self.board, other.board).all()
        return np.equal(self.board, other.board).all()

    def __hash__(self) -> int:
        return hash(tuple(self.board.astype(np.int8).ravel()))

    def copy (self):
        newBoard = np.copy(self.board)
        return State(board=newBoard, player=self.player)

    def __str__(self) -> str:
        return str(self.board)
__eq__ קובעת ששני מצבים שווים כאשר הלוחות שלהם זהים תא בתא, ו־copy מחזירה מצב חדש עם העתק של הלוח. את __hash__ נסביר בהמשך הפרק: היא מה שמאפשר למצב לשמש מפתח במילון.
הסביבה — TicTacToe. שלוש שיטות משרתות את האימון. next_state(state, action) היא המודל של צעד אחד: היא מעתיקה את המצב, מניחה את הסימן של השחקן שתורו במשבצת שנבחרה, מעבירה את התור, בודקת אם המשחק הסתיים ומחזירה את המצב החדש ואת התגמול. end_of_game(state) בודקת סיום ומעדכנת את state.end_of_game, ו־move(action) מבצעת מהלך על המצב האמיתי של המשחק, בשביל Game.py:
    def next_state (self, state: State, action):
        next_state = state.copy()
        next_state.board[action] = state.player
        next_state.switch_players()
        self.end_of_game(next_state)
        if next_state.end_of_game == 2:
            reward = 0
        else:
            reward = next_state.end_of_game
        return next_state, reward

    def end_of_game (self, state: State):
        board = state.board
        row_sum = np.sum(board, axis=1)
        col_sum = np.sum(board, axis=0)
        diagonals = [np.trace(board), np.trace(np.fliplr(board))]
        piece_num =  np.count_nonzero(board)

        # print (f'row_sum: {row_sum} col_sum: {col_sum} diagonals: {diagonals} piece_num: {piece_num}')
        if 3 in row_sum or 3 in col_sum or 3 in diagonals:
            state.end_of_game = 1
            return True
        if -3 in row_sum or -3 in col_sum or -3 in diagonals:
            state.end_of_game = -1
            return True
        if piece_num == 9:
            state.end_of_game = 2
            return True
        return False
בדיקת הסיום נשענת על הייצוג המספרי: שורה, עמודה או אלכסון שסכומם 3 הם שלושה X, וסכום −3 הוא שלושה O; תשעה סימנים בלי מנצח הם תיקו. התגמול הוא מנקודת המבט של X: 1 לניצחון, −1 להפסד, 0 לתיקו ולכל מהלך שבו המשחק נמשך. לכן תגמול 0 לבדו אינו אומר אם המשחק נגמר, ובודקים סיום בנפרד. פעולה היא זוג (row, col), כשמספור השורות והעמודות מתחיל באפס, ורשימת הפעולות החוקיות היא המשבצות שבהן 0; את הרשימה הזאת מחשב הסוכן בעצמו ב־legal_actions.
| קריאה או שדה | המשמעות באימון |
|---|---|
State() |
לוח ריק, תור X |
env.next_state(state, action) |
מצב חדש ותגמול לאחר מהלך אחד; המצב הישן נשמר |
env.end_of_game(state) |
האם המשחק הסתיים |
state.end_of_game |
0 למשחק ממשיך, 1 לניצחון X, −1 לניצחון O, 2 לתיקו |
agent.legal_actions(state) |
רשימת המשבצות הפנויות כזוגות (row, col) |
היריב — Random_Agent. np.where(board == 0) מחזירה את מיקומי המשבצות הריקות, zip מחבר אותם לזוגות, ו־random.choice בוחר אחד מהם:
    def get_action(self, events=None, state = None, epoch=None):
        if state is None:
            state = self.env.state
        board = state.board
        indices = np.where(board == 0)
        actions = list(zip(indices[0], indices[1]))
        action = random.choice(actions)
        return action
היריב המשופר — Random_Agent_Advanced. בענף הפתרון יש יריב נוסף, שחושב צעד אחד קדימה. בכל תור הוא בודק שני דברים בעזרת find_winning_action: האם יש לו משבצת שמשלימה לו שלשה, ואם כן הוא מנצח; ואם לא, האם ל־X יש משבצת כזאת, ואם כן הוא חוסם אותה. רק אם אין לא ניצחון ולא חסימה הוא בוחר משבצת פנויה באקראי. כדי שלא יהיה צפוי לגמרי, באחד מכל חמישה מהלכים (random_step = 5) הוא מדלג על הבדיקה ומשחק באקראי בכל מקרה:
    def get_action(self, events=None, state = None, epoch=100, train=False, random_step = 5):
        if state is None:
            state = self.env.state
        board = state.board
        win_action = self.find_winning_action(board=board, player=self.player)
        block_action = self.find_winning_action(board=board, player=-self.player)
        if random.random() > 1/random_step:
            if win_action:
                return win_action
            if block_action :
                return block_action
        indices = np.where(board == 0)
        actions = list(zip(indices[0], indices[1]))
        action = random.choice(actions)
        return action
find_winning_action סורקת את השורות, העמודות והאלכסונים ומחפשת קו שבו לשחקן הנתון שני סימנים ומשבצת ריקה אחת; היא מחזירה את המשבצת הזאת, או None אם אין כזאת. יריב כזה מפגיש את הסוכן עם מצבים קשים יותר מיריב אקראי לגמרי: הוא לא נותן לנצח בקלות ומעניש טעויות.
נקודה חשובה: מנקודת מבטו של הסוכן הלומד, תגובת היריב היא חלק מ״הסביבה״, בדיוק כמו החלקה על כביש חלק בדוגמה מהפרק הקודם. לכן צעד למידה אחד יכלול את הפעולה של X ואת תגובת O, אם המשחק לא הסתיים קודם; המצב הבא של צעד למידה הוא מצב שבו X שוב צריך לבחור, או מצב סופי.
מימוש Q-Table — מילון של מצב–פעולה וערך
בפרק הקודם דיברנו על ״טבלת Q״ באופן כללי. עכשיו צריך להחליט איך לשמור אותה בזיכרון. מערך דו־ממדי אינו מתאים: המצבים אינם מספרים רצים אלא לוחות, ואיננו יודעים מראש באילו מהם נבקר. מבנה הנתונים המתאים הוא מילון (dict), שהכרנו בפרק א.11 והשתמשנו בו בפרק הפאזל: המפתח יהיה זוג (state, action), והערך המספר של אותו מצב–פעולה:
Q = dict()
state = State()
action = (1, 1)
Q[(state, action)] = 0.7
value = Q.get((state, action), 0)
המפתח בדוגמה מתאר בחירה במרכז מתוך לוח ריק. תזכורת: אם המפתח כבר קיים במילון, ההשמה מעדכנת את ערכו, ואין כפילויות; אם אינו קיים, הוא מתווסף עם הערך הנתון. Q.get(key, 0) מחזירה 0 אם המפתח עדיין אינו במילון, ולכן אין צורך למלא את הטבלה מראש: זוג מקבל שורה בפעם הראשונה שפונים אליו. במשחקי לוח אפשר גם לחשוב על המצב–פעולה כעל הלוח שאחרי הפעולה, לוח ריק ובמרכזו X; המצב הבא s′ כבר תלוי במהלך של השחקן השני.
State כמפתח — פונקציית גיבוב לאובייקטים
כדי שערך כלשהו יוכל לשמש מפתח במילון, חייבת להיות לו פונקציית גיבוב (hash). זה הכלל היחיד שחשוב לנו כאן, ונזכיר בקצרה מה עומד מאחוריו (ההסבר המלא בפרק א.17).
מהי פונקציית גיבוב. מילון בפייתון הוא טבלת גיבוב: מערך של תאים. פונקציית הגיבוב מקבלת ערך ומחזירה מספר שלם, והמספר הזה קובע באיזה תא בטבלה יישמר הזוג. כשמכניסים מפתח למילון, פייתון מחשב ממנו את המספר ומניח את הזוג בתא המתאים; כשמחפשים מפתח, הוא מחשב שוב את אותו מספר וניגש ישירות לאותו תא, בלי לעבור על שאר המפתחות. לכן חיפוש והכנסה מהירים גם במילון של מיליוני זוגות, וזה מה שמאפשר לנו לפנות ל־Q מיליוני פעמים באימון. הדרישה הבסיסית מפונקציית גיבוב היא ששני ערכים שווים יקבלו תמיד אותו מספר; אחרת אותו מפתח ״ילך לאיבוד״ בתא אחר.
למספרים, למחרוזות ול־tuple יש בפייתון פונקציית גיבוב מוכנה, ולכן הם משמשים מפתחות בלי מאמץ; זו הסיבה שבפאזל המרנו את הלוח ל־tuple. אבל State היא מחלקה שלנו, ולאובייקט של מחלקה משלנו פייתון אינו יודע לחשב מספר מתוך התוכן. לכן עלינו להגדיר בעצמנו את פונקציית הגיבוב שלו, ואיתה גם את ההשוואה בין שני מצבים. לשם כך משמשות שתי המתודות המיוחדות שראינו ב־State.py:
    def __eq__(self, other) ->bool:
        # b1 = np.equal(self.board, other.board).all()
        return np.equal(self.board, other.board).all()

    def __hash__(self) -> int:
        return hash(tuple(self.board.astype(np.int8).ravel()))
ravel פורסת את הלוח לשורה של תשעה מספרים, tuple הופכת אותה ל־tuple, ו־hash של פייתון מחשבת ממנו את המספר. המילון קורא לשתי המתודות בעצמו בכל פנייה למפתח: __hash__ אומרת לו באיזה תא לחפש, ו־__eq__ בודקת אם המפתח שנמצא שם הוא אכן אותו מצב. מצבים שווים חייבים לקבל אותו hash, ולכן שתיהן מסתמכות על אותו לוח. כך אותו לוח, שיופיע באימון פעמים רבות כאובייקטים שונים שנוצרו ב־next_state, מגיע תמיד לאותה שורה ב־Q.
כלל אחד חשוב: אין לשנות את תוכנו של מצב לאחר ששימש מפתח, אחרת הגיבוב ישתנה והמילון לא ימצא אותו. הלוח הוא טבלת numpy, שאפשר לשנות, ולכן קוד האימון שומר באפיזודה state.copy() ולא את המצב עצמו.
השלד להשלמה
בענף main שני קבצים ממתינים להשלמה. הראשון הוא הסוכן, AI_Agent.py:
from TicTacToe import TicTacToe
import numpy as np
from Graphics import *
import torch
import math
import random

class AI_Agent:
    def __init__(self, player, env: TicTacToe, graphics: Graphics = None, Q_table_PATH = None, train = True):
        self.env = env
        self.player = player
        if Q_table_PATH is None:
            self.Q = dict ()
        else:
            self.load_Q(Q_table_PATH)
        self.train = train

    def get_Q (self, state, action):
        if (state, action) in self.Q:
            return self.Q[(state, action)]
        else:
            return 0

    # greedy action
    def get_Q_action(self, state = None):
        if state is None:
            state = self.env.state
        actions = self.legal_actions(state)
        best_value = -10
        best_action = None
        for action in actions:
            key = (state, action)
            Q_value = self.Q.get((state, action),0)
            if Q_value > best_value:
                best_value = Q_value
                best_action = action

        return best_action

    # epsilon-greedy
    def get_action (self, state, epoch = None):
        if self.train:
            r = random.random()
            epsilon = self.epsilon_greedy(epoch)
        else:
            r = 1
            epsilon = 0
        if r < epsilon:
            action = random.choice(self.legal_actions(state))
        else:
            action = self.get_Q_action(state = state)
        return action

    def legal_actions (self, state):
        board = state.board
        indices = np.where(board == 0)
        actions = list(zip(indices[0], indices[1]))
        return actions

    def load_Q (self, PATH):
        self.Q = torch.load(PATH, weights_only=False)

    def save_Q (self, PATH):
        torch.save(self.Q, PATH)

    def epsilon_greedy (self, epoch)-> float:
        start = 1.0
        final = 0.01
        decay = 100

        '''
        עליכם לממש את הפונקציה אפסילון גרידי.
        ניתן לממש כפונקציה לינארית או מעריכית, לבחירתכם.

        '''

    def __call__(self, events= None, state=None):
        return self.get_action(state)
כמעט הכול כתוב. get_Q מחזירה את הערך של זוג, או 0 אם עדיין אינו בטבלה. get_Q_action היא הבחירה החמדנית: עוברת על הפעולות החוקיות ומחזירה את זו עם Q הגבוה ביותר, בדיוק ה־argmax מהפרק הקודם. get_action היא ε-greedy: בזמן אימון מגרילה r ומשווה ל־ε שמחזירה epsilon_greedy, ובזמן משחק (train=False) ε הוא 0 ובוחרים תמיד לפי הטבלה. save_Q ו־load_Q שומרות וטוענות את המילון לקובץ. חסרה רק epsilon_greedy, פונקציית הדעיכה של ε לפי מספר האפיזודה.
השני הוא המאמן, MC_Trainer.py:
from TicTacToe import TicTacToe
from State import State
from Human_Agent import Human_Agent
from Random_Agent import Random_Agent
from AI_Agent import AI_Agent

PATH = 'Data/Q_MC_4.pth'

env = TicTacToe(State())
player1 = AI_Agent(1, env, graphics=None, Q_table_PATH=None)
player2 = Random_Agent(-1, env,graphics=None)

gamma = 0.9

def main ():
    player = player1

    '''
    השלימו את הקוד המאמן את הסוכן לפי אלגוריתם מנטו קרלו

    חובה להשתמש בפונקציה
    Generate_episode
    '''


    player.save_Q(PATH)
    print(test(100))

def Generate_episode (player, epoch):
    episods = []

    '''
    השלימו את הקוד היוצר רשימה של צעדים מתחילת משחק ועד לסיומו.

    מבנה הרשימה:
    episods = [(state, action, reward), (state, action, reward), ...]

    ניתן להשתמש בפונקציה אפסילון-גרידי מתוך הסוכן החכם, אותו עליכם לבנות.
    '''

    return episods

def test (num):
    x_win = 0
    o_win = 0
    tie = 0
    player = player1
    player.train=False
    player.load_Q(PATH)
    for n in range(num):
        player = player1
        state = State()
        while not env.end_of_game(state):
            action = player.get_action(state=state)
            state, _ = env.next_state(state,action)
            player = switch_players(player)
        if state.end_of_game == 1:
            x_win +=1
        elif state.end_of_game == -1:
            o_win += 1
        else:
            tie +=1
        state.reset()
        print(n, end = "\r")
    return x_win, o_win, tie

def print_episodes (episode):
    for i, e in enumerate(episode):
        print(f'\n i= {i} player = {e[0].player} ')
        for i in e:
            print (i, end=" ")

def switch_players(player):
    if player == player1:
        return player2
    else:
        return player1

if __name__ == '__main__':
    main()
    # print(test(100))
הקובץ יוצר סביבה, סוכן לומד שמשחק X (player1) ויריב אקראי שמשחק O (player2), וקובע γ. test(num) כבר כתובה: היא טוענת את הטבלה השמורה, מכבה את החקירה (train=False), משחקת num משחקים מול היריב האקראי לפי הטבלה בלבד, וסופרת ניצחונות של X, ניצחונות של O ותיקו. שתי הפונקציות להשלמה הן Generate_episode, שמשחקת משחק אחד ומחזירה את רשימת הצעדים, ו־main, לולאת האימון.
לפני ההשלמה אפשר לראות את היעד: Game.py בענף התרגיל טוען טבלת Q מאומנת מן הקובץ Data/Q_MC_3.pth ומעמיד את הסוכן, כ־X, מול שחקן אנושי. הריצו אותו ונסו לנצח.
המשימה. עצרו כאן ונסו לפתור לבד לפי הפסאודו־קוד מהפרק הקודם, לפני שתמשיכו לפתרון:
- ממשו את
epsilon_greedy(epoch)ב־AI_Agent.py: ε יורד מ־startל־finalלאורךdecayאפיזודות, בקו ישר או בדעיכה מעריכית, לבחירתכם. שימו לב ש־decayבשלד הוא 100; לאימון של מאות אלפי משחקים כדאי ערך גדול בהרבה. - ממשו את
Generate_episode(player, epoch): מתחילים מלוח ריק, וכל עוד המשחק לא הסתיים X בוחר פעולה ב־player.get_action(state=state, epoch=epoch), הסביבה מבצעת אותה, ואם המשחק נמשך היריב מגיב ב־player2.get_action(state=...). לכל צעד שומרים ברשימה את המצב שלפני הפעולה של X (עותק!), את הפעולה ואת התגמול שהתקבל אחרי תגובת היריב. - ממשו את
main: לולאה שלepochsאפיזודות; בכל אחתGenerate_episode, ואז מעבר על הצעדים מהסוף להתחלה עםG = gamma*G + rewardועדכוןplayer.Q[(state, action)]לפי כלל מונטה קרלו עם α קטן. - הריצו את
MC_Trainer.py. בסיום מודפסת תוצאתtest(100): כמה משחקים ניצח הסוכן מתוך 100? אחר כך הריצו אתGame.pyעם הקובץ החדש ושחקו נגדו. - תרגיל נוסף: שנו את הקוד ובנו סוכן שמשחק את השחקן השני, O. שימו לב שהתגמול שמחזירה הסביבה הוא מנקודת המבט של X, ושהמצב שבו O בוחר הוא הלוח אחרי המהלך של X.
TicTacToe מבצעת ב־next_state מהלך אחד בלבד, של השחקן שתורו, ואינה יודעת דבר על יריבים; היריב הוא אובייקט נפרד, player2, עם get_action משלו. לכן את היריב צריך להפעיל בעצמנו בתוך Generate_episode: אחרי המהלך של X בודקים אם המשחק נגמר, ואם לא, קוראים ליריב, מבצעים את המהלך שלו, ורק אז יש לנו את המצב הבא ואת התגמול של צעד הלמידה. כלומר צעד אחד ברשימת האפיזודה הוא זוג מהלכים, שלנו ושל היריב, בדיוק כפי שהגדרנו את ״צעד הלמידה״ בתחילת הפרק. זה ההבדל היחיד בין הפסאודו־קוד לפתרון, וזה מה שמסביר את שני המקרים שבקוד של Generate_episode.פתרון — get_Q ו־ε-greedy בסוכן
הפתרון נמצא בענף solved. בסוכן השתנו שתי שיטות. get_Q נכתבה בקצרה בעזרת get, ו־epsilon_greedy מומשה כדעיכה לינארית:
    def get_Q (self, state, action):
        # if (state, action) in self.Q:
        #     return self.Q[(state, action)]
        # else:
        #     return 0
        return self.Q.get((state, action), 0)
    def epsilon_greedy (self, epoch):
        start = 1.0
        final = 0.01
        decay = 100000
        # return final + (start - final)* math.exp(-1*epoch/decay)
        if epoch > decay:
            return final
        return  start - (start - final) * epoch/decay
ε יורד בקו ישר מ־1 באפיזודה 0 ל־0.01 באפיזודה 100,000, ומשם נשאר 0.01: ב־100,000 המשחקים הראשונים הסוכן חוקר הרבה, ובמאה האלף הבאים הוא משחק כמעט רק לפי הטבלה. זו הדעיכה הלינארית מהפרק הקודם; השורה בהערה היא האפשרות המעריכית שהוזכרה שם.
פתרון — Generate_episode
def Generate_episode (player, epoch):
    episods = []
    state = State()
    while not env.end_of_game(state):
        action = player1.get_action(state=state, epoch=epoch)
        after_state, reward = env.next_state(state,action)
        if env.end_of_game(after_state):
            step = state.copy(), action, reward
            state = after_state
        else:
            action_env = player2.get_action(state=after_state)
            next_state, reward = env.next_state(after_state, action_env)
            step = state.copy(), action, reward
            state = next_state
        episods.append(step)

    episods.append((state,))
    return episods
בכל סיבוב של הלולאה X בוחר פעולה ב־ε-greedy, והסביבה מחשבת את הלוח שאחריה, after_state. יש שני מקרים. אם המשחק הסתיים במהלך של X, בניצחון או בתיקו, הצעד נשמר עם התגמול הזה ואין ליריב תור. אחרת היריב מגיב, next_state הוא הלוח שאחרי תגובתו, והתגמול הוא של המהלך שלו: −1 אם ניצח, 0 אחרת. בשני המקרים הצעד שנשמר הוא (state.copy(), action, reward): המצב שלפני הפעולה של X, הפעולה, והתגמול של צעד הלמידה כולו. הלוח שאחרי תגובת היריב הופך למצב של הצעד הבא. בסוף הרשימה נוסף המצב הסופי לבדו, (state,), בשביל print_episodes; לולאת האימון תסיר אותו לפני החישוב.
דוגמה. במשחק מהפרק הקודם, שבו X פתח במרכז, היריב הגיב בפינה, X הניח למעלה באמצע, היריב חסם, ו־X סגר את הטור וניצח, הרשימה תכיל שלושה צעדים ואת המצב הסופי: [(לוח ריק, (1,1), 0), (לוח עם X במרכז ו־O בפינה, (0,1), 0), (הלוח שלפני המהלך המנצח, (2,1), 1), (הלוח הסופי,)].
פתרון — לולאת האימון
PATH = 'Data/Q_MC_2026_2.pth'

env = TicTacToe(State())
player1 = AI_Agent(1, env, graphics=None, Q_table_PATH=None)
# player2 = Random_Agent(-1, env,graphics=None)
player2 = Random_Agent_Advanced(-1, env=env, graphics=None)

gamma = 0.95

def main ():
    player = player1
    start = 0
    epochs = 200000
    alpha = 0.01

    for epoch in range(start, epochs):
        episode = Generate_episode(player, epoch)
        G = 0
        episode.pop()
        for t in range(len(episode)):
            state, action, reward = episode.pop() # LIFO - Stack
            G = gamma* G + reward
            Q_value = player.Q.get((state, action),0) # if no key return 0
            player.Q[(state, action)] = Q_value + alpha * (G - Q_value)
        print(epoch, end="\r")

    player.save_Q(PATH)
    print(test(100))
זהו הפסאודו־קוד של הפרק הקודם, שורה בשורה. 200,000 אפיזודות, γ=0.95 ו־α=0.01: α קטן פירושו שכל משחק מזיז את הערכים רק מעט, ולכן צריך משחקים רבים; זה מתאים לסביבה שבה תוצאות של משחקים בודדים רועשות. בכל אפיזודה episode.pop() הראשון מסיר את המצב הסופי, ואז הלולאה מוציאה את הצעדים מהסוף להתחלה, כמו ממחסנית (LIFO): בכל צעד G מצטבר, G = gamma*G + reward, קוראים את הערך הנוכחי של הזוג (0 אם עדיין אינו בטבלה) ומזיזים אותו לכיוון G. בסיום הטבלה נשמרת לקובץ ומופעלת test(100).
שני פרטים שונים מגרסת התרגיל, ושניהם בחירה של הפתרון ולא חובה: γ הוא 0.95 במקום 0.9, והיריב הוא Random_Agent_Advanced, סוכן אקראי משופר שברוב המקרים סוגר שלשה כשהוא יכול וחוסם את X כשצריך, ורק לעיתים משחק באקראי. אימון מול יריב כזה מפגיש את הסוכן עם מצבים קשים יותר. הקוד עובד באותה מידה עם Random_Agent הבסיסי; די להחליף את שורת player2.
הרצה ובדיקה
הפעילו את MC_Trainer.py. בטרמינל רץ מונה האפיזודות, ובסיום מודפסת תוצאת test(100): ניצחונות X, ניצחונות O ותיקו. האימון של 200,000 המשחקים נמשך כדקה עד שתיים, לפי מהירות המחשב:
פלט
(98, 0, 2)
הסוכן ניצח 98 משחקים מתוך 100, סיים 2 בתיקו ולא הפסיד. Tester.py עושה את אותה בדיקה על 1,000 משחקים; הנה תוצאות שתי ההרצות, מול היריב המשופר של הפתרון ומול היריב האקראי הבסיסי של התרגיל (בשני המקרים הבדיקה נעשתה מול אותו יריב שמולו התאמן הסוכן):
| היריב באימון ובבדיקה | test(100) | Tester.py, 1,000 משחקים | זוגות בטבלת Q |
|---|---|---|---|
Random_Agent_Advanced |
98 ניצחונות, 0 הפסדים, 2 תיקו | 929 ניצחונות, 0 הפסדים, 71 תיקו | 7,989 |
Random_Agent |
99 ניצחונות, 0 הפסדים, 1 תיקו | 967 ניצחונות, 0 הפסדים, 33 תיקו | 8,622 |
הסוכן הגיע לכך בלי שאיש הסביר לו את חוקי איקס עיגול או אסטרטגיה כלשהי, רק מתוך תוצאות המשחקים. בטבלה יש כשמונת אלפים זוגות של מצב ופעולה, הרבה פחות מ־19,683 סידורי הלוח האפשריים: הסוכן ביקר רק במצבים שנוצרו במשחקים שלו. הרצה חוזרת תיתן מספרים מעט שונים, כי המשחקים אקראיים: בהרצה שנייה מול היריב המשופר התקבלו (92, 0, 8) ב־test(100) ו־939 ניצחונות, 0 הפסדים ו־61 תיקו ב־Tester.py. מה שחוזר בכל ההרצות הוא אפס הפסדים. שימו לב גם שהתוצאה אינה הוכחה שהסוכן אינו יכול להפסיד מול יריב אחר: הוא למד לשחק מול היריב שהתאמן מולו, ומצבים שיריב חכם יוצר אולי לא הופיעו באימון כלל.
אחרי האימון הריצו את Game.py: הוא טוען את הטבלה השמורה, הסוכן משחק X ואתם O בלחיצת עכבר. נסו להפסיד אותו.