ד.6 — Value Iteration — פאזל 8
המצגת: תכנון דינמי — המשך · השיעור באתר הקורס · קוד: ענף התרגיל main · ענף הפתרון Puzzle_Number_AI_solved · AI_Agent.py · Puzzle.py · Game.py
לוח 4×4 עם 16 מצבים נוח להסבר, אבל לא משכנע: את הטבלה שלו אפשר למלא גם ביד. בפרק הזה ניישם את Value Iteration על בעיה שאי אפשר לפתור בעיון: פאזל 8, פאזל המספרים שהכרנו בפרק ד.3. זהו לוח 3×3 ובו שמונה משבצות ממוספרות ומשבצת ריקה אחת. בכל מהלך מחליקים אל המשבצת הריקה את אחת המשבצות השכנות לה; במילים אחרות, המשבצת הריקה זזה למעלה, למטה, ימינה או שמאלה. המטרה: לסדר את המספרים 1 עד 8 לפי הסדר, כשהמשבצת הריקה בפינה הימנית התחתונה.
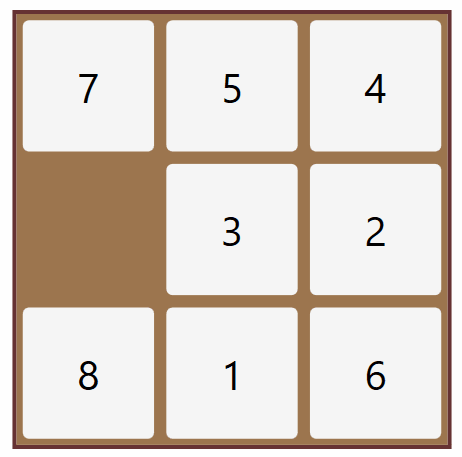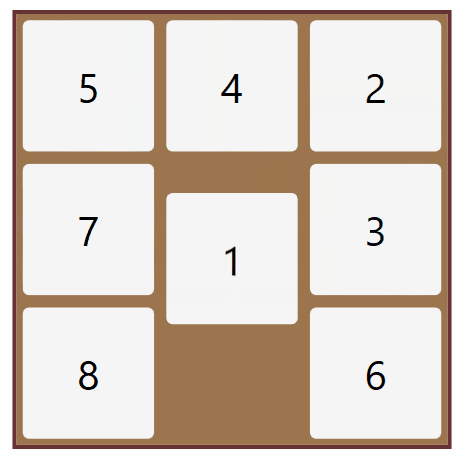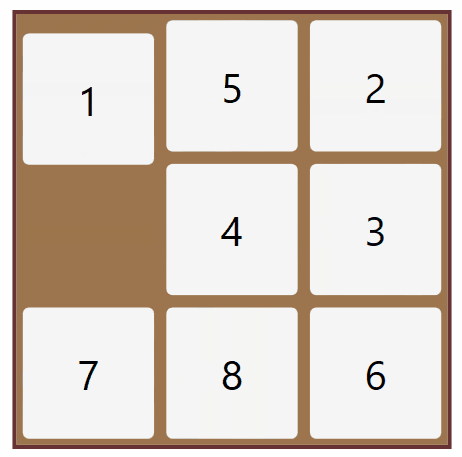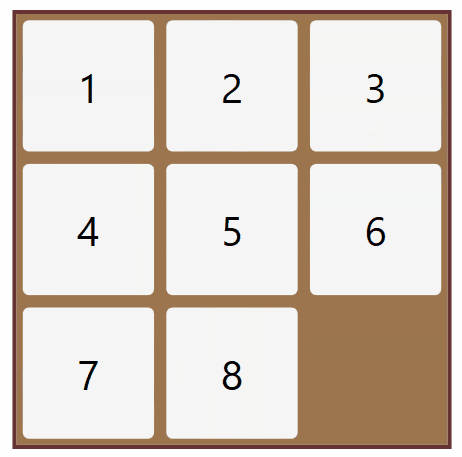
מה כאן המצב, הפעולה והמודל? בניגוד לעולם הגריד, שבו המצב היה מיקום הרובוט בתא, כאן המצב הוא סידור הלוח כולו: תשעה מספרים, אחד לכל תא. הפעולות הן ארבע הזזות של המשבצת הריקה, ולא כולן חוקיות בכל מצב: כשהריקה בשורה העליונה אי אפשר להזיז אותה למעלה. המודל ידוע במלואו: אנחנו יודעים בדיוק איזה סידור יתקבל מכל הזזה. התגמול הוא 1 בכניסה לסידור המטרה ו־0 בכל מהלך אחר, ו־γ=0.95. כל מה ש־Value Iteration צריך קיים. ההבדל היחיד הוא הגודל: לתא הראשון אפשר לבחור כל אחד מתשעה מספרים, לתא השני נשארו שמונה, לשלישי שבעה וכן הלאה, ולכן מספר הסידורים של תשעת התאים הוא 9·8·7·6·5·4·3·2·1, שמסמנים 9! וקוראים ״תשע עצרת״, והוא שווה 362,880. טבלת הערכים תצטרך שורה לכל אחד מהם.
הפרק הזה הוא תרגיל. תחילה נכיר את המשחק הנתון ואת הממשק שלו, ואחר כך את שני הכלים שהקוד משתמש בהם ושטרם פגשנו בחלק הזה, מילון ופרמוטציות. אז תבוא המשימה, ואחריה הפתרון וההרצה.
המשחק הנתון — מאגר PuzzleNumber-AI
במאגר PuzzleNumber-AI בגיטהב נתון משחק פאזל שלם לפי מודל סוכן–סביבה, עם גרפיקה ב־pygame. הענף main הוא גרסת התרגיל (הענף unsolved זהה לו למעשה), והענף Puzzle_Number_AI_solved הוא הפתרון. אלה הקבצים:
| קובץ | תפקיד |
|---|---|
constants.py |
קבועים: ROWS, COLS = 3, 3, מידות החלון וצבעים |
Action.py |
Enum בשם Action עם ארבע הפעולות: UP=1, RIGHT=2, LEFT=3, DOWN=4 |
State.py |
המצב: הלוח כטבלת numpy בגודל 3×3 ומיקום המשבצת הריקה |
Puzzle.py |
הסביבה: מצב היעד, הפעולות החוקיות, ביצוע מהלך, חישוב המצב הבא והתגמול |
Graphics.py |
ציור הלוח בחלון |
Human_Agent.py |
סוכן אנושי: מקשי החצים במקלדת |
AI_Agent.py |
הסוכן שלנו, ובו טבלת הערכים; זהו הקובץ שמשלימים |
Game.py |
לולאת המשחק |
Data/ |
טבלאות ערכים שמורות |
הבדל קטן בין הענפים: בענף התרגיל מצב היעד מוגדר ב־make_goal_state באמצעות np.arange(rows*cols), כלומר 0 עד 8 לפי הסדר והמשבצת הריקה (0) בפינה השמאלית העליונה. בפתרון, וגם בתמונות שבפרק, היעד הוא 1 עד 8 והריקה בפינה הימנית התחתונה. האלגוריתם זהה בשני המקרים; הוא מקבל את היעד מן הסביבה.
המצב — State. המחלקה קטנה, וכדאי לקרוא אותה במלואה:
import numpy as np
from constants import *

class State:
    def __init__(self, board = None):
        if board is None:
            self.board = self.make_goal_state()
            self.blank_pos = 0, 0

        else:
            self.board = board # np.array
            self.blank_pos = self.find_blank_pos()

        self.rows, self.cols = board.shape

    def get_blank_pos (self):
        return self.blank_pos

    def find_blank_pos (self):
        pos = np.where(self.board == 0)
        row = pos[0].item()
        col = pos[1].item()
        return row, col

    def make_goal_state (self, rows=ROWS, cols=COLS):
        # board = np.arange(rows*cols)
        board = np.array([1,2,3,4,5,6,7,8,0])
        board = board.reshape((rows, cols))
        return board

    def __eq__(self, other):
        return np.equal(self.board, other.board).all()

    def copy (self):
        newBoard = np.copy(self.board)
        return State (newBoard)
board היא טבלת numpy בגודל 3×3, ו־0 מסמן את המשבצת הריקה; blank_pos שומר את מיקומה, זוג (row, col). __eq__ קובעת ששני מצבים שווים כאשר הלוחות שלהם זהים תא בתא, וזה מה שמאפשר לכתוב state == goal. copy מחזירה מצב חדש עם העתק של הלוח, כדי שחישוב ״מה יקרה אם״ לא ישנה את הלוח האמיתי.
הסביבה — Puzzle. לאלגוריתם דרושות שלוש יכולות של הסביבה, ואת שלושתן היא מספקת. goal הוא מצב היעד. get_actions(state) מחזירה את רשימת הפעולות החוקיות במצב, לפי מיקום המשבצת הריקה:
    def get_actions (self, state: State):
        actions = []
        if self.is_legal_action(Action.DOWN, state):
            actions.append(Action.DOWN)
        if self.is_legal_action(Action.RIGHT, state):
            actions.append(Action.RIGHT)
        if self.is_legal_action(Action.UP, state):
            actions.append(Action.UP)
        if self.is_legal_action(Action.LEFT, state):
            actions.append(Action.LEFT)
        return actions
והקריאה env(state, action) היא המודל: היא מחזירה את המצב הבא ואת התגמול, בלי לשנות את המצב שקיבלה. היא נשענת על next_state, שמעתיקה את המצב ומחליפה בין המשבצת הריקה למשבצת השכנה בכיוון הפעולה:
    def next_state (self, action: Action, state: State):
        legal = self.is_legal_action(action, state)
        if not self.is_legal_action(action, state):
            return
        state = state.copy()
        blank_row, blank_col = state.get_blank_pos()
        target_row, target_col = blank_row, blank_col
        match action:
            case Action.UP: target_row -=1
            case Action.DOWN: target_row +=1
            case Action.RIGHT: target_col +=1
            case Action.LEFT : target_col -=1
        state.board[blank_row, blank_col], state.board[target_row, target_col] = state.board[target_row, target_col], state.board[blank_row, blank_col]
        state.blank_pos = target_row, target_col
        return state

    def __call__(self, state: State, action:Action):
        next_state = self.next_state(action, state)
        reward = int(next_state == self.goal)
        return next_state, reward
התגמול מחושב בשורה אחת: int(next_state == self.goal) הוא 1 אם המצב הבא הוא היעד ו־0 אחרת. שתי שיטות נוספות משמשות את המשחק עצמו ולא את האלגוריתם: move(action) מבצעת מהלך על המצב האמיתי של הסביבה, ו־shuffle מערבבת את הלוח במאה מהלכים חוקיים אקראיים מתוך היעד, ולכן כל לוח שהמשחק מציג ניתן לפתרון.
| רכיב בממשק | תפקיד באלגוריתם |
|---|---|
env.goal |
מצב היעד; מדלגים עליו בסריקה |
env.get_actions(state) |
הפעולות החוקיות להזזת המשבצת הריקה |
env(state, action) |
מחזירה (next_state, reward) בלי לשנות את המצב שהתקבל |
env.move(action) |
מבצעת מהלך על הלוח האמיתי; משמשת את Game.py |
env.shuffle() |
מערבבת את הלוח; משמשת את Game.py |
הסוכן — AI_Agent, השלד להשלמה. זה הקובץ בענף התרגיל, כפי שהוא:
from Action import Action
from itertools import permutations
import numpy as np
import torch
from State import State
from Puzzle import Puzzle
import pygame

PATH = 'Data/V_4.pth'
gamma = 0.95

class AI_Agent:
    def __init__(self, env: Puzzle) -> None:
        self.V = dict()
        self.env : Puzzle = env

    def get_Action (self, events):
        state =  self.env.state
        best_value = -1
        best_action = None
        for action in self.env.get_actions(state):
            next_state, reward = self.env(state, action)
            next_value = reward + gamma * self.get_V(next_state)
            if next_value > best_value:
                best_value = next_value
                best_action = action
        pygame.time.wait(300)
        return best_action

    def Init_Value_Table (self):
        # get all states as tuple
        states = permutations([0,1,2,3,4,5,6,7,8])
        for s in states:
            self.V[s] = 0
        # self.save_v()

    def Value_Iteration(self):
        pass

    def save_v (self):
        torch.save(self.V, PATH)

    def load_v (self):
        self.V = torch.load(PATH, weights_only=False)

    def get_V(self, state: State):
        key = tuple(state.board.flatten())
        return self.V[key]

    def set_V(self,state: State, value):
        arr = state.board.flatten()
        key = tuple(arr)
        self.V[key] = value

    def key_to_state(self, key):
        board = np.asarray(key).reshape([3,3])
        return State(board)
כמעט הכול כבר כתוב: טבלת הערכים self.V, האתחול שלה, בחירת הפעולה, שמירה וטעינה, והמעבר בין מצב למפתח. חסרה רק Value_Iteration, ובה pass. אבל כדי להבין את מה שכתוב, צריך להכיר שני כלים: מילון ופרמוטציות.
כלי ראשון: מילון — dict
בעולם הגריד טבלת הערכים הייתה טבלת numpy: המצב היה זוג מספרים (row, col), ושימש ישירות כאינדקס. כאן המצב הוא סידור של תשעה מספרים, ואי אפשר להשתמש בו כאינדקס בטבלה רגילה. הפתרון הוא מילון (dict): מבנה נתונים שמצמיד לכל מפתח (key) ערך (value). בטבלת הערכים שלנו המפתח הוא מצב, כלומר סידור של הלוח כ־tuple של תשעה מספרים לפי סדר השורות, והערך הוא המספר של אותו מצב. כך נראה מילון קטן עם שלושה מצבים בלבד, וערכים שנבחרו לצורך הדוגמה:
V = {(1, 2, 3, 4, 5, 6, 7, 0, 8): 1.0,
     (1, 2, 3, 4, 5, 6, 0, 7, 8): 0.95,
     (1, 2, 3, 4, 0, 6, 7, 5, 8): 0.9025}

print(V[(1, 2, 3, 4, 5, 6, 0, 7, 8)])
V[(1, 2, 3, 4, 5, 0, 7, 8, 6)] = 0
print(len(V))
פלט
0.95
4
יוצרים מילון בסוגריים מסולסלים, וכל שורה בו היא זוג של מפתח, נקודתיים וערך. שולפים ערך לפי המפתח בסוגריים מרובעים: V[(1, 2, 3, 4, 5, 6, 0, 7, 8)] מחזיר 0.95, הערך של המצב שמרוחק שני מהלכים מהיעד. השמה למפתח שעדיין אינו במילון מוסיפה זוג חדש, ולכן אחרי השורה הרביעית יש במילון ארבעה מצבים. המפתח (1, 2, 3, 4, 5, 6, 0, 7, 8) הוא הלוח הזה, שורה אחר שורה: 1, 2, 3 בשורה העליונה, 4, 5, 6 באמצעית, ו־0, 7, 8 בתחתונה, כש־0 הוא המשבצת הריקה:
| 1 | 2 | 3 |
| 4 | 5 | 6 |
| 7 | 8 |
בסוכן, self.V = dict() יוצר מילון ריק; self.V[s] = 0 מוסיף מצב עם ערך 0; self.V[key] שולף את ערכו של מצב; ו־self.V.items() עוברת על כל הזוגות של מפתח וערך, וזה מה שהסריקה של Value Iteration תעשה. שליפה ממילון מהירה גם כשיש בו מאות אלפי מפתחות: המילון אינו מחפש את המפתח שורה אחר שורה, אלא מחשב ממנו ישירות את מקומו בזיכרון (על הרעיון, טבלת גיבוב, ראו פרק א.17).
יש למפתח דרישה אחת: הוא חייב להיות ערך שאי אפשר לשנות. מחרוזת, מספר או tuple יכולים לשמש מפתח; רשימה או טבלת numpy לא, כי אפשר לשנות אותן אחרי שנכנסו למילון. לכן הלוח, שהוא טבלת numpy, אינו יכול להיות מפתח כמות שהוא, ובקוד ממירים אותו ל־tuple של תשעה מספרים; את המעבר המדויק בין לוח למפתח נראה בהמשך. על tuple ועל מילונים ראו פרק א.9 ופרק א.11.
כלי שני: כל הסידורים — permutations
טבלת הערכים צריכה שורה לכל מצב אפשרי, כלומר לכל סידור של המספרים 0 עד 8 בתשעה תאים. סידור כזה נקרא פרמוטציה (permutation), ולוקח כל פריט פעם אחת בסדר כלשהו. לשלושה פריטים יש שישה סידורים, והפונקציה permutations מהמודול itertools מייצרת את כולם, כל אחד כ־tuple:
from itertools import permutations

for p in permutations([1, 2, 3]):
    print(p)
פלט
(1, 2, 3)
(1, 3, 2)
(2, 1, 3)
(2, 3, 1)
(3, 1, 2)
(3, 2, 1)
שישה סידורים הם 3·2·1: שלוש אפשרויות לפריט הראשון, שתיים לשני ואחת לאחרון. לתשעה פריטים זה 9·8·…·1 = 362,880, כפי שחישבנו בפתיחה. הקריאה permutations([0,1,2,3,4,5,6,7,8]) מייצרת את כל הסידורים האלה, וכל סידור הוא tuple של תשעה מספרים, בדיוק המפתח שהמילון צריך. הפונקציה אינה בונה רשימה ענקית מראש אלא מוסרת סידור אחד בכל פעם, ו־Init_Value_Table עוברת עליהם בלולאה ורושמת לכל אחד ערך 0.
שימו לב שלא כל סידור ניתן להגעה במשחק: מתוך 362,880 הסידורים, בדיוק חצי, 181,440, אפשר להגיע אליהם מן היעד בהזזות חוקיות (זו תכונה ידועה של הפאזל, ולא נוכיח אותה כאן). הסידורים האחרים נשארים במילון, אבל אף מהלך מהם אינו מגיע ליעד, ולכן ערכם יישאר 0 לאורך כל החישוב. זה לא מפריע לאלגוריתם, רק מוסיף לו עבודה.
מהלוח למפתח ובחזרה
הסביבה עובדת עם אובייקט State, והמילון עובד עם tuple. שלוש שיטות קטנות מגשרות ביניהם. board.flatten() פורסת את טבלת 3×3 לשורה אחת של תשעה מספרים, לפי סדר השורות, ו־tuple(...) הופכת אותה למפתח; np.asarray(key).reshape([3,3]) עושה את הדרך ההפוכה:
import numpy as np

board = np.array([[1, 2, 3],
                  [4, 5, 6],
                  [0, 7, 8]])
key = tuple(board.flatten())
print(key)
print(np.asarray(key).reshape([3, 3]))
פלט
(1, 2, 3, 4, 5, 6, 0, 7, 8)
[[1 2 3]
 [4 5 6]
 [0 7 8]]
זה בדיוק מה שעושות get_V ו־set_V, שקוראות וכותבות את הערך של מצב, ו־key_to_state, שהופכת מפתח מן המילון בחזרה ל־State כדי שאפשר יהיה לשאול עליו את הסביבה. שתי השיטות האחרונות, save_v ו־load_v, שומרות את המילון כולו לקובץ וטוענות אותו בחזרה, כדי שלא נצטרך לחשב את הטבלה מחדש בכל הפעלה של המשחק.
בחירת הפעולה, get_Action, כבר כתובה, והיא בדיוק ארבעת הצעדים מהפרק הקודם: לכל פעולה חוקית במצב הנוכחי שואלים את הסביבה מה המצב הבא והתגמול, מחשבים reward + gamma * self.get_V(next_state), ושומרים את הפעולה עם המספר הגדול ביותר. אין טבלת מדיניות; pygame.time.wait(300) רק מאט את המשחק כדי שנספיק לראות את המהלכים.
הקובץ Game.py. זה הקובץ שמריצים, בגרסת הפתרון:
import pygame
from State import State
from constants import *
from Puzzle import Puzzle
from Graphics import Graphics
from Human_Agent import Human_Agent
from AI_Agent import AI_Agent

pygame.init()

def main ():

    puzzle = Puzzle()
    goal = puzzle.make_goal_state(ROWS,COLS)

    graphics = Graphics()
    # agent = Human_Agent()
    agent = AI_Agent(puzzle)
    agent.Init_Value_Table()
    agent.Value_Iteration()
    agent.load_v()

    run = True
    clock = pygame.time.Clock()
    graphics.draw(puzzle.state)
    pygame.display.update()
    count = 0
    while(run):

        clock.tick(FPS)
        events = pygame.event.get()
        for event in events:
            if event.type == pygame.QUIT:
               run = False

        action = agent.get_Action(events)
        count += 1
        puzzle.move(action)
        graphics.draw(puzzle.state)
        pygame.display.update()
        print(count, end = '\r')
        if puzzle.state == goal:
            print(f"Victory in {count}")
            # run = False
            puzzle.shuffle()
            count = 0
            pygame.time.wait(2000)
    pygame.quit()

if __name__ == '__main__':
    main()
Puzzle() יוצרת סביבה ומערבבת את הלוח מיד. שלוש השורות שאחרי יצירת הסוכן הן החלק המעניין: Init_Value_Table בונה את המילון עם כל 362,880 הסידורים, Value_Iteration מחשבת את הערכים ושומרת אותם לקובץ, ו־load_v טוענת אותם. אחר כך לולאת המשחק: בכל סיבוב היא שואלת את הסוכן לפעולה, מזיזה את המשבצת הריקה, מציירת את הלוח ומדפיסה את מספר המהלך באותה שורה בטרמינל. כשהלוח מסודר היא מדפיסה בכמה מהלכים הוא נפתר, מערבבת מחדש ומתחילה שוב. בענף התרגיל Game.py מתחיל עם Human_Agent, כדי שתוכלו לשחק בעצמכם במקשי החצים, וארבע שורות הסוכן בהערה. כדי לראות איך המשחק אמור להתנהג עוד לפני שכותבים שורת קוד, החליפו ל־AI_Agent והפעילו רק את load_v: היא טוענת טבלה מוכנה מן הקובץ Data/V_4.pth (שחושבה ליעד 0 עד 8 של אותו ענף).
הרצה לפני ההשלמה. הפעילו את השורות AI_Agent, Init_Value_Table ו־Value_Iteration, השאירו את load_v בהערה, והריצו כשב־Value_Iteration יש עדיין pass בלבד. הטבלה היא טבלת האפסים של האתחול, והסוכן רואה רק מהלך אחד קדימה: מהלך שנכנס ליעד מקבל תגמול 1 ונבחר, וכל מהלך אחר מקבל 0, ואז נבחרת פשוט הפעולה הראשונה ברשימת הפעולות החוקיות. מלוח המרוחק מהלך אחד או שניים מהיעד הסוכן עשוי להצליח במקרה; מלוח שמרוחק 14 מהלכים הוא מזיז את המשבצת הריקה למעלה ולמטה לסירוגין בלי סוף, ו״Victory״ לא מודפס לעולם.
המשימה. עצרו כאן ונסו לפתור לבד לפי הפסאודו־קוד מהפרק הקודם, לפני שתמשיכו לפתרון:
- ממשו את
Value_Iteration: סריקות חוזרות על כל הזוגות ב־self.V.items(), עם דיוק 0.001. בכל מצב שאינו היעד בדקו את כל הפעולות החוקיות, חשבו לכל אחתreward + gamma * self.get_V(new_state), שמרו את הערך הגדול ביותר בעזרתset_Vועקבו אחרי השינוי הגדול ביותר בסריקה. זכרו ש־self.envמקבלתStateולא tuple: השתמשו ב־key_to_state. - הדפיסו במהלך הסריקות אילו מצבים השתנו ובאיזו סריקה, כדי לראות שהחישוב מתקדם.
- בסיום שמרו את הטבלה עם
save_v, הפעילו גם אתload_vב־Game.py, הריצו וצפו בסוכן פותר לוח אחר לוח. כמה סריקות נדרשו?
פתרון — Value Iteration בפאזל
הפתרון נמצא בענף Puzzle_Number_AI_solved של המאגר, בקובץ AI_Agent.py:
    def Value_Iteration(self):
        accuracy = 0.001
        acc = 1
        epochs = 0
        while acc > accuracy:
            epochs += 1
            acc = 0
            for key , old_value in self.V.items():
                best_value = -1000
                state = self.key_to_state(key)
                if state == self.env.goal:
                    continue
                for action in self.env.get_actions(state):
                    new_state, reward = self.env(state,action)
                    new_value = reward + gamma*self.get_V(new_state)
                    best_value = max(best_value, new_value)
                self.set_V(state, best_value)
                acc = max(acc, abs(old_value - best_value))
                if best_value != old_value :
                    print (f'{key} \t {old_value:.3f} \t {best_value:.3f} \t acc {acc:.4f} \t ephocs {epochs}')


        self.save_v()
זהו הפסאודו־קוד של הפרק הקודם, כמעט שורה בשורה. epochs מונה את הסריקות. הלולאה for key, old_value in self.V.items() עוברת על כל המצבים במילון ומקבלת בכל צעד את המפתח ואת ערכו הישן; key_to_state הופכת את המפתח ל־State, ואם זהו היעד מדלגים עליו, כי ממנו המשחק אינו ממשיך וערכו נשאר 0. הלולאה הפנימית עוברת על הפעולות החוקיות, שואלת את הסביבה מה יקרה בכל אחת, ושומרת ב־best_value את הערך הגדול ביותר. set_V כותבת אותו במילון, ו־acc שומר את השינוי הגדול ביותר בסריקה. שורת ההדפסה מציגה כל מצב שערכו השתנה, ומאפשרת לראות את החישוב מתקדם. בסיום save_v שומרת את המילון לקובץ.
שני פרטים ששווה לשים לב אליהם: best_value מתחיל מ־−1000 כדי שהפעולה הראשונה שנבדקת תחליף אותו בוודאות (כל הערכים כאן בין 0 ל־1); ומותר לשנות ערכים של מפתחות קיימים בזמן שעוברים על המילון, אבל אסור להוסיף או להסיר מפתחות תוך כדי הלולאה.
הרצה. החישוב עובר על 362,880 מצבים בכל סריקה, ולכן נמשך כמה דקות, לפי מהירות המחשב. בטרמינל רצות שורות ההדפסה, שורה לכל מצב שהשתנה. תחילת הפלט וסופו:
פלט
(1, 2, 3, 4, 5, 0, 7, 8, 6) 	 0.000 	 1.000 	 acc 1.0000 	 ephocs 1
(1, 2, 3, 4, 5, 6, 7, 0, 8) 	 0.000 	 1.000 	 acc 1.0000 	 ephocs 1
(1, 2, 0, 4, 5, 3, 7, 8, 6) 	 0.000 	 0.950 	 acc 0.9500 	 ephocs 2
(1, 2, 3, 4, 0, 5, 7, 8, 6) 	 0.000 	 0.950 	 acc 0.9500 	 ephocs 2
...
(0, 8, 7, 6, 4, 5, 2, 3, 1) 	 0.000 	 0.226 	 acc 0.2259 	 ephocs 17
בסריקה הראשונה רק שני מצבים משתנים: שני הסידורים שמרוחקים מהלך אחד מהיעד, ולכן מהלך אחד שלהם נותן תגמול 1. בסריקה השנייה מקבלים 0.95 הסידורים שמרוחקים שני מהלכים, וכן הלאה: המידע על היעד מתפשט סריקה אחר סריקה לסידורים רחוקים יותר, בדיוק כמו בלוח 4×4, רק שכאן הגלים מגיעים לעשרות אלפי מצבים בכל סריקה. בסך הכול מודפסות 181,439 שורות, כמספר הסידורים הפתירים פרט ליעד. הסריקה השבע־עשרה היא האחרונה שבה ערכים משתנים; אחריה באה סריקה נוספת שבה שום ערך אינו משתנה, acc נשאר 0 והלולאה נעצרת.
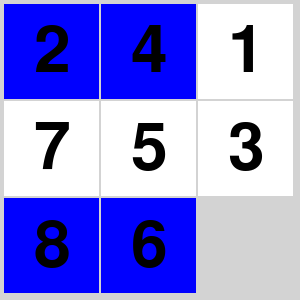
אחרי החישוב נפתח חלון המשחק, והסוכן פותר את הלוח המעורבב מהלך אחר מהלך; כשהלוח מסודר מודפס בטרמינל Victory in ומספר המהלכים, הלוח מתערבב מחדש והסוכן ממשיך. הנה לוח המרוחק 14 מהלכים מהיעד, וזהו המרחק הקצר ביותר האפשרי ממנו. ערכו בטבלה הוא 0.9513≈0.513, כי התגמול 1 מגיע במהלך ה־14, והסוכן פותר אותו ב־14 מהלכים בדיוק, בלי מהלך מיותר:
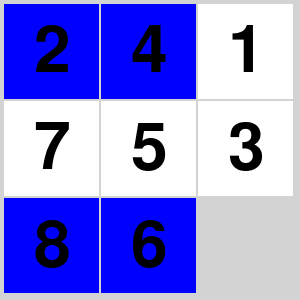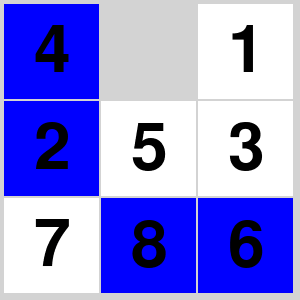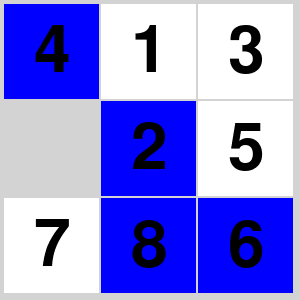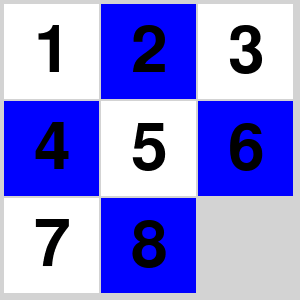
פלט
Victory in 14
הטבלה שחושבה משמשת לכל לוח שהוא; אין מחשבים אותה מחדש בכל משחק. לכן אחרי ההרצה הראשונה אפשר להחזיר את שתי שורות החישוב ב־Game.py להערה ולהסתפק ב־load_v, והמשחק ייפתח מיד.
מה קורה כשהמודל אינו ידוע?
שני פרקי התכנון הדינמי נשענו על הנחה חזקה. החישוב השתמש ביכולת לשאול את הסביבה מה תהיה תוצאתה של כל פעולה, env(state, action), בלי לשחק בפועל. בפאזל זה טבעי, אבל בעולם האמיתי ההנחה הזאת נשברת מהר. מול יריב, למשל, לא תמיד ידוע מראש באיזו פעולה הוא יבחר, ולכן לא ידוע בדיוק באיזה מצב נקבל שוב את התור. במשחקי קוביות המצב הבא תלוי בהטלה. רובוט שלומד ללכת אינו יודע מראש איך הרצפה תגיב. מכאן נעבור ללמידה מתוך התנסות בפועל.
אקראיות כשלעצמה אינה מונעת תכנון דינמי: אם הסתברויות המעברים ידועות, אפשר לחשב תוחלת במקום תוצאה יחידה. הקושי בפרקים הבאים הוא שהמודל אינו נתון לסוכן, והוא צריך ללמוד מדגימות.