ד.7 — מונטה קרלו — למידה מהתנסות
המצגת: מונטה קרלו · השיעור באתר הקורס · קוד: MC_Trainer.py · AI_Agent.py · מאגר Tic_Tac_Toe_2 בגיטהב
בשלושת הפרקים הקודמים ענינו על השאלה ״מה המהלך הטוב ביותר?״ בהנחה שאנחנו יודעים את חוקי המשחק במלואם: לכל מצב ופעולה יכולנו לשאול את המודל מה יקרה, ומשוואת בלמן חישבה את ערך המצב מתוך המצב הבא. Value Iteration מחייב אותנו לדעת מהו המודל של הסביבה, כלומר מה יהיה המצב הבא בעקבות כל פעולה. הפרק הזה שואל שאלה חדשה: מה עושים כשאין לנו מודל כזה, וכל מה שאנחנו יכולים לעשות הוא לשחק ולראות מה קורה? זהו המצב הנפוץ בעולם האמיתי, מול יריב, בשוק או בשליטה ברובוט, ולכן זהו הרגע שבו הסוכן מתחיל באמת ללמוד ולא רק לחשב.
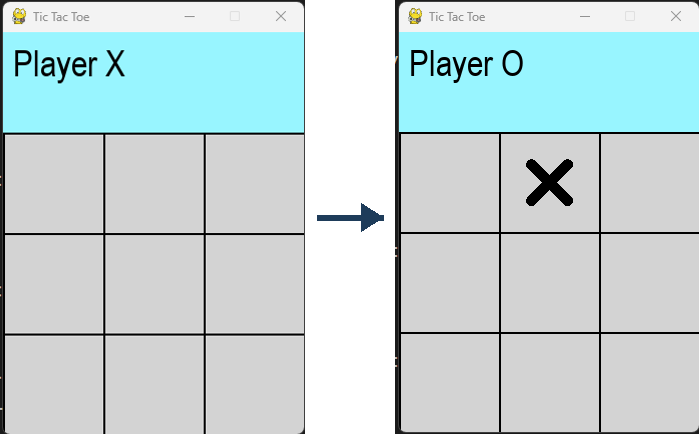
נדגים את הבעיה במשחק איקס עיגול. השחקן שלנו הוא X, והמצב הנוכחי s הוא הלוח הריק. נניח שהשחקן בוחר את הפעולה (0,1), המשבצת העליונה האמצעית. הלוח שנוצר אינו המצב הבא: הוא ממתין לסביבה, כלומר לשחקן השני, שיבצע את המהלך שלו. רק אחרי שהיריב שיחק אנחנו יודעים מהו s′, יכולים לחשב את התגמול, ויכולים לבחור את הפעולה הבאה. ואת מה שהיריב יעשה איננו יודעים מראש: במשחק אחד הוא יבחר במרכז, ובמשחק אחר בפינה.
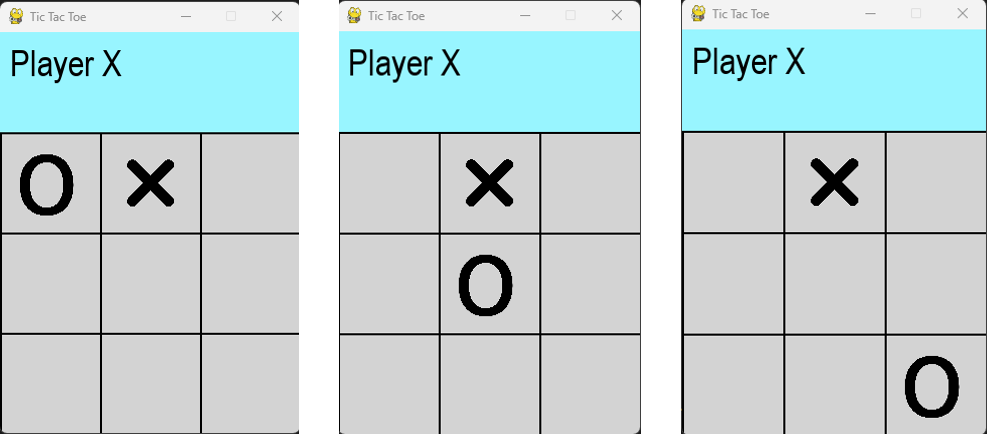
בהעדר מודל איננו יכולים להשתמש ב־Value Iteration, כי אין לנו דרך לחשב את נוסחת בלמן: היא צריכה את s′. יתר על כן, גם אילו הייתה נתונה לנו טבלת ערכים מוכנה, לא היינו יכולים לגזור ממנה מדיניות כפי שעשינו בפרק הקודם: שם בחרנו את הפעולה שמובילה למצב בעל הערך הגבוה ביותר, וכאן איננו יודעים לאיזה מצב כל פעולה מובילה.
הפתרון — Monte Carlo Method
הפתרון הוא ללמוד מהתנסות: לשחק משחקים, לרשום מה קרה בהם, ולהשתמש בתוצאות כדי לשפר את ההערכות שלנו. זו הגישה של Monte Carlo — מונטה קרלו. השם לקוח מעיר הקזינו המפורסמת: במקום לחשב הסתברויות מדויקות, ״מטילים קובייה״ פעמים רבות ולומדים מהממוצע של התוצאות.
איננו יודעים את המודל, אז נדגום את הסביבה: נשחק מול היריב משחק אחד שלם, עד לסיומו, ונרשום את שרשרת המצבים, הפעולות והתגמולים שהתרחשו בפועל:
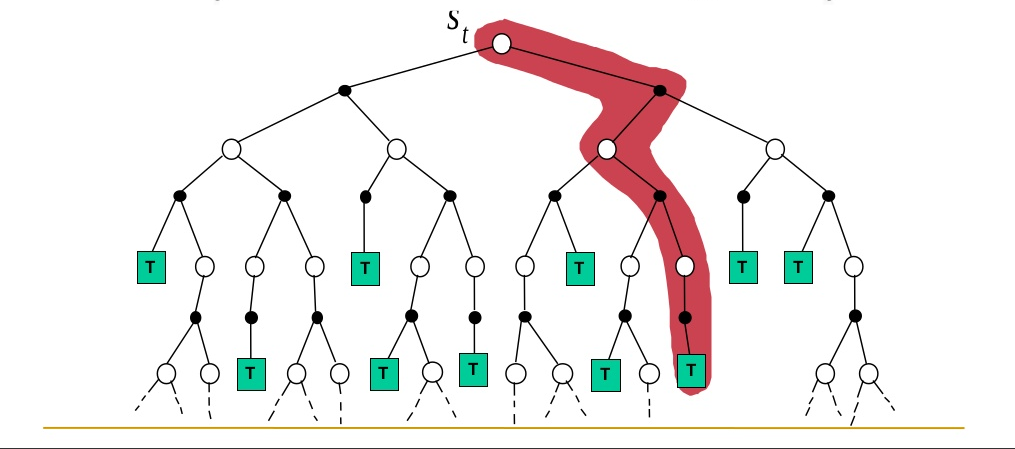
רצף כזה, מההתחלה ועד הסיום, הוא אפיזודה, כפי שהגדרנו בפרק המודל. כאן נמצא ההבדל הראשון מהתכנון הדינמי: שם סרקנו את כל המצבים בטבלה; כאן אנחנו רואים רק את המצבים שהמשחק עבר בהם בפועל, מסלול אחד מתוך כל הענפים האפשריים.
אחרי שהמשחק הסתיים יש בידינו את כל הנתונים כדי לחשב את הערך של המצב הראשון: זו התשואה G0 של האפיזודה הזאת, סכום התגמולים המהוון שהגדרנו בפרק המודל, כשכל תגמול רחוק יותר מוכפל ב־γ פעם נוספת:
כאן R0 הוא התגמול שהתקבל אחרי הפעולה A0, כמו בשרשרת שלמעלה (בפרק המודל כתבנו את אותו תגמול R1; רק המספור שונה). ואת אותו חישוב אפשר לעשות לכל אחד מהמצבים בשרשרת, לא רק לראשון: מכל מצב St מסתכלים קדימה עד סוף האפיזודה:
חשוב להדגיש: Gt היא התשואה של האפיזודה הזאת, מהצעד t ועד סופה. זהו סכום התגמולים המהוון שהתקבלו בפועל במשחק הזה, מהמצב St ועד המצב הסופי. זה מספר שמחשבים מתוך משחק אחד שכבר הסתיים, לא הערכה ולא תוחלת; לכן אפשר לחשב אותו רק אחרי שהאפיזודה נגמרה, ובאפיזודה אחרת שעוברת באותו מצב הוא עשוי לצאת שונה לגמרי.
באיקס עיגול התגמול מגיע רק בסוף, ניצחון, הפסד או תיקו, וכל המהלכים שלפניו קיבלו 0; כך התוצאה הסופית מיוחסת גם למהלכים שהובילו אליה.
דוגמה. משחק שבו X ניצח בשלושה מהלכים, עם γ=0.9. מבחינת X המשחק הוא שלושה צעדים: בכל צעד X מניח סימן ואחר כך היריב מגיב, והתגמולים הם 0, 0 ולבסוף 1 על הניצחון. התשואה של הצעד האחרון היא 1; של הצעד שלפניו 0 + 0.9·1 = 0.9; ושל הראשון 0 + 0.9·0.9 = 0.81. הדרך הנוחה לחשב זאת היא מהסוף להתחלה: מתחילים ב־G=0, ובכל צעד אחורה מחשבים G = r + γ·G:
| צעד | תגמול r | חישוב | תשואה G |
|---|---|---|---|
| 3 (האחרון) | 1 | 1 + 0.9·0 | 1 |
| 2 | 0 | 0 + 0.9·1 | 0.9 |
| 1 (הראשון) | 0 | 0 + 0.9·0.9 | 0.81 |
ואם המשחק הסתיים בהפסד, התגמול האחרון הוא −1, והתשואות הן −1, −0.9 ו־−0.81: המהלך שאחריו הגיע ההפסד מקבל את ״האשמה״ הגדולה ביותר, ומהלכי הפתיחה חלק קטן ממנה. בתיקו כל התגמולים 0, וכל התשואות 0.
זו תוצאה של משחק אחד. משחק אחד שהסתיים בניצחון אינו מוכיח שכל משחק שמתחיל באותו מצב יסתיים כך; ייתכן שהניצחון נבע ממהלך גרוע של היריב. לכן חוזרים על הדגימה מספר רב של פעמים, כדי לעבור על מצבים רבים ככל האפשר ולראות כל אחד מהם בהמשכים שונים.
בעיות שיש לפתור באלגוריתם MC
לפני שנוכל לכתוב את האלגוריתם, הגישה הזאת מעמידה בפנינו שלוש בעיות שהתכנון הדינמי לא הכיר. שלושת הסעיפים הבאים פותרים אותן אחת אחרי השנייה, וזו דרך הלימוד של הפרק:
2. מודל לא ידוע (Model Free). גם אחרי שחישבנו ערכים, בזמן המשחק איננו יודעים לאיזה מצב תוביל כל פעולה. איך בוחרים את הפעולה הטובה ביותר?
3. דרך הדגימה. איך הסוכן יבחר את הפעולות שהוא מבצע בזמן הדגימה של הסביבה? באקראי? לפי מדיניות מסוימת?
בעיה 1 — סביבה סטוכסטית (אקראית)
עד כה התעלמנו מהמקרים שבהם המודל של הסביבה הוא אקראי (סטוכסטי): אחרי שהסוכן מבצע פעולה, המצב הבא אינו קבוע מראש, והסביבה עשויה להחזיר כמה מצבים שונים. דוגמאות: מכונית שנכנסת לעיקול כשמצב הכביש אינו ידוע, אם הכביש יבש היא תסיים את הסיבוב, ואם הוא רטוב היא תחליק, נניח ב־10% מהפעמים; באיקס עיגול, אחרי המהלך שלנו לא ידוע מה היריב יבצע, ויריב אקראי עשוי לבחור באותו מצב פעולות שונות; במשחק קלפים, כשמבקשים קלף נוסף איננו יודעים איזה קלף נקבל; וכך גם בהטלת קוביות.
הסתברות ותוחלת — שני מושגים שנצטרך
לפני הנוסחה, שני מושגים מתורת ההסתברות, בקצרה ובדוגמאות.
הסתברות של תוצאה היא מספר בין 0 ל־1 שאומר באיזה חלק מהפעמים התוצאה מתקבלת, כשחוזרים על אותו ניסוי פעמים רבות. בהטלת קובייה הוגנת ההסתברות לקבל 6 היא 1/6: בערך אחת מכל שש הטלות. סכום ההסתברויות של כל התוצאות האפשריות הוא תמיד 1, כי משהו חייב לקרות. בדוגמת הכביש: הסתברות 0.1 (10%) להחלקה ו־0.9 לסיבוב מוצלח.
תוחלת (Expected Value) היא הממוצע שנקבל בטווח הארוך, אם נחזור על הניסוי פעמים רבות מאוד. מחשבים אותה כך: מכפילים כל תוצאה אפשרית בהסתברות שלה, ומחברים. זהו ממוצע משוקלל: תוצאה שמתקבלת לעיתים קרובות ״שוקלת״ יותר מתוצאה נדירה. שתי דוגמאות:
- קובייה. כל אחת מהתוצאות 1 עד 6 מתקבלת בהסתברות 1/6, ולכן התוחלת היא (1 + 2 + 3 + 4 + 5 + 6)/6 = 21/6 = 3.5. שימו לב: 3.5 אינה תוצאה אפשרית של הטלה אחת. התוחלת אינה ״מה שיקרה בהטלה הבאה״ אלא הממוצע של הטלות רבות: אם נטיל אלף פעמים ונמצע, נקבל מספר קרוב ל־3.5.
- משחק מזל. במשחק מרוויחים 10 שקלים בהסתברות 0.2 ומפסידים שקל אחד בהסתברות 0.8. התוחלת היא 10·0.2 + (−1)·0.8 = 2 − 0.8 = 1.2: בממוצע, כל משחק מכניס 1.2 שקלים, אף שברוב המשחקים הבודדים מפסידים. מי שישחק מאה פעמים ירוויח בערך 120 שקלים.
בכתיב מתמטי מסמנים את התוחלת באות E (מהמילה Expected): E[X] פירושו ״התוחלת של X״, הממוצע המשוקלל של כל הערכים ש־X יכול לקבל.
נוסחת בלמן בסביבה אקראית
עכשיו אפשר לחזור למשוואת בלמן. בסביבה דטרמיניסטית כתבנו V(s) = r + γV(s′): אחרי הפעולה יש מצב הבא יחיד, שידוע מראש, ותגמול יחיד. בסביבה אקראית אחרי אותה פעולה יכולים להתקבל כמה מצבים הבאים שונים, כל אחד בהסתברות שלו, ולכן ערך המצב הוא התוחלת של ״התגמול ועוד γ כפול ערך המצב הבא״ על פני כל המצבים הבאים האפשריים:
קוראים את זה כך: לכל מצב הבא אפשרי s′ מחשבים את התגמול שמתקבל במעבר אליו ועוד γ כפול ערכו, מכפילים בהסתברות להגיע אליו, ומחברים את כל המכפלות. אם יש רק מצב הבא אחד, בהסתברות 1, נשארת המשוואה הדטרמיניסטית שהכרנו. זו משוואת בלמן המלאה שהוזכרה כרשות בפרק ד.4, וכאן היא כבר אינה רשות: היריב הוא סביבה אקראית.
נדגים זאת בעץ. בעץ כזה נקודה לבנה היא מצב, שבו הסוכן בוחר; הקשת היוצאת ממנה היא הפעולה שנבחרה; הנקודה השחורה היא המצב מיד אחרי הפעולה שלנו, לפני שהסביבה הגיבה (after state); ומהנקודה השחורה יוצאים כמה ענפים, אחד לכל תגובה אפשרית של הסביבה, כל אחד עם ההסתברות שלו, אל הנקודה הלבנה הבאה: המצב שבו הסוכן שוב בוחר. באיקס עיגול הנקודה השחורה היא הלוח אחרי שהנחנו את ה־X שלנו, והענפים הם התגובות האפשריות של היריב.
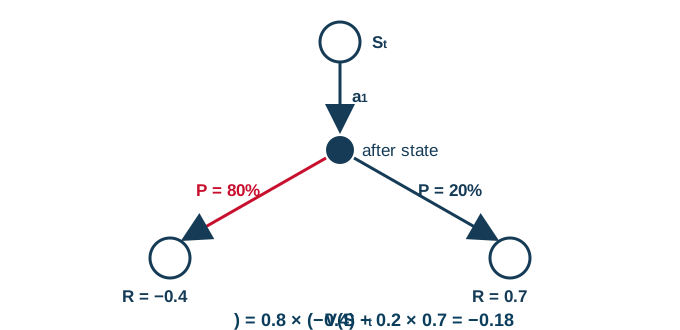
נניח לצורך ההדגמה שמהמצב St יש לסוכן רק פעולה חוקית אחת, a1, ולכן ערך המצב V(St) הוא פשוט הערך שמתקבל אחרי הפעולה הזאת (על ערך של מצב ופעולה יחד נדבר בהמשך הפרק). הסוכן מבצע את a1, ואחרי הפעולה הסביבה יכולה להוביל לשני מצבים: ב־80% מהמקרים לענף השמאלי, שההמשך ממנו שווה −0.4, וב־20% לענף הימני, שההמשך ממנו שווה 0.7 (המספרים על הענפים הם הערכים שמתקבלים מכל המשך, כולל התגמול והמשך המשחק). ערך המצב הוא התוחלת, בדיוק כמו במשחק המזל:
הערך שלילי אף שאחד ההמשכים טוב, כי ההמשך הרע קורה הרבה יותר. אילו ההסתברויות היו הפוכות, 20% ו־80%, היינו מקבלים 0.2·(−0.4) + 0.8·0.7 = 0.48, והמצב היה מצוין. ההסתברויות משנות את הערך לא פחות מהתוצאות עצמן.
עוד דוגמה, מאיקס עיגול. נניח ש־X מחליט תמיד לפתוח בפינה (0,0), כך שמהלוח הריק יש לו למעשה פעולה אחת, ומולו יריב אקראי. אם היריב מגיב במרכז, ההמשך קשה ל־X, ונניח שהתשואה שתתקבל בסוף היא 0.1; אם הוא מגיב בכל משבצת אחרת, X בדרך כלל מנצח, ונניח תשואה 0.8. יריב אקראי בוחר את המרכז באחת משמונה המשבצות הפנויות, כלומר בהסתברות 1/8 = 12.5%, ואת שאר המשבצות בהסתברות 7/8 = 87.5%. ערך הלוח הריק הוא 0.1×0.125 + 0.8×0.875 = 0.0125 + 0.7 = 0.7125. המספרים כאן להמחשה, אבל המבנה אמיתי: ערך של מצב מול יריב אקראי הוא ממוצע משוקלל על תגובותיו, כשלכל תגובה יש הסתברות.
דגימה של סביבה אקראית
אבל את ההסתברויות 80% ו־20% איננו יודעים; הן חלק מהמודל שאין לנו. כאן נכנסת הדגימה: אם נבצע את אותה פעולה מאותו מצב פעמים רבות, ההתפלגות תתגלה מעצמה. ב־100 דגימות נקבל בערך 80 פעמים את ההמשך הראשון ו־20 פעמים את השני, וממוצע התוצאות שקיבלנו הוא בדיוק הערך המשוקלל שחיפשנו:
אין צורך לדעת מראש באיזו הסתברות היריב בוחר כל תגובה; די לשחק, לרשום תוצאות ולמצע. מדגם אחר של 100 משחקים עשוי לתת 78 ו־22, ואז הממוצע יהיה −0.158 ולא −0.18; לכן אין להסתמך על משחק יחיד, וככל שנשחק יותר, הממוצע יתקרב לתוחלת האמיתית.
חישוב ממוצע של הערכים
איך מחשבים ממוצע של דגימות שמגיעות אחת אחרי השנייה, בלי לשמור את כולן? מחזיקים לכל מצב מונה n של מספר הפעמים שהסוכן ביקר בו, ואת הממוצע הנוכחי V. כשמגיעה דגימה חדשה Vnew, אפשר לחשב את הממוצע החדש מתוך הממוצע הישן בלבד. הפיתוח הוא אלגברה פשוטה בשלושה צעדים.
צעד 1 — כותבים את הממוצע החדש. הממוצע הישן V הוא ממוצע של n−1 דגימות, ולכן סכומן הוא V·(n−1). מוסיפים את הדגימה החדשה, ומחלקים את הסכום במספר הדגימות הכולל, n:
צעד 2 — פותחים סוגריים ומסדרים. במונה, V·(n−1) הוא V·n − V. נכתוב את המונה מחדש כך שיהיו בו V·n ולידו ההפרש בין הדגימה החדשה לממוצע הישן:
צעד 3 — מפצלים את השבר. מחלקים כל אחד משני האיברים במונה ב־n. האיבר הראשון, V·n/n, הוא פשוט V:
זו נוסחת הממוצע: הממוצע החדש הוא הממוצע הישן, ועוד חלק 1/n מן ההפרש בין הדגימה החדשה לממוצע הישן. אין צורך לשמור את הדגימות עצמן, רק את V ואת n.
בדיקה במספרים. הממוצע של שלוש דגימות הוא 0.2, והדגימה הרביעית נותנת 1. בדרך הרגילה: סכום שלוש הדגימות הוא 0.2·3 = 0.6, מוסיפים 1 ומקבלים 1.6, ומחלקים ב־4: 0.4. בנוסחה: 0.2 + (1 − 0.2)/4 = 0.2 + 0.2 = 0.4. אותו מספר, אבל בלי לדעת מה היו שלוש הדגימות הראשונות. שימו לב גם לכיוון: הדגימה החדשה (1) גדולה מהממוצע (0.2), ולכן הממוצע עלה; וככל שיש יותר דגימות, n גדול יותר, וכל דגימה חדשה מזיזה את הממוצע פחות.
דוגמה: אותו מצב, חמש דגימות. נניח שביקרנו במצב מסוים חמש פעמים, ובכל פעם התשואה שהתקבלה בסוף המשחק הייתה אחרת: 1, −1, 1, 1, 0. הממוצע מתעדכן כך:
| דגימה n | Vnew | חישוב | V אחרי העדכון |
|---|---|---|---|
| 1 | 1 | 0 + (1 − 0)/1 | 1 |
| 2 | −1 | 1 + (−1 − 1)/2 | 0 |
| 3 | 1 | 0 + (1 − 0)/3 | 0.333 |
| 4 | 1 | 0.333 + (1 − 0.333)/4 | 0.5 |
| 5 | 0 | 0.5 + (0 − 0.5)/5 | 0.4 |
ואכן, הממוצע של 1, −1, 1, 1, 0 הוא 2/5 = 0.4.
חישוב ממוצע ללא החזקת מונה
דרך נוספת, שאינה דורשת מונה לכל מצב, היא שיטת תיקון הטעות: במקום 1/n משתמשים במספר קטן קבוע, מקדם הלמידה α (אלפא):
ההפרש בסוגריים הוא הטעות שלנו: הפער בין התוצאה שדגמנו לבין האומדן הנוכחי. אם הערך החדש גדול מהממוצע, מוסיפים ל־V קצת; אם הוא קטן, מפחיתים קצת. אנחנו יוצאים מתוך הנחה שנבצע את החישוב מספר רב מאוד של פעמים, ולכן נגיע לממוצע האמיתי. השיטה מזכירה את Gradient Descent מחלק ג, רק בלי הנגזרת: צעד קטן בכיוון הטעות, שוב ושוב.
אותה דוגמה עם α=0.1. חמש הדגימות 1, −1, 1, 1, 0, הפעם בלי מונה:
| דגימה | Vnew | חישוב | V אחרי העדכון |
|---|---|---|---|
| 1 | 1 | 0 + 0.1·(1 − 0) | 0.1 |
| 2 | −1 | 0.1 + 0.1·(−1 − 0.1) | −0.01 |
| 3 | 1 | −0.01 + 0.1·(1 + 0.01) | 0.091 |
| 4 | 1 | 0.091 + 0.1·(1 − 0.091) | 0.182 |
| 5 | 0 | 0.182 + 0.1·(0 − 0.182) | 0.164 |
אחרי חמש דגימות בלבד הערך רחוק מהממוצע 0.4, כי כל צעד קטן. זה המחיר של α קבוע, והוא משתלם כשיש הרבה דגימות: אחרי אלפי משחקים הערך מתקרב לממוצע, ובלי לשמור מונה לכל אחד מאלפי המצבים. יש לשיטה גם יתרון: כאשר α קבוע, זהו ממוצע משוקלל שנותן משקל רב יותר לדגימות האחרונות, וזה דווקא רצוי כשהמדיניות משתנה במהלך האימון. משחקים ישנים, ששוחקו כשעדיין שיחקנו גרוע, מאבדים בהדרגה את השפעתם.
לסיכום הבעיה הראשונה: במונטה קרלו נגיע למצב St פעמים רבות. בכל פעם נחשב את התשואה Gt לפי המסלול שהגענו אליו, ונעדכן את הממוצע. אחרי מספיק ביקורים הממוצע יהיה קרוב מאוד לערך האמיתי של המצב:
שימו לב מתי העדכון מתבצע: רק בסוף האפיזודה, כי רק אז Gt ידוע. בספרות קוראים לזה Sample Backup, גיבוי מדגימה: הערך של מצב מתעדכן ממסלול אחד שנדגם, ולא מכל הענפים כמו בתכנון הדינמי.
בעיה 2 — מציאת המדיניות בהעדר מודל
מצאנו דרך לחשב את פונקציית הערך גם בהעדר מודל, בעזרת סדרה של ניסויים ושמירת התוצאות. נותרה הבעיה השנייה: איננו יכולים לקבל את המדיניות מפונקציית הערך. בפרק הקודם בחרנו את הפעולה שמביאה למצב עם הערך הגבוה ביותר. אבל אם איננו יודעים מהו המצב הבא, כיצד נבחר?
נניח שאנחנו בלוח הריק, ושכבר למדנו את הערכים של לוחות שיכולים להיווצר אחרי המהלך שלנו ותגובת היריב. הנה ארבעה מהם, עם ערכים לצורך ההמחשה:
| X | ||
| O | ||
| X | ||
| O | ||
| X | ||
| O |
| X | ||
| O |
שני הלוחות הראשונים נוצרים שניהם מהפעולה (0,1); ההבדל ביניהם הוא רק בתגובת היריב, ולאחד מהם ערך נמוך ולשני גבוה. איזה מהם נקבל אם נשחק (0,1)? איננו יודעים, ולכן ערכי הלוחות האלה אינם אומרים לנו אם (0,1) היא פעולה טובה. אותו דבר בשני הלוחות האחרונים, שנוצרים מפינות שונות: הערכים שייכים ללוחות שאחרי תגובת היריב, לא לפעולות שלנו.
הפתרון — Q-Table
במקום לשמור ערך לכל מצב, נשמור ערך לכל זוג של מצב ופעולה, בטבלה שנקראת Q-Table. הנתונים לכך כבר בידינו: באותה אפיזודה שדגמנו, S0, A0, R0, S1, A1, R1, …, התשואה שחישבנו מהמצב S0 היא בעצם התשואה של הזוג (S0, A0): מה יצא, בסופו של דבר, מביצוע הפעולה A0 במצב S0. וכך לכל זוג בשרשרת, כל אחד מנקודתו והלאה:
ההגדרה של ערך מצב–פעולה נמצאת בפרק המודל; כעת אנחנו לומדים אותו מתוך דגימות, באותו כלל עדכון בדיוק:
טבלת Q פותרת את הבעיה השנייה. הקושי היה שכדי לבחור פעולה היינו צריכים לדעת לאיזה מצב היא מובילה, וזה תלוי במה שהיריב יעשה. בטבלת Q הציון ניתן לפעולה שלנו עצמה: בשורה של המצב הנוכחי שמור, לכל פעולה חוקית, הערך שהתקבל בממוצע מביצועה, כולל כל מה שקרה אחריה, תגובות היריב וכל ההמשך. לכן בזמן המשחק לא צריך לחכות ולראות מה יעשה היריב, ולא צריך מודל שינבא זאת: מסתכלים בשורה של המצב, ובוחרים את הפעולה עם הערך הגבוה ביותר. כך נראית טבלת Q של איקס עיגול: שורה לכל מצב (לוח), ועמודה לכל אחת מתשע המשבצות, כלומר לכל פעולה אפשרית. בכל תא רשום הערך של הפעולה באותו מצב; במשבצות תפוסות, שאינן פעולה חוקית באותו מצב, מסומן N/A:
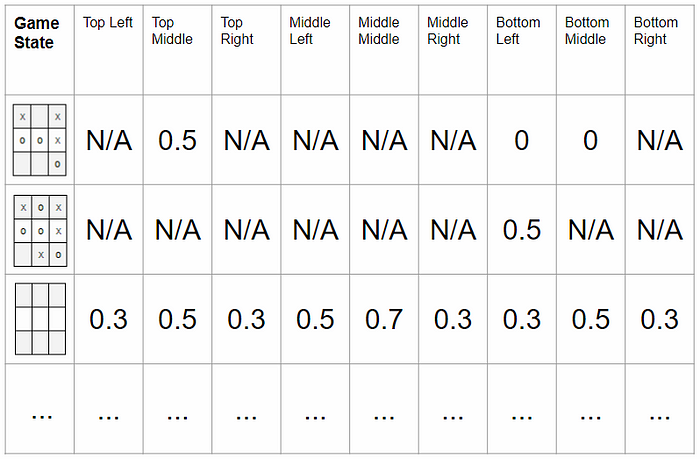
בשורה הראשונה, למשל, ל־X נותרו שלוש משבצות פנויות, ולפי הטבלה הטובה שבהן היא Top Middle עם 0.5; בשורה של הלוח הריק (השלישית) הערך הגבוה ביותר הוא 0.7 במשבצת האמצעית, ולכן X יפתח במרכז. בכל מקרה הבחירה נעשית מתוך השורה של המצב הנוכחי בלבד, בלי לשאול מה יעשה היריב אחר כך.
ואפשר גם בנוסחה: המדיניות בוחרת את הפעולה שנותנת את הערך הגדול ביותר בטבלה, מבין הפעולות החוקיות במצב:
שימו לב שאין להוסיף כאן שוב את התגמול המיידי, כפי שעשינו ב־Value Iteration: הוא כבר נכלל בתשואה שעל פיה Q נלמד.
איך הסוכן בוחר פעולה בעזרת Q, צעד אחר צעד. נסכם את הבחירה כאלגוריתם במילים, כי זו הפעולה שהסוכן יבצע בכל מהלך ומהלך:
- הסוכן נמצא במצב s ורושם את הפעולות החוקיות בו (באיקס עיגול: המשבצות הפנויות).
- הוא פונה לטבלת Q ושולף את כל הערכים של השורה של המצב, Q(s, *): ערך אחד לכל פעולה חוקית. פעולה שעדיין אינה בטבלה מקבלת 0.
- הוא משווה בין הערכים ומוצא את הגדול ביותר.
- הוא מבצע את הפעולה שנתנה את הערך הזה. אם כמה פעולות שקולות, בוחרים אחת מהן, למשל הראשונה.
זה כל מה שנדרש: אין כאן ״לאן הפעולה מובילה״, אין מודל ואין ניחוש של מהלך היריב. כל הידע על ההמשך כבר מקופל במספר שבטבלה. השוו ל־Value Iteration, שם בכל בחירה שאלנו את המודל מה המצב הבא של כל פעולה; כאן שואלים רק את הטבלה.
בעיה 3 — דרך ביצוע הדגימה
נותרה השאלה השלישית: אילו פעולות לבחור בזמן הדגימה של הסביבה. יש שתי אפשרויות קיצוניות:
- בחירה אקראית. הסוכן בוחר בכל פעם פעולה חוקית אקראית. השיטה תביא לתוצאה נכונה, כי כל הפעולות ייבדקו, אבל תחייב מספר עצום של דגימות, והלמידה תהיה איטית מאוד.
- בחירה לפי טבלת Q. הסוכן בוחר בכל פעם את הפעולה הטובה ביותר לפי הידע שיש לו כרגע. בהתחלה הטבלה אקראית, אבל תוך כדי הניסויים הערכים מתקרבים לערכים הנכונים. הבעיה: ברגע שמצאנו פעולה אחת טובה, נבחר בה שוב ושוב ולא ננסה פעולות אחרות, שאולי טובות יותר; וכיוון שלא בחרנו בהן, לעולם לא נדע.
דוגמה. בלוח הריק הסוכן ניסה פעם אחת את הפינה (0,0) וניצח, ולכן Q של הפינה חיובי, וכל שאר הפעולות עדיין 0. מעכשיו בחירה לפי הטבלה תפתח תמיד בפינה, ולעולם לא תנסה את המרכז, גם אם המרכז הוא הפתיחה הטובה ביותר. הטבלה ״ננעלת״ על הצלחה מקרית.
זוהי הדילמה המכונה Exploration vs. Exploitation, חקירה מול ניצול: מתי לנסות מצבים חדשים (Explore) ומתי לנצל את הידע הקיים וללכת לפיו (Exploit). היא מוכרת גם מחוץ למשחקים: מי שתמיד מזמין במסעדה את המנה שהוא כבר אוהב לא יגלה לעולם מנה טובה יותר, ומי שתמיד מנסה משהו חדש לא נהנה ממה שכבר יודע שטוב.
Epsilon-Greedy Function
הפתרון: בדרך כלל בוחרים את הפעולה שלפי הידע העכשווי היא הטובה ביותר, לפי טבלת Q, אך מדי פעם בוחרים פעולה אקראית. הסיכוי לבחירה אקראית נקבע על ידי המספר ε (אפסילון, מספר קטן בין 0 ל־1):
epsilon = 0.001

def Epsilon_Greedy (state, Q_Value):
    r = Random()
    if r < epsilon:
        return random legal action
    else:
        return maxArg_a (Q(s, a))
Random() מגרילה מספר בין 0 ל־1, ולכן התנאי מתקיים בהסתברות ε. דוגמה עם ε=0.2: הוגרל 0.13, קטן מ־0.2, ולכן הסוכן בוחר משבצת פנויה אקראית, גם אם היא נראית גרועה לפי הטבלה; בפעם הבאה הוגרל 0.57, ולכן הוא בוחר את הפעולה עם Q הגבוה ביותר. בממוצע אחד מכל חמישה מהלכים יהיה מהלך חקירה. גם בהגרלה אפשר לבחור במקרה את הפעולה בעלת הערך המרבי.
Epsilon-greedy decay
אפשר לשפר את האלגוריתם: בתחילת האימון הטבלה כמעט ריקה, ולכן נרצה לחקור הרבה; ככל שהמודל מאומן יותר, נסתמך יותר על הטבלה. לכן ε לא יהיה קבוע אלא ירד במהלך האימון, מערך גבוה בהתחלה לערך קטן בסופו. הדרך הפשוטה ביותר היא דעיכה לינארית: ε יורד בקו ישר מ־start ל־final לאורך decay אפיזודות, ומשם נשאר קבוע. הפונקציה מקבלת את מספר האפיזודה, epoch, ומחזירה את ε המתאים לה:
epsilon_start = 1.0
epsilon_final = 0.01
epsilon_decay = 100000

def epsilon_greedy(epoch, start=epsilon_start, final=epsilon_final, decay=epsilon_decay):
    if epoch > decay:
        return final
    return start - (start - final) * epoch / decay
באפיזודה 0 מקבלים 1.0, כלומר משחק אקראי לחלוטין; בכל אפיזודה ε יורד באותה כמות קטנה, עד שבאפיזודה 100,000 הוא מגיע ל־0.01, ומשם נשאר 0.01 עד סוף האימון:
| אפיזודה | ε | משמעות |
|---|---|---|
| 0 | 1.0 | כל מהלך אקראי |
| 25,000 | 0.75 | שלושה מכל ארבעה מהלכים אקראיים |
| 50,000 | 0.505 | בערך חצי |
| 75,000 | 0.26 | אחד מכל ארבעה |
| 100,000 ואילך | 0.01 | אחד מכל מאה, עד סוף האימון |
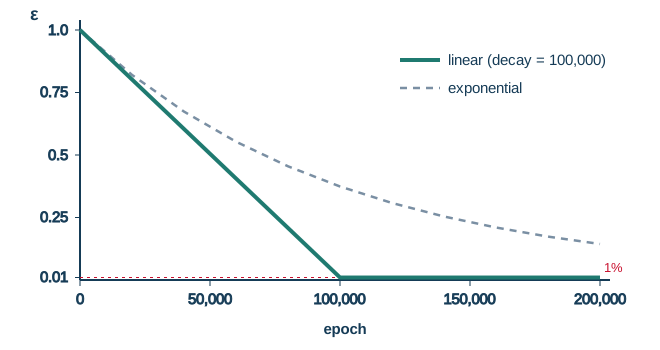
אפשרות אחרת היא דעיכה מעריכית, final + (start − final)·e−epoch/decay: ירידה מהירה בהתחלה ואיטית בהמשך, כמו הקו המקווקו בגרף, כשהערך מתקרב ל־final בהדרגה ואינו מגיע אליו בדיוק. שתי הדרכים מקובלות; בקוד של הפרק הבא נשתמש בלינארית.
סיכום — עקרונות אלגוריתם מונטה קרלו
חישוב ממוצע. כיוון שהסביבה אקראית, וכל פעולה יכולה להוביל למצבים שונים, מחשבים את ממוצע הערכים שהתקבלו בדגימות השונות, בעזרת α.
טבלת Q של מצב–פעולה. כיוון שהמודל לא ידוע, שומרים את הערכים לפי מצב ופעולה, וכך בכל מצב בוחרים את הפעולה עם הערך הגבוה ביותר בלי לדעת לאן היא מובילה.
Exploration מול Exploitation. בבחירת הפעולות בזמן הדגימה משתמשים ב־ε-greedy: ברוב המקרים הפעולה המיטבית לפי הטבלה, ולעיתים פעולה אקראית.
פסאודו־קוד מונטה קרלו
יש לנו עכשיו את כל החלקים. האלגוריתם מאתחל את הטבלה ואת הפרמטרים, ואז חוזר על שני שלבים בכל אפיזודה: משחק שלם עם בחירה ב־ε-greedy, ואחריו מעבר על האפיזודה מהסוף להתחלה, חישוב G ועדכון Q:
def Monte_Carlo ():

    #initialize
    alpha = small number
    epsilon = small number or epsilon_decay()
    for all s in S, a in A
        Q(s,a) = random()
    epochs = big number
    for epoch in epochs (for each episode):
        epsilon = epsilon_decay()
        Generate an episode using epsilon-greedy(): S0,A0,R0,S1,A1,R1 ...S_n
        G = 0
        for t=n-1 to 0:
            G = R_t + gamma * G
            Q(S_t, A_t) = Q(S_t, A_t) + alpha * (G - Q(S_t, A_t))    #Average

def epsilon_greedy ():
    r = Random()
    if r < epsilon:
        return random legal action
    else:
        return maxArg_a (Q(s, a))
בזמן איסוף האפיזודה בוחרים פעולות באמצעות הטבלה הנוכחית. בסיומה מעדכנים את הערכים של הזוגות שביקרנו בהם, מהצעד האחרון לראשון, כי כך G מצטבר בקלות, בדיוק כמו בדוגמת האפיזודה שראינו. במשחק הבא כבר משתמשים בטבלה המעודכנת, ולכן המדיניות משתפרת מאפיזודה לאפיזודה, כמו ב־Policy Iteration, רק שכאן ״ההערכה״ היא משחק אחד ו״השיפור״ הוא הבחירה החמדנית מהטבלה. בפועל אין צורך לאתחל את הטבלה לכל המצבים מראש: בקוד, זוג שטרם נראה מקבל 0 בפעם הראשונה שפונים אליו.
השורה ״Generate an episode״ מסתירה בתוכה משחק שלם. הנה גם היא בפסאודו־קוד, באותו סגנון: מתחילים ממצב ההתחלה, וכל עוד המשחק לא הסתיים בוחרים פעולה ב־ε-greedy, מבצעים אותה בסביבה, ושומרים ברשימה את המצב, הפעולה והתגמול. הרשימה שמתקבלת היא האפיזודה שהלולאה שלמעלה עוברת עליה מהסוף להתחלה:
def Generate_episode():
    episode = []
    state = initial state
    while not end_of_game(state):
        action = epsilon_greedy(state)
        next_state, reward = environment(state, action)
        episode.append((state, action, reward))
        state = next_state
    return episode
שימו לב לשורה environment(state, action): במשחק מול יריב ״הסביבה״ כוללת גם את תגובת היריב. הצעד מתחיל במהלך שלנו ומסתיים כשמגיע שוב תורנו, או כשהמשחק נגמר, והתגמול שנשמר הוא של הצעד כולו: 1 אם ניצחנו במהלך שלנו, −1 אם היריב ניצח בתגובתו, ו־0 אחרת. next_state הוא הלוח שאחרי תגובת היריב, וממנו נבחר את הפעולה הבאה. עבור המשחק בן שלושת הצעדים שראינו קודם הרשימה תהיה [(S0, A0, 0), (S1, A1, 0), (S2, A2, 1)], ולולאת העדכון תעבור עליה מהצעד האחרון לראשון: G יהיה 1, אחר כך 0.95, אחר כך 0.9025, וכל זוג יתעדכן בהתאם.
בפרק הבא נממש את האלגוריתם על איקס עיגול. במשחק הזה יש לכל היותר 39 = 19,683 סידורי לוח, ובפועל פחות, ולכן טבלה מספיקה. נאמן סוכן שמשחק X, השחקן הראשון, מול סוכן אקראי, בממשק משחק שכבר נתון.