ד.10 — TD באיקס עיגול ו־AfterState
המצגת: TD באיקס עיגול · השיעור באתר הקורס · קוד: SARSA_Trainer.py · AI_Agent.py · ענף TicTacToe_SARSA במאגר Tic_Tac_Toe_2
בפרק הקודם למדנו את SARSA על נייר: מצב, פעולה, תגמול, מצב הבא, פעולה הבאה. בפרק הזה נחזור לאיקס עיגול ונשאל שאלה מעשית: איך נראה "צעד אחד" במשחק שבו יש יריב? בפרק ד.8 בנינו סוכן מונטה קרלו שמשחק אפיזודה שלמה ולומד רק בסופה. עכשיו נשנה דבר אחד בלבד: מועד העדכון. הסוכן ילמד תוך כדי המשחק, מכל מהלך.
הקושי המרכזי הוא שבמשחק מול יריב "הצעד הבא" אינו מיידי. באיקס עיגול, אחרי ש־X הניח סימן, הוא עדיין אינו יכול לבחור את המהלך הבא שלו: קודם צריך לראות מה יעשה O. נשתמש באותו ממשק משחק ובאותו סוכן AI_Agent מפרק ד.8, ונכתוב מאמן חדש, שמעדכן את טבלת Q במהלך המשחק. הקוד בפרק לקוח מענף TicTacToe_SARSA של מאגר המשחק.
בסוף הפרק נציג רעיון נוסף, AfterState, שמנצל את מה שאנחנו כן יודעים על המשחק: איננו יודעים מה היריב יעשה, אבל אנחנו יודעים בדיוק איך ייראה הלוח אחרי המהלך שלנו. נסביר את העיקרון בלבד; המימוש נשאר כתרגיל.
דגימת הסביבה — מעבר אחד במשחק מול יריב
במהלך האימון אנחנו דוגמים את הסביבה כדי לקבל את החמישייה S, A, R, S′, A′ ולהציב אותה בנוסחת העדכון של SARSA:
במשחק מול יריב, בין הפעולה שלנו לבין המצב שבו נבחר שוב מסתתר מהלך של O. לכן נחלק את הדגימה לחמישה שלבים:
- א. הסוכן מקבל מצב
stateובוחר פעולהAלפי ε-greedy. - ב. הסביבה מבצעת את הפעולה ומחזירה את הלוח שנוצר,
afterState, ותגמולR′. - ג. היריב מקבל את
afterStateובוחר את הפעולה שלו,afterAction. - ד. הסביבה מבצעת את פעולת היריב ומחזירה
nextStateותגמולR″. - ה. הסוכן מקבל את
nextStateובוחר את הפעולה הבאהA′לפי ε-greedy.
afterState הוא הלוח לפני תגובת היריב, ואילו nextState הוא הלוח שבו X עומד לבחור שוב. מנקודת המבט של הסוכן הלומד, היריב הוא חלק מהסביבה: "צעד אחד" של הסוכן כולל את המהלך שלו ואת התגובה של O.
אילו נתונים נכנסים לנוסחה? התשובה תלויה בשאלה אם הגענו למצב סופי, ובאיזה שלב. יש שלושה מקרים, ונעבור עליהם אחד אחד עם הלוחות מהמצגת.
המקרה הרגיל — המשחק לא מסתיים
נתחיל מלוח ריק. הסוכן X בוחר את המרכז, (1,1). הסביבה מבצעת ומחזירה afterState עם X אחד במרכז, והתגמול R′ הוא 0, כי המשחק לא הסתיים. היריב O בוחר את הפינה השמאלית התחתונה, (2,0). הסביבה מבצעת ומחזירה nextState עם שני סימנים, ושוב R″ = 0. עכשיו X מקבל את nextState ובוחר את הפעולה הבאה, למשל (2,2). היא נבחרה, אך עדיין לא בוצעה.
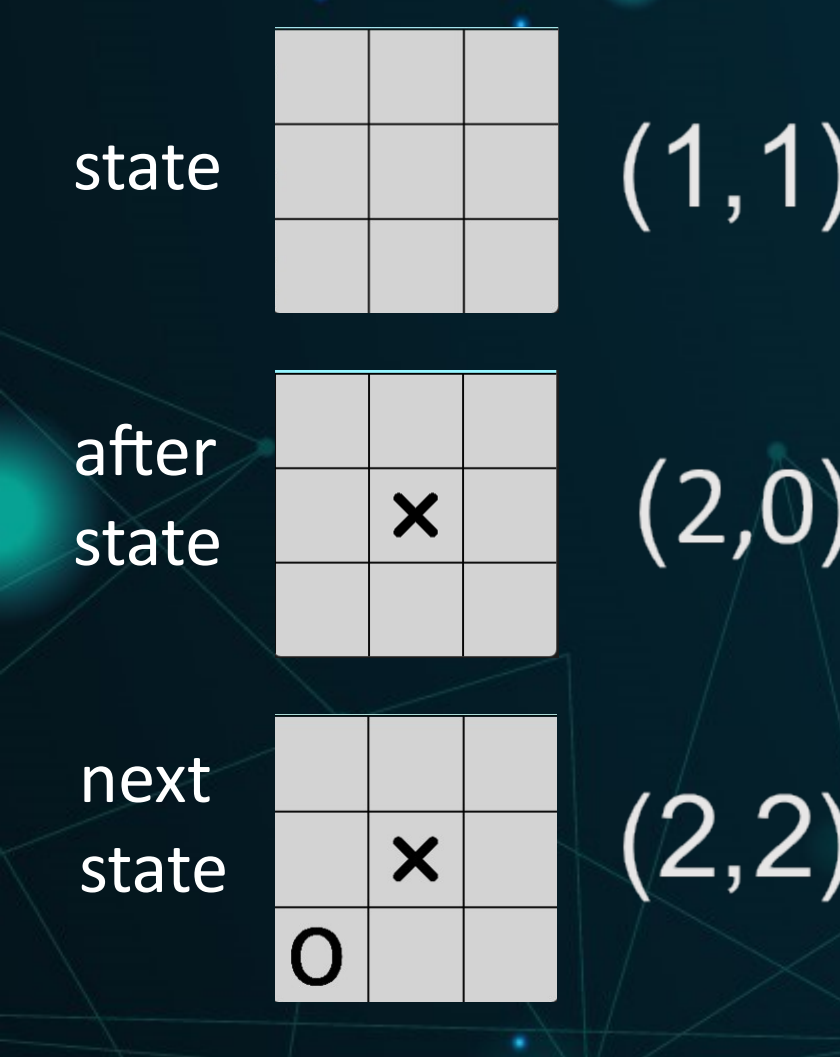
כל חמשת השלבים התבצעו, ויש בידינו את כל מה שהנוסחה צריכה:
שימו לב לשני דברים. ה־S′ של הנוסחה הוא nextState, הלוח אחרי תגובת היריב, ולא afterState: רק ב־nextState הסוכן חוזר ומחליט, ולכן רק לו יש ערך Q עם פעולה משלו. והתגמול הוא 0, כי באיקס עיגול יש תגמול רק בסיום המשחק; במקרה הרגיל היעד כולו מגיע מהערך המשוער של הצעד הבא, γ·Q(nextState, A′). אחרי העדכון ממשיכים: nextState הופך ל־state, ו־A′ הופכת ל־A, בדיוק כמו ההעברה S ← S′, A ← A′ בפסאודו־קוד.
מצב סופי בשלב ב׳ — המשחק מסתיים אחרי הפעולה שלנו
המקרה השני הוא סיום מיידי. במצב שבתמונה יש X במרכז ובפינה הימנית התחתונה, ו־O בשני התאים העליונים בעמודה הימנית. X בוחר את הפינה השמאלית העליונה, (0,0), ומשלים אלכסון. הסביבה מחזירה afterState שהוא כבר מצב סופי, ותגמול R′ = 1.
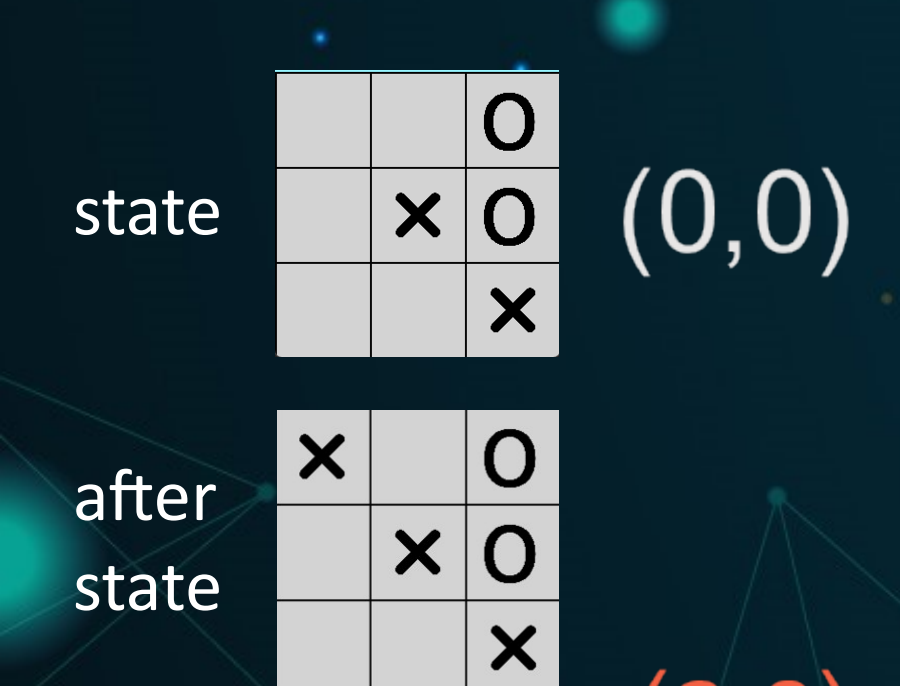
שלבים ג׳, ד׳ ו־ה׳ אינם מתבצעים. אין nextState ואין A′, ולכן חלק ההמשך בנוסחה הוא אפס:
היעד הוא התגמול בלבד, בדיוק כמו ענף המצב הסופי בפסאודו־קוד של הפרק הקודם: Q(state, (0,0)) ← Q + α·[1 − Q]. אותו טיפול מתאים גם לתיקו שמתקבל מיד אחרי המהלך של X, עם R′ = 0. אחרי העדכון האפיזודה מסתיימת.
מצב סופי בשלב ד׳ — המשחק מסתיים אחרי תגובת היריב
המקרה השלישי עדין יותר: הפעולה שלנו לא סיימה את המשחק, אבל היריב מנצח בתגובתו. במצב שבתמונה יש ל־X שני סימנים בשורה העליונה ול־O סימן בפינה הימנית העליונה ובמרכז. X בוחר את התא הימני באמצע, (1,2). הסביבה מחזירה afterState ו־R′ = 0, כי המשחק נמשך. עכשיו O בוחר את הפינה השמאלית התחתונה, (2,0), ומשלים אלכסון. הסביבה מבצעת ומחזירה nextState, שהוא מצב סופי, ותגמול R″ = −1.
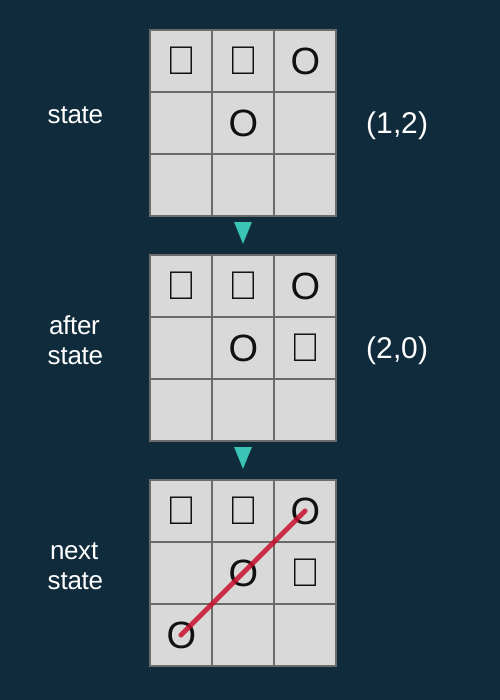
שלב ה׳ אינו מתבצע: אין פעולה לבחור במצב סופי. גם כאן חלק ההמשך הוא אפס, אבל התגמול שנכנס לנוסחה הוא R″, התגמול שהגיע מהמהלך של היריב:
הסימן נקבע מנקודת המבט של הסוכן הלומד, לא לפי מי שביצע את המהלך האחרון: ניצחון של O הוא −1 עבור X. כך הפעולה (1,2) תקבל ערך נמוך יותר, אף שהיא עצמה לא הפסידה: היא השאירה ליריב אפשרות לנצח, וזה בדיוק מה שהסוכן צריך ללמוד להימנע ממנו. הפעולה הנכונה במצב הזה הייתה לחסום ב־(2,0), ואחרי מספיק משחקים הערך של החסימה יהיה גבוה מהערך של (1,2).
קוד האימון — SARSA_Trainer.py
עכשיו נחבר את שלושת המקרים ללולאת אימון אחת. הקובץ SARSA_Trainer.py בענף TicTacToe_SARSA משתמש באותם רכיבים מפרק ד.8: TicTacToe, State, Random_Agent כיריב ו־AI_Agent כסוכן הלומד, עם get_action ב־ε-greedy ו־get_Q שמחזירה 0 לזוג שעדיין אינו בטבלה. הנה החלק הראשון של הקובץ, כלשונו (התיבה רחבה מהרגיל כדי ששורות העדכון הארוכות ייראו בשלמותן):
from TicTacToe import TicTacToe
from State import State
from Human_Agent import Human_Agent
from Random_Agent import Random_Agent
from AI_Agent import AI_Agent

PATH = 'Data/Q_SARSA_4.pth'
env = TicTacToe(State())

player1 = AI_Agent(1, env, graphics=None, Q_table_PATH=None)
Q = player1.Q
get_Q = player1.get_Q
gamma = 0.9
alpha = 0.1

player2 = Random_Agent(-1, env,graphics=None)

def main ():
    player = player1
    epochs = 100000

    for epoch in range(epochs):
        state = State()
        action = player1.get_action(state, epoch)   #using e-greedy
        while not env.end_of_game(state):
            afterState, reward = env.next_state(state, action)
            if env.end_of_game(afterState):
                Q[(state, action)] =  get_Q(state, action) + alpha * (reward + gamma * 0 - get_Q(state, action))
                # Q[(state, action)] = reward
                break
            afterAction = player2.get_action(state=afterState)
            next_state, reward = env.next_state(afterState, afterAction)
            if env.end_of_game(next_state):
                Q[(state, action)] =  get_Q(state, action) + alpha * (reward + gamma * 0 - get_Q(state, action))
                # Q[(state, action)] = reward
                break
            next_action = player1.get_action(next_state, epoch)   #using e-greedy
            Q[(state, action)] =  get_Q(state, action) + alpha * (reward + gamma * get_Q(next_state, next_action) - get_Q(state, action))
            state = next_state
            action = next_action

        print(epoch, end="\r")

    player1.save_Q(PATH)
    print(test(100))
נעבור על הלולאה הפנימית ונזהה את חמשת השלבים ואת שלושת המקרים:
- שלב א׳ נמצא לפני הלולאה:
action = player1.get_action(state, epoch)בוחר את הפעולה הראשונה של האפיזודה ב־ε-greedy, כמו בפסאודו־קוד של SARSA. - שלב ב׳:
afterState, reward = env.next_state(state, action)מבצע את הפעולה של X. אםafterStateהוא מצב סופי, זהו המקרה השני: מעדכנים לפי התגמול בלבד, עםgamma * 0שכתוב במפורש כדי להזכיר שאין המשך, ויוצאים מהלולאה ב־break. - שלבים ג׳ ו־ד׳:
afterAction = player2.get_action(state=afterState)הוא המהלך של היריב האקראי, ו־next_state, reward = env.next_state(afterState, afterAction)מבצע אותו. אםnext_stateהוא מצב סופי, זהו המקרה השלישי: התגמול הוא זה שהגיע ממהלך היריב, −1 בהפסד או 0 בתיקו, וגם כאן ההמשך אפס ו־break. - שלב ה׳ והמקרה הרגיל:
next_action = player1.get_action(next_state, epoch)בוחר את A′ ב־ε-greedy, והעדכון משתמש ב־get_Q(next_state, next_action). שתי השורות האחרונות,state = next_stateו־action = next_action, הן ההעברה S ← S′, A ← A′: הפעולה שנכנסה ליעד היא הפעולה שתבוצע בסיבוב הבא.
הפרמטרים הם gamma = 0.9, alpha = 0.1 ו־100,000 אפיזודות. בהשוואה למונטה קרלו בפרק ד.8, α גדול פי עשרה וחצי ממספר האפיזודות: כל צעד מעדכן את הטבלה, ולכן יש הרבה יותר עדכונים בכל משחק. בענף הזה epsilon_greedy של AI_Agent היא הדעיכה המעריכית, final + (start − final)·e^(−epoch/10000), ולא הלינארית של ענף הפתרון. היריב הוא Random_Agent הבסיסי.
שאר הקובץ, הפונקציות test ו־switch_players, זהה לזה של MC_Trainer.py בפרק ד.8: test(100) משחק 100 משחקים מול היריב האקראי ללא חקירה ומחזיר ניצחונות, הפסדים ותיקו:
def test (num):
    x_win = 0
    o_win = 0
    tie = 0
    player = player1
    player.train=False
    player.load_Q(PATH)
    for n in range(num):
        player = player1
        state = State()
        while not env.end_of_game(state):
            action = player.get_action(state=state)
            state, _ = env.next_state(state,action)
            player = switch_players(player)
        if state.end_of_game == 1:
            x_win +=1
        elif state.end_of_game == -1:
            o_win += 1
        else:
            tie +=1
        state.reset()
        print(n, end = "\r")
    return x_win, o_win, tie

def switch_players(player):
    if player == player1:
        return player2
    else:
        return player1

if __name__ == '__main__':
    main()
    # print(test(100))
הרצה ובדיקה
הפעילו את SARSA_Trainer.py. בטרמינל רץ מונה האפיזודות. האימון של 100,000 המשחקים אורך יותר מאימון מונטה קרלו, כארבע עד חמש דקות, כי בכל צעד בודקים סיום פעמיים ומעדכנים את הטבלה. בסיום הטבלה נשמרת לקובץ ומודפסת תוצאת test(100):
פלט
(99, 0, 1)
הסוכן ניצח 99 משחקים מתוך 100, סיים אחד בתיקו ולא הפסיד. Tester.py עושה את אותה בדיקה על 1,000 משחקים:
פלט
993 0 7
בטבלה נשמרו 6,848 זוגות של מצב ופעולה, לעומת כ־8,600 באימון מונטה קרלו מול אותו יריב: SARSA לומד מכל צעד, ולכן ε יורד מהר יותר והסוכן חוזר על אותם מסלולים טובים. הרצה חוזרת תיתן מספרים מעט שונים, כי המשחקים אקראיים. מה שחוזר בכל ההרצות הוא אפס הפסדים מול היריב האקראי.
הערה לגרסאות PyTorch חדשות. בענף הזה load_Q קוראת ל־torch.load(PATH) בלי פרמטרים. מגרסה 2.6 של PyTorch הטעינה נכשלת בשגיאת UnpicklingError, כי ברירת המחדל טוענת רק משקלים. התיקון הוא הקריאה torch.load(PATH, weights_only=False), כמו בענף הפתרון של פרק ד.8. האימון והשמירה עובדים כרגיל; רק test ו־Tester.py, שטוענים את הקובץ, זקוקים לתיקון.
אחרי האימון הריצו את Game.py: הוא טוען את הטבלה השמורה, הסוכן משחק X ואתם O.
AfterState — החלק של המודל שכבר ידוע לנו
עד כאן הסוכן שמר ערך לכל זוג של מצב ופעולה. נעצור לרגע ונשאל: למה בכלל היינו צריכים Q ולא V? התשובה, מהפרקים הקודמים, היא שאין לנו מודל של הסביבה: איננו יודעים לאיזה מצב תוביל כל פעולה. אבל באיקס עיגול זה נכון רק בחלקו. איננו יודעים מראש מה היריב יבחר, אבל כן יודעים מה תעשה הפעולה שלנו ללוח. במקרים שבהם חלק מהמודל ידוע לנו אפשר להתאים את האלגוריתם ולייעל אותו.
נחזור למעבר מהמקרה הרגיל: מהלוח הריק X בוחר את (1,1), והסביבה מחזירה afterState עם X במרכז. את הלוח הזה הסוכן יכול לחשב בעצמו, עוד לפני שהסביבה מבצעת את המהלך: זה הלוח הנוכחי ועוד הסימן שלו. הוא אינו המצב הבא, כי היריב עדיין לא הגיב, ולכן נכנה אותו afterState. הרעיון: במקום לשמור ערך לזוג (state, action), נשמור ערך ל־afterState שהזוג הזה יוצר, בטבלת V(afterState):
afterState הוא למעשה הזוג (state, action) בצורה אחרת: הלוח מספר גם מה היה המצב וגם איזו פעולה נבחרה. נוסחת העדכון של SARSA נכתבת אז על afterState:
כאן after_S הוא הלוח שנוצר מהפעולה שלנו במצב הנוכחי, ו־afterS′ הוא הלוח שייווצר מהפעולה הבאה A′ ב־nextState, אחרי תגובת היריב. זה הפרט העדין: afterS′ אינו nextState עצמו, אלא nextState ועוד הסימן של הפעולה הבאה.
למה טבלת AfterState יעילה יותר?
השימוש בטבלת afterState מונע כפילויות. ייתכן ששני זוגות שונים, (S,A) ו־(S′,A′), ייתנו את אותו afterState. בתמונה, במסלול הראשון X נמצא בפינה השמאלית העליונה ו־O במרכז, ו־X מוסיף סימן בימין השורה האמצעית. במסלול השני X כבר נמצא בימין השורה האמצעית ו־O במרכז, ו־X מוסיף סימן בפינה השמאלית העליונה. שני המסלולים מגיעים לאותו לוח:
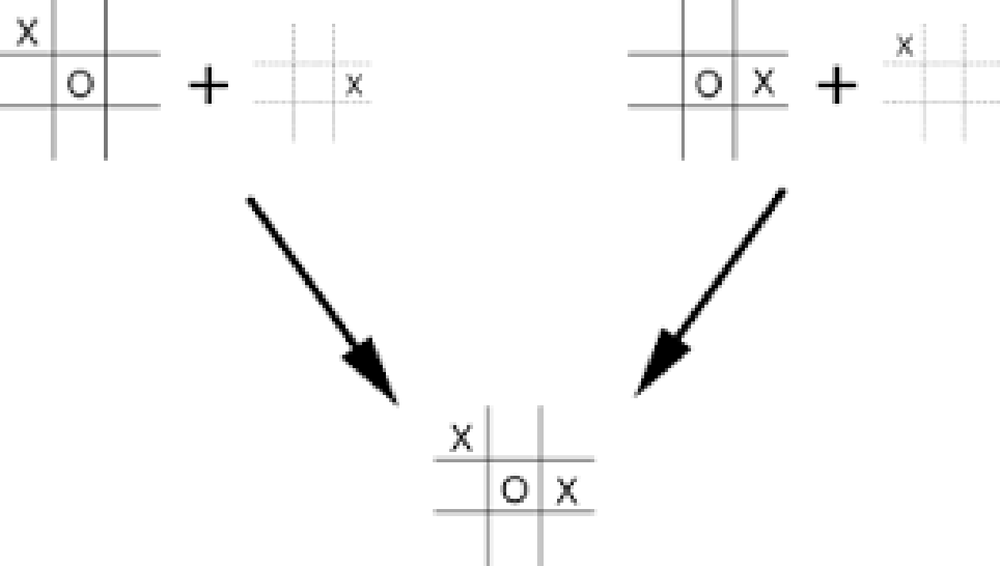
מה שיקרה מכאן והלאה תלוי רק בלוח שנוצר ובתור של O, ולא בדרך שבה הגענו אליו. לכן טבלת Q רגילה, ששומרת שני מפתחות שונים, לומדת פעמיים את אותו דבר, ואילו טבלת afterState שומרת רשומה אחת, וכל דגימה שמגיעה ללוח הזה, מכל אחת מהדרכים, מעדכנת אותה. הטבלה קטנה יותר, והערכים בה מתייצבים מהר יותר.
מה נדרש כדי לממש את זה? זו כבר טבלה אחרת, שהמפתח שלה הוא לוח ולא זוג של מצב ופעולה, ולכן צריך לשנות את הממשק של הסוכן: get_Q צריכה לחשב את afterState של כל פעולה מועמדת בעזרת env.next_state, בלי לבצע אותה במשחק, ולקרוא את הערך שלו; get_Q_action תבחר את הפעולה שה־afterState שלה הוא בעל הערך הגבוה ביותר; והעדכון בלולאת האימון יכתוב ל־V של afterState. בספר לא נממש את זה; זהו התרגיל האחרון של הפרק.
תרגילים
- ממשו את אלגוריתם Q-learning במשחק איקס עיגול. ההבדל היחיד מ־
SARSA_Trainer.pyהוא ביעד של המקרה הרגיל: במקוםget_Q(next_state, next_action)עם A′ שנבחרה ב־ε-greedy, השתמשו בערך המרבי מבין הפעולות החוקיות ב־next_state. שימו לב שאז אין צורך להעביר אתnext_actionלסיבוב הבא. - ממשו את אחד האלגוריתמים עבור השחקן O. חשבו מה משתנה בסדר השלבים כשהסוכן הלומד משחק שני, ומה הסימן של התגמול.
- ממשו את SARSA באמצעות טבלת afterState במקום טבלת Q. שימו לב: מהו afterS′ וכיצד יוצרים אותו.
עם זאת, גם עם טבלת afterState הסוכן עדיין שומר רשומה נפרדת לכל לוח שפגש. באיקס עיגול זה אפשרי; במשחקים גדולים יותר מספר המצבים עצום, ורובם לעולם לא ייפגשו פעמיים. בפרק הבא נחליף את הטבלה ברשת נוירונים שמעריכה את הערכים, וכך נוכל להכליל ממצבים שנראו למצבים חדשים.